A Northstar-kísérlet conversion_7d oszlopa egy ügyfélre
0 vagy 1 értékű kimenet. Ha egy jól körülhatárolt, homogén
részpopulációt vizsgálunk, akkor az egyes ügyfelek kimeneteit ugyanazzal
az ismeretlen
valószínűséggel generált Bernoulli-megfigyelésként modellezhetjük. A
teljes outcomes.csv-t nem szabad egyetlen
-vel
leírni, mert a kezdőlabor szerint a kezelés és a szegmens is módosítja a
konverziós valószínűséget; ezt a feltételt a becslés előtt pontosan ki
kell mondani.
Ebben az alfejezetben a bemenet egy rögzített, kézzel megadott 14 elemű minta:
A megfigyelési egység egy randomizált ügyfél egyetlen bináris kimenete, azaz . A keresett paraméter , amely ismeretlen, rögzített szám a intervallumban. A cél: adjunk pontbecslést -re rácskereséssel, numerikus optimalizálással és zárt képlettel, majd ellenőrizzük, hogy a három eredmény egyezik. A mintában darab 1-es és megfigyelés van, ezért az előzetes, még nem indokolt becslésünk .
Egy statisztikai modellben a paraméter (parameter) a sokaság egy ismeretlen, rögzített jellemzője. Itt a konverziós valószínűség, értékkészlete , mértékegysége nincs, mert valószínűség. A minta megfigyelése előtt az adatot véletlen változók alkotják: független, azonos Bernoulli-eloszlású (iid) változók. A megfigyelés után viszont már rögzített számok; a likelihood-szemléletben mindig ez utóbbi a kiindulópont.
A becslő (estimator) olyan függvény, amely a mintából számít egy értéket a paraméterre. A legtermészetesebb becslő az átlag:
A becslő még véletlen változó, mert a nagybetűs -k véletlenek. Amikor az aktuális mintát behelyettesítjük, a kapott számot becslésnek (estimate) nevezzük:
ahol a sikerek (1-esek) száma. Fontos megkülönböztetni a kettőt: a becslő mintavételi eloszlással és bizonytalansággal rendelkezik, a becslés egyetlen konkrét szám.
Egy gyors kézi kontroll: ha és , akkor és . Ez nem azt állítja, hogy pontosan , csak azt, hogy ezt a mintát a paraméter magyarázza a legjobban az itt következő kritérium szerint.
A likelihood-függvény (likelihood) azt méri, hogy egy adott paraméterérték mellett mennyire valószínű a ténylegesen megfigyelt minta. A valószínűségszámítási feltétel itt : az adat feltételes valószínűsége, ha az igazi paraméter. Iid Bernoulli-modellben:
A jelölések: a likelihood független változója, és pedig a rögzített mintából jövő konstansok. Az értéke egy hosszú, konkrét 0/1 sorozat előfordulási valószínűsége az adott mellett, tehát mértékegysége szintén nincs, értéke -beli. A szokásos valószínűséggel ellentétben itt nem az adat a változó, hanem a paraméter; a likelihood tehát a paraméter függvénye.
A log-likelihood (log-likelihood) a likelihood természetes logaritmusa:
értelmezési tartománya a nyílt intervallum; a széleken határértéket vizsgálunk. A logaritmus folytonos, szigorúan monoton növekvő függvény, ezért és ugyanott veszi fel a maximumát. A logaritmussal a szorzatból összeg lesz, ami kézzel és számítógéppel is stabilabb, mert sok kis valószínűség helyett mérsékelt negatív számokat adunk össze.
Kézi kontroll a fenti , példán: , míg . A nagyobb likelihoodot ad, mint a , ami egybevág a becsléssel. A log-likelihood értékek: , ; a nagyobb (kevésbé negatív) is ugyanarra a kedvezőbb pontra mutat.
A maximum likelihood becslés (maximum likelihood estimate, MLE) az a paraméterérték, amely maximalizálja a likelihood-függvényt:
Belső maximumot keresve deriváljuk a log-likelihood-ot a szerint. A Meredekség és numerikus derivált alfejezetben tanult egyváltozós deriválás szerint:
Ha , akkor a egyenlet megoldása:
Mivel , ez valóban maximum. A szélső eseteket külön kell kezelni: ha , akkor , amely szigorúan csökken a intervallumon, így a maximum -nál van; ha , akkor , és a maximum -nél van. Ilyenkor a deriválásos belső megoldás nem létezik, de a zárt alak akkor is jó, mert és .
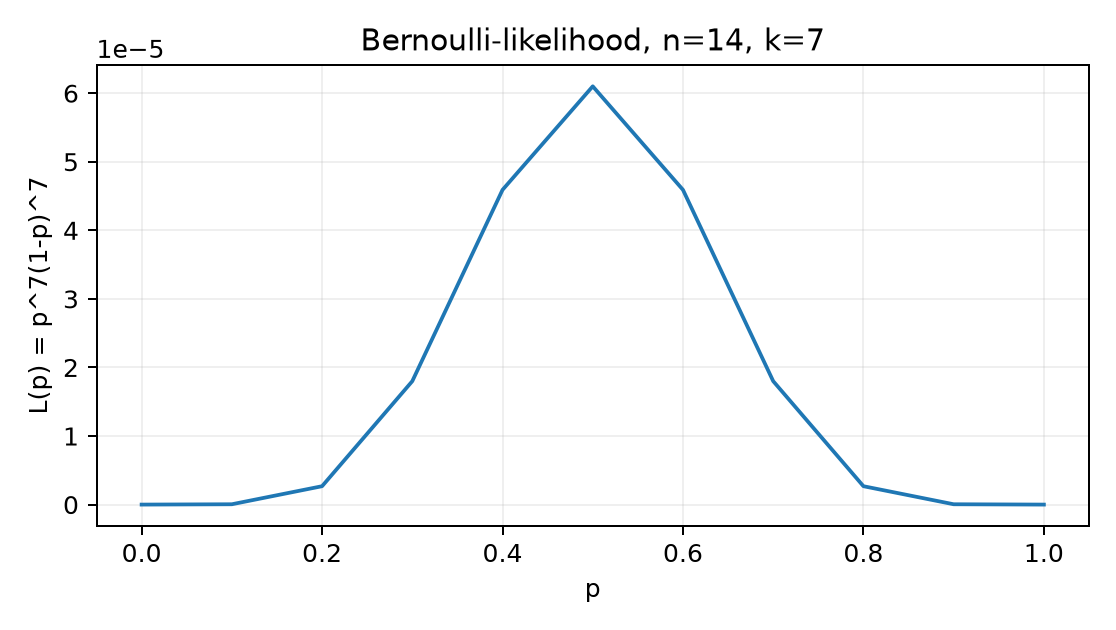
A likelihood-görbe alakját a hosszú minta , esetén az alábbi, képletből számított pontok mutatják:
A görbe szimmetrikus a körül, mert itt , és a maximum valóban -nél van.
A becslőt véletlen változóként vizsgálva két kulcsjellemzője van. A torzítás (bias) az átlagos eltérés a valódi paramétertől:
Itt az index jelzi, hogy a várható értéket a paraméter feltétele mellett számoljuk. Mivel , ezért a becslő torzítatlan bármely esetén.
A variancia (variance) azt méri, mennyire szór a becslő ismételt mintavétel esetén:
A standard hiba ennek gyöke, ahogy Nagy számok és centrális határeloszlás alfejezetben bevezettük: . A mi mintánknál mellett az elméleti standard hiba , azaz körülbelül 13 százalékpontos bizonytalanság – a minta kicsi, ezért az ML becslés sem “biztos”.
A torzítás és variancia nem mindig jár együtt javulva. Tekintsünk egy alternatív, zsugorított becslőt: . Ez a becslő már torzított lesz általában, mert , tehát . A varianciája viszont kisebb: . Például és mellett az MLE varianciája , míg a zsugorított becslőé ; cserébe torzítása . A becslőválasztás tehát tudatos kompromisszum lehet a torzítás és a variancia között, de az MLE torzítatlansága és egyszerű zárt alakja miatt jó kiindulópont.
Az alábbi szkript egyetlen rögzített mintán rácskeresést, zárt alakot
és scipy.optimize numerikus optimalizálást hasonlít össze.
A lista formátumú input miatt nincs seed- vagy platformfüggő
viselkedés.
# estimate_p.py
import numpy as np
from scipy.optimize import minimize_scalar
from scipy.stats import bernoulli
from scipy.special import beta as beta_function

x = np.array([0, 1, 1, 0, 0, 1, 0, 1, 1, 0, 1, 0, 0, 1], dtype=np.int64)
n = x.shape[0]
k = int(x.sum())
assert x.ndim == 1 and n == 14
assert np.isin(x, [0, 1]).all()

def log_likelihood(p, k, n):
    p_arr = np.atleast_1d(np.asarray(p, dtype=float))
    out = np.full(p_arr.shape, -np.inf)
    valid = (p_arr > 0) & (p_arr < 1)
    out[valid] = k * np.log(p_arr[valid]) + (n - k) * np.log1p(-p_arr[valid])
    if np.ndim(p) == 0:
        return float(out[0])
    return out

# Rácskeresés: a nyílt (0, 1) intervallumot finom rácson járjuk be.
p_grid = np.linspace(1e-6, 1 - 1e-6, 40_001)
ll_grid = log_likelihood(p_grid, k, n)

# Független ellenőrzés a scipy Bernoulli-pontosságával.
ll_scipy = bernoulli.logpmf(x[:, None], p=p_grid).sum(axis=0)
np.testing.assert_allclose(ll_grid, ll_scipy, rtol=1e-12, atol=1e-12)

mle_grid = p_grid[int(np.argmax(ll_grid))]
mle_closed = k / n

# Numerikus optimalizálás: minimalizáljuk a negatív log-likelihood-ot.
res = minimize_scalar(
    lambda p: -log_likelihood(p, k, n),
    bounds=(1e-8, 1 - 1e-8),
    method="bounded",
)
mle_opt = res.x

print(f"x shape={x.shape}, dtype={x.dtype}")
print(f"n={n}, k={k}")
print(f"MLE grid        = {mle_grid:.5f}")
print(f"MLE closed form = {mle_closed:.5f}")
print(f"MLE optimizer   = {mle_opt:.5f}")
print(f"loglik at MLE   = {log_likelihood(mle_closed, k, n):.6f}")
print(f"grid step       = {p_grid[1] - p_grid[0]:.6f}")
print(f"normalizing check B(k+1,n-k+1) = {beta_function(k + 1, n - k + 1):.6e}")
Futtatás a lab/ munkakönyvtárból, az Interpreter és virtuális környezet alfejezetben
beállított projektkörnyezettel:
uv run python estimate_p.pyA kimenet szemléltető, elméletileg várt értékekkel:
x shape=(14,), dtype=int64
n=14, k=7
MLE grid        = 0.50000
MLE closed form = 0.50000
MLE optimizer   = 0.50000
loglik at MLE   = -9.704061
grid step       = 0.000025
normalizing check B(k+1,n-k+1) = 1.943643e-05Kézzel is ellenőrizhető, hogy
,
esetén
.
A derivált
,
amely
-nél
nulla, tehát a maximum valóban
.
A likelihood-érték itt
,
a log-likelihood pedig
.
A rácskeresés lépésköze
,
tehát a rács eredményét ennyi toleranciával kell az elméleti értékhez
viszonyítani. A zárt képlet és a numerikus optimalizáló ugyanarra a
értékre jutott, így a feladat ellenőrzési feltétele teljesül. A
x tömb shape=(14,), dtype=int64,
az input pedig csak 0 és 1 elemeket tartalmazhat. A
normalizing check szám arra hívja fel a figyelmet, hogy
integrálja nem 1; erre a gyakori tévedés részben visszatérünk.
A likelihood nem a paraméter feltételes valószínűsége: rögzített adat mellett a paraméter függvényeként vizsgáljuk. A maximum likelihood becslés tulajdonságai (pl. konzisztencia) rendszerint szabályossági és azonosíthatósági feltételektől függenek.
1. Feladat (értelmezés). Legyen a minta , . Határozza meg -t, írja fel és konkrét alakját, adja meg az MLE-t, és számítsa ki, hogy vagy nagyobb-e. Ellenőrizze a választ a log-likelihood értékekkel is.
2. Feladat (megvalósítás). Írjon
mle_bernoulli(x, grid_size=20001) függvényt, amely 0/1
elemű, egydimenziós tömböt fogad, ellenőrzi az input ndim
és dtype=bool|int feltételét, rácskereséssel megbecsüli
-t,
és visszaadja az (estimate, max_loglik) párt. Futtassa az
x = np.array([1,0,1,1,0,0,0,1]) bemenetre, és indokolja a
kapott becslést.
3. Feladat (hibakeresés). Az alábbi kód hibásan akar MLE-t számolni:
x = np.array([1, 0, 1, 1, 0, 1], dtype=int)
k = x.sum(); n = x.size

def loglik_bad(p, k, n):
    return k * np.log(p) - (n - k) * np.log(p)

grid = np.linspace(0.0, 1.0, 101)
vals = loglik_bad(grid, k, n)
print("MLE=", grid[np.argmax(vals)])
Nevezze meg a három hibát, számítsa ki a helyes becslést, és írjon egy javított, stabil rácskeresést.
4. Feladat (megváltozott feltétel). Tegyük fel, hogy a minta megfigyelésből áll, és mindegyik 0: . Mi lesz a likelihood-függvény és a maximum likelihood becslés? Miért nem ad belső megoldást a egyenlet? Hogyan kell ezért a numerikus optimalizálásnál a határt kezelni?
Az 1. feladat megoldása. A mintában darab 1-es van, tehát . A likelihood:
, míg . Tehát . Log-skálán: és ; a nagyobb most is a -hez tartozik. Ez erősíti, hogy a megfigyelt arány a maximális likelihoodú paraméterérték.
A 2. feladat megoldása. A mintában , , ezért a zárt alak . Egy lehetséges megvalósítás:
def mle_bernoulli(x, grid_size=20001):
    x = np.asarray(x)
    assert x.ndim == 1
    assert np.isin(x, [0, 1]).all()
    n = x.size
    k = int(x.sum())
    grid = np.linspace(1e-8, 1 - 1e-8, grid_size)
    ll = k * np.log(grid) + (n - k) * np.log1p(-grid)
    idx = int(np.argmax(ll))
    return float(grid[idx]), float(ll[idx])

x = np.array([1, 0, 1, 1, 0, 0, 0, 1])
estimate, max_ll = mle_bernoulli(x)
print(estimate, max_ll)  # szemléltető: 0.5 -12.476...
A rács felbontása nagyságrendű, ezért a kimenetet célszerű legalább tűréssel kezelni. A log-likelihood a maximumban ; a kód eltérő rácshatárok miatt kissé más, de ugyanabba a tűrésbe eső értéket adhat.
A 3. feladat megoldása. A három hiba:
np.argmax a feltétel nélküli vektorban a legnagyobb
érvényes elemet választja, de a hibás formula és a határpontok miatt ez
a
lesz, mert ott a kifejezés 0, vagyis a legnagyobb a rossz
tartományban.A helyes számítás: , , tehát . Javított rács:
grid = np.linspace(1e-8, 1 - 1e-8, 20_001)
ll = 4 * np.log(grid) + 2 * np.log1p(-grid)
print(grid[np.argmax(ll)])  # 0.6667 körüli érték
A 4. feladat megoldása.
esetén
,
amely szigorúan fogy a
intervallumon, ezért a maximum
.
A log-likelihood
,
deriváltja
,
amely a nyílt
intervallumon mindig negatív, tehát sosem nulla. A belső deriváltas
megoldás ezért nem létezik. Numerikus minimalizáláskor az alsó határt ki
kell zárni vagy limitként kezelni: a minimize_scalar
például bounds=(1e-8, 1-1e-8) mellett az alsó határhoz
közel ad eredményt, de a pontos MLE a
határérték. Éppen ezért a gyakorlatban a szélső esetekre a zárt
képletet használjuk ellenőrzésként.
A likelihood nem a paraméter normalizált valószínűségi eloszlása, ha nincs prior. A -re vonatkozó eloszlásként értelmezve azt várnánk, hogy a görbe alatti terület 1 legyen, de az ábrán látott -hez nincs ilyen normálás. A , esetben
ahol a béta-függvény; ez nyilvánvalóan nem 1. A likelihood a megfigyelt adat együttes valószínűsége a paraméter függvényében, nem pedig a paraméter valószínűsége. Ha valaki értékét annak valószínűségeként értelmezné, hogy , az hamis állítást tenne; a paraméter itt rögzített, ismeretlen szám, nem véletlen. Bayes-frissítéssel lehet a likelihoodból paraméter-eloszlást csinálni, de ahhoz explicit prior kell; ez a későbbi Bayesi frissítés rácson témája. Ez közvetlenül visszautal az Esemény, feltételes valószínűség és Bayes feltételes valószínűségre: , és ez általában nem azonos értékkel.
scipy.stats.bernoulli.logpmf-fel történt
összehasonlítás
tűréssel egyezik.A paraméter rögzített, ismeretlen sokasági mennyiség; a becslő véletlen mintából számoló függvény, a becslés pedig az aktuális mintán kapott konkrét szám. A likelihood-függvény az adat feltételes valószínűségét a paraméter függvényében mutatja, és a maximum likelihood becslés az ezt maximalizáló paraméterérték. Bernoulli-mintán az MLE a mintabeli sikerarány, ; a log-likelihood a szorzatot stabil összeggé alakítja. A becslő torzítatlansága és varianciája mintavételi ismétlések alatt értelmezhető, és a kettő kompromisszuma becslőválasztási döntés. A rácskeresés, a zárt alak és a numerikus optimalizáló együttes ellenőrzése adja a következő lépés alapját, ahol a bizonytalanságot standard hibával és konfidenciaintervallummal számszerűsítjük Standard error és konfidenciaintervallum.