A Northstar kezdőlabor orders.csv adatában szeretnénk
megbecsülni egy rendelés basket_minor értékének sokasági
átlagát,
-t,
eurócentben. A megfigyelési egység egy rendelés; a minta
függetlenül kiválasztott rendelés. A sokasági szórás nem ismert, ezért a
mintából becsüljük. A feladat nem egyetlen pontbecslés: olyan
intervallumot kell adnunk, amelynek eljárása a névleges 95%-os
szinten lefedi az ismeretlen paramétert. Azt is ellenőriznünk kell, hogy
ez a lefedettség tényleg közel van-e a névleges szinthez, mert a
feltételek sérülésekor eltér.
Előzetes becslés: ha a sokaság közel normális, cent, és , akkor a t-intervallum félszélessége körülbelül cent. A tapasztalt lefedettség 1000 ismételt mintán 0,95 körül várható, Monte Carlo-standard hibája körülbelül 0,0069. A 0,93 alatti vagy 0,97 feletti eredmény kivizsgálandó, de önmagában nem bizonyítja a modellfeltevések sérülését: a szimuláció véletlen ingadozását is figyelembe kell venni.
A Paraméter, becslő és likelihood alfejezetben a becslő (estimator) olyan függvény, amely minden lehetséges mintához számot rendel, a becslés (estimate) pedig egy konkrét mintán kapott szám. Az átlagbecslő , ahol
Ha az -k függetlenek, azonos eloszlásúak, és , akkor az átlag szórásnégyzete
tehát az átlag standard error-ja, azaz a becslő mintavételi eloszlásának szórása
Ez még a sokasági -tól függ, ami gyakran ismeretlen. A mintabeli szórásnégyzet a korrigált, osztójú becslés:
és a becsült standard error
Fontos megkülönböztetni tehát a mintavételi eloszlás standard errorját (, elméleti mennyiség) és a becsült standard errort (, az adatból számolható mennyiség). Például ha és , akkor ; ha egy konkrét mintából , akkor .
A konfidenciaszint (confidence level) a névleges érték; a gyakori 95% esetén . A lefedettség (coverage) az eljárás tényleges tulajdonsága: ha nagyon sok, egymástól függetlenül vett mintán megismételjük az intervallumkészítést, a minták mekkora hányadában tartalmazza az intervallum a rögzített paramétert. A cél az, hogy a tapasztalt lefedettség közel legyen a névleges szinthez.
A normális sokaságon a klasszikus intervallum két változata:
A t-intervallum pontos lefedettségének feltétele: az -k függetlenek és azonos normális eloszlásúak. Ekkor a statisztika pontosan eloszlású, ezért minden -re a lefedettség pontosan . Ha a sokaság nem normális, de a szórása véges, a centrális határeloszlás miatt nagy -re a lefedettség közelít a névleges szinthez; a közelítés sebessége eloszlásfüggő, ferde eloszlásnál lassabb. A függetlenség sérülése (például ugyanazon ügyfél több rendelésének összekeverése) nem javítható pusztán nagyobb mintával.
Előbb kézi kontroll egy elemű mintán. Legyenek az értékek: , , , . Az átlag . A korrigált szórásnégyzet:
így , . A kvantilis 3.182, ezért a 95%-os intervallum:
azaz
.
Ugyanezt a géppel is kiszámoljuk, majd szimuláljuk a lefedettséget. A
reprodukálható futtatást a korábbi uv projekt és
ténylegesen rögzített függőségek szerint
uv run --locked biztosítja; a kódot
se_coverage.py néven mentjük a projektgyökérbe.
import numpy as np
from scipy.stats import t

rng = np.random.default_rng(20261020)

# 1) Kézi kis minta ellenőrzése
x = np.array([8.0, 11.0, 9.0, 12.0])
n = x.size
xbar = x.mean()
s = x.std(ddof=1)          # korrigált mintabeli szórás
se = s / np.sqrt(n)
crit = t.ppf(0.975, df=n - 1)
lo, hi = xbar - crit * se, xbar + crit * se
print(f"n={n}, mean={xbar:.3f}, s={s:.3f}, se={se:.3f}")
print(f"95% CI: [{lo:.3f}, {hi:.3f}]")

# 2) Lefedettség-szimuláció ismert parametrikus modellből
mu, sigma, reps = 5000.0, 800.0, 1000
for n in (10, 30, 100):
    rows = rng.normal(mu, sigma, size=(reps, n))   # shape (reps, n)
    means = rows.mean(axis=1)                      # shape (reps,)
    s_hat = rows.std(axis=1, ddof=1)               # shape (reps,)
    se_hat = s_hat / np.sqrt(n)
    crit = t.ppf(0.975, df=n - 1)
    lo = means - crit * se_hat
    hi = means + crit * se_hat
    coverage = np.mean((lo <= mu) & (hi >= mu))
    print(f"n={n:3d}: simulated t-CI coverage = {coverage:.3f}")
A kódblokk nem futtatott e szöveg írásakor; a közölt output szemléltető, elméletileg várt eredmény:
n=4, mean=10.000, s=1.826, se=0.913
95% CI: [7.094, 12.906]
n= 10: simulated t-CI coverage = 0.948
n= 30: simulated t-CI coverage = 0.952
n=100: simulated t-CI coverage = 0.949
A shape-ellenőrzés a kód szerződése: rows alakja
(reps, n), mert minden sor egy független minta; az
axis=1 szerinti összegzés átlaga means alakja
(reps,), és ugyanez igaz az s_hat,
se_hat, lo, hi vektorokra. A
(lo <= mu) & (hi >= mu) rész elemenkénti logikai
érték, amelynek átlaga a relatív gyakoriság. A Monte Carlo
lefedettségbecslő standard hibája a binomiális szórásból közelítőleg
ezért az 1000 ismétléses futásnál a 0.94–0.96 közötti érték
tekinthető a névleges 95%-kal egyezőnek. A seed (20261020)
a NumPy generátorát rögzíti, de ez nem garantál bitazonosságot eltérő
NumPy-verziók vagy platformok között.
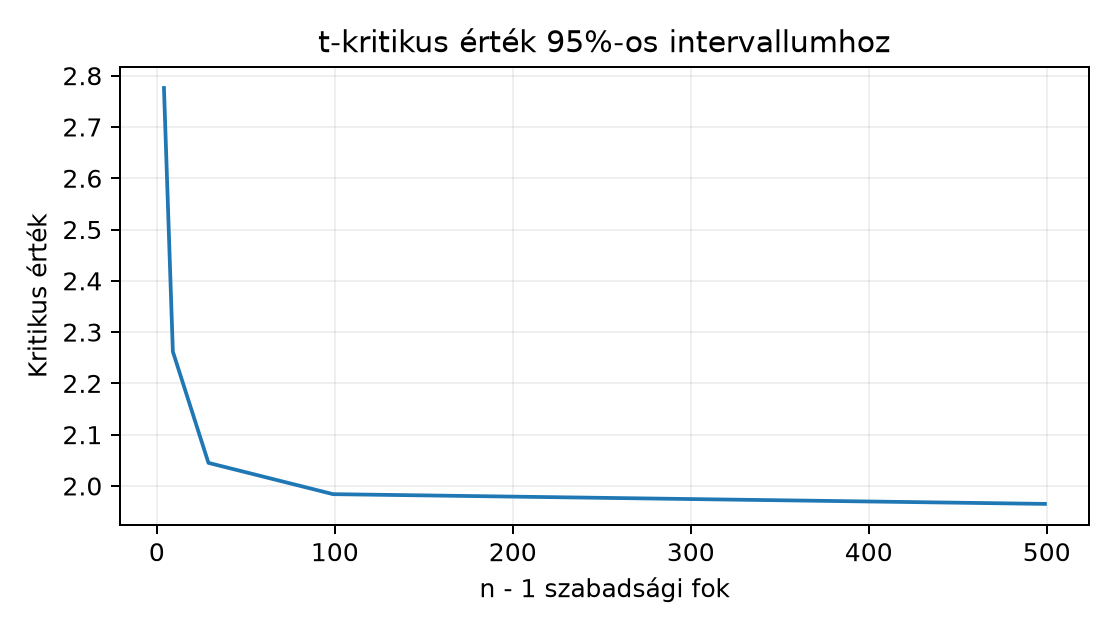
A t-kritikus érték és a normális kvantilis közötti különbséget egy
chart is mutatja; a pontok a scipy.stats.t
eloszlásfüggvényéből számított értékek, nem mérések.
Nagy szabadsági foknál a t-eloszlás a standard normálishoz tart, ezért a kritikus érték 1.96-hoz konvergál.
A kézi kontroll visszaadja a levezetett
intervallumot, tehát a ddof=1 és a
szabadsági fok együtt helyes. A szimulációban mindhárom mintanagyságnál
a lefedettség a Monte Carlo hibahatáron belül 0.95. Ez nem bizonyítja,
hogy az eljárás minden eloszlásra jó; csak azt, hogy ebben a normális
szimulációban a névleges szintet visszaadja. Ha a kimenet például 0.91
lenne, akkor valamelyik feltétel sérül, vagy a kódban van hiba, például
a nevezőben np.sqrt(n) helyett véletlenül n
szerepel.
Szimulációs lefedettségnél az elfogadási sávot a replikációszámtól függő Monte Carlo-hiba alapján válasszuk, ne utólag az eredményhez igazítsuk. A becsült standard error és a nominális konfidenciaszint külön mennyiség.
Értelmezés kézzel. Egy elemű minta: , egységekben: EUR-cent. Számold ki papíron az átlagot, a korrigált -et, a becsült standard errort és a 95%-os t-intervallumot. Ellenőrzéshez használd a értéket.
Implementálás szimulációval. Írj olyan
függvényt, amely adott mu, sigma,
n, reps paraméterekkel normális eloszlásból
generál mintákat, kiszámolja a 95%-os t-intervallumokat, és visszaadja a
lefedettséget. Futtasd mu=100, sigma=25, n=20, reps=2000
értékekkel, és add meg, mekkora Monte Carlo hibahatárt fogadsz el a 0.95
körül.
Hibadiagnózis. Egy kolléga a következő kódot
használja a lefedettség mérésére:
se = rows.std(axis=1) / np.sqrt(n) (a ddof=1
elhagyásával), majd crit = 1.96 minden n-re.
Kis mintán, például n=5 esetén mit várunk: a lefedettség
magasabb, alacsonyabb, vagy egyenlő lesz a 95%-kal? Indokold a két hiba
irányát külön-külön.
Megváltozott eloszlás. Ugyanaz a paraméter, mint
a minimális példában:
cent. Most a minták lognormális eloszlásból származnak:
rng.lognormal(mean=np.log(5000), sigma=0.5, size=(reps, n)).
Futtasd a szimulációt n=10 és n=200 esetén,
reps=2000 mellett. Milyen lefedettséget vársz kis és nagy
mintán, és miért térhet el a 95%-tól?
1. Az átlag:
A korrigált szórásnégyzet:
A tagok: , , , , ; összegük , tehát , . A becsült standard error . A kritikus értékkel:
azaz . Ellenőrzésképp a Python-kód ugyanezt adja; a tolerancia kerekítésből adódóan cent.
2. Egy lehetséges függvény:
def coverage_normal_t(mu, sigma, n, reps, seed=20261020):
    rng = np.random.default_rng(seed)
    rows = rng.normal(mu, sigma, size=(reps, n))
    means = rows.mean(axis=1)
    s_hat = rows.std(axis=1, ddof=1)
    se_hat = s_hat / np.sqrt(n)
    crit = t.ppf(0.975, df=n - 1)
    lo = means - crit * se_hat
    hi = means + crit * se_hat
    return np.mean((lo <= mu) & (hi >= mu))

coverage = coverage_normal_t(100, 25, 20, 2000)
print(f"coverage: {coverage:.3f}")
Szemléltető, nem e szöveg írásával futtatott eredmény:
coverage: 0.951. A Monte Carlo hiba
sqrt(0.95 * 0.05 / 2000) ≈ 0.0049, tehát a 0,945–0,955 sáv
csak körülbelül egy Monte Carlo-standard hibányi, nem megfelelő 95%-os
elfogadási tartomány. Közelítő 95%-os Monte Carlo-sáv: 0,95 ±
1,96·0,0049, azaz nagyjából 0,940–0,960. A 0,930-as eredmény indokolja a
kód, a generálás és a modellfeltevések ellenőrzését, illetve a
replikációszám növelését.
3. Két külön hiba van. Ha ddof=0 marad,
akkor a minta szórása lefelé torzít, mert a nevezőben
helyett
kell. A rows.std(axis=1) alapértelmezésben
osztójú, így a nevező
-nel
együtt nem a standard error torzítatlan változatát adja, hanem
-szeresét
annak. A becsült intervallum túl keskeny lesz, tehát a lefedettség
csökken. A
használata a
helyett ugyancsak túl keskeny intervallumot ad, mert kis
esetén a t-kvantilis nagyobb, például
-nél
a
-tal
szemben. A két hiba egy irányba hat: a lefedettség várhatóan 0.95 alá
esik,
-nél
akár 0.85 környékére is, mert az extra szórásbecslési bizonytalanságot
és a ferdeséget az intervallum nem kompenzálja.
4. A lognormális beállítás várható értéke
lenne, ezért a paraméter nem pontos, hacsak nem a móduszra gondolunk;
itt a szimuláció várható értéke kissé eltér a nominális 5000-től. Még ha
a paramétert helyesen is illesztenénk, a lognormális eloszlás erősen
jobbra ferde. Kis
esetén a centrális határeloszlás közelítése rossz; az átlag mintavételi
eloszlása még ferde, így a szimmetrikus t-intervallum lefedettsége 95%
alá esik, tipikusan 0.85–0.90 közé. Nagy
esetén a közelítés javul, a lefedettség már 0.93–0.95 lehet, de a
ferdeség miatt még nem garantált pontosan 95%. A diagnózishoz növeljük a
reps értéket, és számoljuk ki a Monte Carlo hibát is.
A leggyakoribb félreértés: „ez a konfidenciaintervallum 95% valószínűséggel tartalmazza a paramétert.” A klasszikus gyakorisági értelmezésben a paraméter rögzített, nem véletlen; ami véletlen, az a mintából számolt intervallum. Ha például a kézi mintából a 95%-os intervallum , és a valódi paraméter , akkor ez az intervallum tudottan lefedi a paramétert, tehát annak valószínűsége, hogy lefedi, itt nem 95%, hanem 1. Ha egy másik mintából adódott volna, akkor az nem tartalmazná a értéket, és ugyanígy nem mondhatnánk rá, hogy 95% eséllyel tartalmazza; konkrétan itt 0 lenne a lefedettség valószínűsége, nem 0.95. A 95% az eljárás ismételt mintavételi tulajdonsága: hosszú távon a minták 95%-ában fedi a paramétert. Ezért a „valószínűséggel van a paraméter az intervallumban” állításhoz Bayesi megközelítés és prior eloszlás kell, ami a Credible interval és posterior predictive check alfejezetben kerül majd elő. E különbség a gyakorlatban is fontos: egyetlen döntéshez soha ne úgy hivatkozzunk a CI-re, mintha az adott intervallum belső valószínűséget hordozna.
Ellenőrizd, hogy a kód ddof=1-et használ, a kritikus
érték df=n-1 szabadsági fokkal készül, és a szimuláció
mu-ja azonos a paraméterrel. Számold ki a Monte Carlo hiba
nagyságrendjét, és ne nevezz pontosnak olyan lefedettséget, amelyet nem
futtattál. A shape (reps, n) és a tengely szerinti
műveletek egyezzenek; a logikai vektor átlaga a relatív gyakoriság. Ha a
lefedettség 95%-tól távol esik, előbb a függetlenséget és az eloszlás
ferdeségét vizsgáld, mielőtt a módszert elvetnéd.
A standard error a becslő mintavételi szórása; az átlagé ismert mellett , ismeretlen szórásnál -nel becsüljük. A t-intervallum kritikus értéket használ, és független normális minta esetén pontosan a névleges szinten fed. A lefedettséget szimulációval mértük: 1000–2000 ismételt mintán a tapasztalt arány 0.95 körül várható, körülbelül 0,007 (1000 ismétlés) és 0,005 (2000 ismétlés) Monte Carlo-standard hibával. A konfidenciaszint az eljárás ismételt tulajdonsága, nem a konkrét intervallum valószínűsége. A következő alfejezetben a bootstrap használatát vizsgáljuk, amikor a normalitás vagy a szórás becslésének feltételei sérülhetnek.