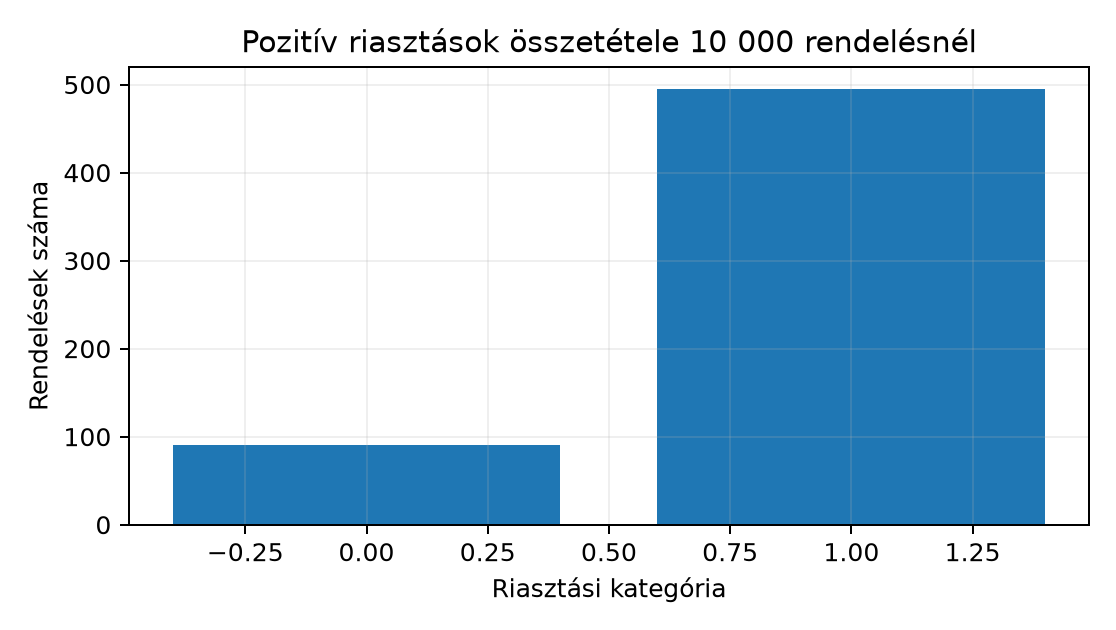
Egy logisztikai elemzőcsoport automatikus késésriasztó szabályt értékel. A megfigyelési egység egy leadott rendelés; a vizsgált 10 000 rendelés mindegyike pontosan egyszer szerepel. A döntéshozó a rendelés pillanatában látja a riasztást, a tényleges késés azonban csak később derül ki. Ezért a riasztó jele a predikció pillanatában ismert bemenet, a tényleges késés pedig a Kérdés, célváltozó és döntési helyzet alfejezetben megtanult értelemben utólag megfigyelt célváltozó. A bemeneti adat itt két bináris változó rendelésenként:
Az alábbi értékeléshez a valós késés alaparánya (base rate) 1%, tehát
a 10 000 rendelésből várhatóan 100 késik. A riasztó érzékenysége
(sensitivity) 90%: a valóban késő rendelések 90%-án jelez. A
specificitása (specificity) 95%: a nem késő rendelések 95%-án nem jelez,
tehát 5%-án tévesen riaszt. A kérdés: ha a rendszer pozitívan riaszt,
mekkora annak a feltételes valószínűsége, hogy a rendelés tényleg késni
fog? Előzetes becslésként sokan a 90%-ra tippelnek, mert a riasztó
érzékenysége 90%. A kézi táblázatból látni fogjuk, hogy a helyes válasz
ennél sokkal kisebb. A példa darabszámai tankönyvi paraméterek, nem a
lab/orders.csv fájlból számított mért statisztika.
Eseménytér (sample space). Egy kísérlet összes lehetséges kimenetének halmaza. Egy szabályos kockadobásnál ez . A rendeléses példában minden rendelés négy elemi kimenet egyikébe esik:
Az eseménytér teljes: minden rendelés pontosan egy cellában van.
Együttes valószínűség (joint probability). Két esemény együttes bekövetkezésének valószínűsége: . Darabszámokból:
ahol a metszetbe eső rendelések száma, az összes rendelés száma. A jelölések mindvégig: pozitív egész darabszám, a valószínűségek dimenziótlan számok 0 és 1 között. A példánk várható cellái:
| Cell | Sorösszeg | ||
|---|---|---|---|
| 90 | 495 | 585 | |
| 10 | 9405 | 9415 | |
| Oszlopösszeg | 100 | 9900 | 10 000 |
A darabszámok onnan jönnek: a 100 késés 90%-a, azaz 90 kap riasztást; a 9900 nem késés 5%-a, azaz 495 kap téves riasztást. Így az együttes gyakoriságok: ; .
Feltételes valószínűség (conditional probability). Az esemény valószínűségét egy másik, eseményre szűkített részsokaságon nézzük:
feltéve, hogy . A függőleges vonal mögötti esemény a feltétel: ez határozza meg a nevezőt. A példában , ez az érzékenység. A kérdésünk viszont a másik irány: . Ugyanaz a metszet, de más a feltétel, ezért más a nevező.
Függetlenség (independence). Az és események akkor függetlenek, ha
vagy ha , akkor ekvivalensen . Tehát a -re szűkítés nem változtatja esélyét. Ellenpélda egy szabályos kockánál: legyen = páros dobás, = 6-nál kisebb dobás. Ekkor , , de , míg , tehát a két esemény nem független. A riasztó példánkban és szándékosan nem függetlenek: a szabály éppen azért létezik, hogy a jel megváltoztassa a késésre vonatkozó bizonytalanságunkat.
Alapgyakoriság (base rate). Ez a feltétel nélküli, előzetes valószínűség: . A ritka eseményeknél ez a nevezőben megbúvó domináns tényező. A Hiány és anomália mint vizsgálati kérdés alfejezetben a feltételes hiányzási arányok hasonló logikával működtek: a feltétel megválasztása mindig a nevezőt jelöli ki.
Bayes-formula. A két irányú feltételes valószínűséget köti össze. Darabszámokból levezethető. Induljunk a definíciókból:
A nevező a teljes eseménytér felbontásából áll elő, mert minden pozitív riasztás vagy késő, vagy nem késő rendelésre esik:
Behelyettesítve:
Az utolsó lépés kézi törtekkel is követhető: , , a hányados , egyszerűsítve . A táblázat ugyanezt adja darabszámokból.
A példát a projektgyökérből futtatjuk, a
scripts/s053_bayes_screen.py fájlból. A kód a NumPy 2.x
default_rng interfészét használja; a
scipy.stats csomagot itt még nem hívjuk, mert a Véletlen változó és gyakori eloszlásmodellek
alfejezettől kezdjük majd az eloszlásmodelleket használni, most elegendő
a generátor és a darabszámos összegzés. A generálás rögzített seeddel
reprodukálható ugyanazon a NumPy-verzión; a PCG64 seed azonban nem
garantál bitazonosságot minden platformon és verziókombinációban.
# scripts/s053_bayes_screen.py
import numpy as np

rng = np.random.default_rng(20261020)
n = 10_000
prevalence = 0.01
sensitivity = 0.90
specificity = 0.95

# A valós késés bináris tömbje, shape (n,), dtype bool.
actual_late = rng.random(n) < prevalence

# A riasztó döntése: késés esetén sensitivity eséllyel,
# nem késés esetén (1 - specificity) eséllyel lesz pozitív.
positive_alert = np.where(
    actual_late,
    rng.random(n) < sensitivity,
    rng.random(n) < (1.0 - specificity),
)

tp = int(np.sum(actual_late & positive_alert))
fn = int(np.sum(actual_late & ~positive_alert))
fp = int(np.sum(~actual_late & positive_alert))
tn = int(np.sum(~actual_late & ~positive_alert))

print(f"TP={tp} FN={fn} FP={fp} TN={tn}")
print(f"P(alert)={ (tp + fp) / n:.5f}")
print(f"P(late given alert)={tp / (tp + fp):.5f}")

# Elméletileg várt darabszámok:
# TP=0.01*0.90*10000=90, FN=10, FP=0.99*0.05*10000=495, TN=9405
# Elméleti posterior: 90/(90+495)=2/13 ≈ 0.1538
A futtatási parancs Linux/macOS terminálban vagy Windows PowerShellben, munkakönyvtárnak a projektgyökeret választva:
uv run python scripts/s053_bayes_screen.pyA kód automatikusan még nem ellenőrzött, ezért pontos futási kimenetet nem közlünk. A kommentben szereplő értékek a paraméterekből levezetett elméletileg várt darabszámok. A tényleges szimuláció ettől néhány tucatnyi eltérést mutat, mert a seed véletlen mintát húz.
Az értelmezéshez a várható táblázatot használjuk, mert az nem függ a szimulációs zajtól. A kérdéses mennyiség:
A riasztásoknak tehát várhatóan csak mintegy 15,4%-a valódi késés; a maradék 84,6% téves riasztás. Ez nem mond ellent annak, hogy az érzékenység 90%. Az érzékenység a késő rendelésekre mint feltételre vonatkozik, a kérdésünk viszont a riasztásra mint feltételre. A két feltételes valószínűség iránya különbözik.
Az elméleti táblázat invariáns ellenőrzései:
A szimuláció tényleges becslése csak közelíti a -ot. Az eltérés oka a binomiális mintavételi zaj; ennek formális standard errorját a Nagy számok és centrális határeloszlás és Bootstrap a megfelelő mintavételi egységgel tárgyalja. A mostani példában a pontos konfidenciaintervallum helyett annyit mondunk ki: a fenti seeddel és paraméterekkel a posterior tipikusan 0,14 és 0,17 között mozog, de ez nem elméleti garantált intervallum. Ha a tanuló lokálisan lefuttatja, a saját mért száma a gép, a NumPy-verzió és a seed ismeretében írható ellenőrzött mérésként; a fenti kommentbeli érték nem ilyen.
A példa a Northstar predikciós szerződésével is összhangban áll: a riasztás a rendelés pillanatában ismert, a tényleges pedig a kézbesítés után. Az itt használt teljes 10 000 soros kiértékelés utólagos, retrospektív elemzés; éles használat előtt időbeli splitet és label-availability szűrést kell végezni az Adatéletciklus és a predikció pillanata és későbbi fejezetek szerint.
A pozitív prediktív érték a prevalenciától függ: a teszt szenzitivitását és specificitását változatlanul hagyva más populációban más posterior valószínűséget kapunk. A riasztási küszöböt a hibák költségeivel együtt kell értelmezni.
Értelmezés: magasabb alapgyakoriság. Ugyanaz a riasztó szabály egy sűrűbb időszakra kerül, ahol a késés alaparánya 5% a 10 000 rendelésen belül. Az érzékenység továbbra is 90%, a specificitás 95%. Töltse ki a négycellás táblázat várható darabszámait, és számítsa ki értékét. Hasonlítsa össze az 1%-os alapgyakoriságú eredménnyel, és magyarázza el, miért változott.
Implementálás: függvény a táblázatból. Írjon
posterior_from_counts(tp, fn, fp, tn) függvényt, amely a
négy cella abszolút darabszámából visszaadja
értékét. Ha a pozitív riasztások száma nulla, a függvény
float("nan") értéket adjon. Tesztelje az elvárt
táblázattal: posterior_from_counts(90, 10, 495, 9405)
értéke
legyen, és tesztelje az 1. feladat táblázatával is. Mit kell a tesztben
elfogadható lebegőpontos toleranciának tekinteni?
Hibakeresés. Egy notebook cellában a következő kód szerepel:
p_wrong = np.sum(actual_late) / np.sum(positive_alert)
print(p_wrong)
A szerző azt állítja, hogy ez becslése. Nevezze meg, mit számol valójában ez a hányados, és adja meg a helyes kódot. A várható táblázat alapján miért nem egyenlő a kettő?
1. feladat. A 10 000 rendelésből 500 késik, 9500 nem. A késők 90%-a, azaz 450 kap riasztást: , . A nem késők 5%-a kap téves riasztást: , . A pozitív riasztások száma , tehát
Ellenőrzés a sor- és oszlopösszegekkel: , , , , az összeg 10 000. Az 1%-os esethez képest a posterior 15,4%-ról 48,6%-ra nőtt, mert az alapgyakoriság ötszörösére emelésével a valódi pozitívok aránya a riasztásokon belül megnőtt: 90-ről 450-re, míg a hamis pozitívok csak kicsit csökkentek 495-ről 475-re. A ritka esemény kevésbé ritka lett, ezért a teszt pozitív eredménye erősebb bizonyítéknak bizonyult.
2. feladat. Egy lehetséges megoldás:
def posterior_from_counts(tp, fn, fp, tn):
    positive_count = tp + fp
    if positive_count == 0:
        return float("nan")
    return tp / positive_count
A teszt:
assert abs(posterior_from_counts(90, 10, 495, 9405) - 2/13) < 1e-12
assert abs(posterior_from_counts(450, 50, 475, 9025) - 18/37) < 1e-12
A tolerancia
elegendő, mert a hányados két Python-egész osztása, a lebegőpontos
kerekítés abszolút hibája ennél nagyságrendekkel kisebb; a
2/13 és a 18/37 is ugyanabban a
float-reprezentációban áll elő, mint a cellák hányadosa. Az ellenőrző
invariant: a négy bemenet nemnegatív egész, és a
positive_count = tp + fp kell hogy legyen a pozitív sor
összege; a függvény a tp / (tp + fp) arányt adja vissza. A
fn és tn paraméterekre nincs szükség, de a
szignatúrában hagyjuk őket, mert a teljes táblázat explicit kontroll, és
a jövőben a negatív prediktív értéket is ugyanebből számítjuk.
3. feladat. A hibás kód a és arányát számolja, ami a várható táblázatban . Ez nem , mert a számláló az összes késő rendelést tartalmazza, nem csak azokat, amelyekre a riasztó is jelzett. A képletében a számláló , a nevező . A helyes kód:
p_right = (
    np.sum(actual_late & positive_alert)
    / np.sum(positive_alert)
)
A különbség forrása a 10 hamis negatív: azok a rendelések késnek, de
a riasztó nem jelzett. A hibás számlálóban benne vannak, a nevezőben
viszont a pozitív riasztások szerepelnek, így a kettő hányadosa nem
feltételes arányt, hanem két különböző partíció méretének arányát adja.
Ha a pozitív riasztások száma nulla lenne, a helyes függvény
nan-t adna, a hibás változat pedig nullával osztana.
4. feladat. Az új specificitás mellett a hamis pozitív arány . A késők száma 100, ebből , . A nem késők száma 9900, ebből , . A pozitív riasztások száma , így
A korábbi 15,4%-ról 47,6%-ra nőtt a posterior. A hamis riasztások aránya a pozitív jelzéseken belül korábban , most . A javulás mechanizmusa: a nagy létszámú nem késő csoportban a téves riasztási arány 5%-ról 1%-ra csökkent, ezért a hamis pozitívok darabszáma 495-ről 99-re esett. Mivel a valódi pozitívok száma 90, a specificitás javításával a hamis pozitívok még mindig kissé többen vannak, de a riasztás már csaknem minden másodszor igaz. A ritka eseménynél a hamis pozitív csökkentése gyakran nagyobb hatással van a posteriorra, mint az érzékenység további növelése.
A leggyakoribb hiba a feltétel irányának megfordítása: aki a 90%-os érzékenységből kiindulva azt mondja, hogy pozitív riasztás esetén 90% a késés esélye, az értékét -ként olvassa. A táblázat ellenpéldája: a 585 pozitív riasztásból csak 90 igaz, azaz , miközben . Az irány felcserélése a feltétel nevezőjének felcserélését jelenti. Még erősebb ellenpélda: ha a riasztó mindig pozitívan jelezne, akkor , de egyszerűen az alapgyakoriság, 1% lenne.
A korábbi fejezetekkel a kapcsolat közvetlen. A Hiány és anomália mint vizsgálati kérdés alfejezetben a hiányzásjelző feltételes arányai ugyanilyen metszet/nevező logikával készültek: az feltétel jelölte ki a nevezőt. A Sokaság, minta és adatfelvételi folyamat alfejezetben a szelekciós torzítás is feltételes arányként írható le: a megfigyelt almintára vonatkozó eloszlás nem azonos a sokaság eloszlásával, ha a bekerülés mechanizmusa összefügg a vizsgált változóval. A Fájlok, útvonalak és projektgyökér projektgyökér-konvenciója miatt a fenti script a projektgyökérből futtatható, a relatív útvonalakat így egy helyen rögzítjük.
Önellenőrző kérdések:
A negatív riasztásra a példában , tehát 0,1%, nem 10%. Ez is a feltétel irányának és a nagy, nem késő csoportnak a következménye.
Az eseménytér a lehetséges kimenetek partíciója; az együttes gyakoriság a metszetbe eső darabszám osztva a teljes elemszámmal. A feltételes valószínűség ugyanezt a metszetet szűkebb nevezőre vetíti, ezért és általában különbözik. Bayes formulája a két irányt köti össze, és a nevezőt a feltétel szerinti teljes felbontásból állítja elő. A ritka késés példájában a 90%-os érzékenység ellenére a pozitív riasztás után csak 15,4% a valódi késés esélye, mert a nagy nem késő csoporton keletkező hamis pozitívok uralják a riasztásokat. A következő Véletlen változó és gyakori eloszlásmodellek ezeket az eseményeket véletlen változókká alakítja, és formálisan bevezeti a Bernoulli- meg binomiális eloszlást, amellyel a mostani szimuláció szórása is pontosan leírható.