Tegyük fel, hogy egy numerikus rutin forró ciklusát elemezzük. Az
a tömb mérete néhány ezer elem, így az előző alfejezet szerint a cache-találati arány
magas, a DRAM-elérés ritka. A mért futási idő mégis többszöröse annak,
amit az utasításszám és az órajel alapján naivan várnánk. A szűk
keresztmetszet — egy több utasítást egyszerre kibocsátó valós magon —
gyakran nem a memória, hanem egy szerkezeti tény: a ciklusmag minden
iterációja ugyanarra a regiszterre épül, és a pipeline nem tudja
átlapolni az egymásra váró műveleteket. Az alfejezet egyszerű modelljén
azt is látni fogjuk, mikor nem ez a szűk keresztmetszet.
Ez az alfejezet azt a mechanizmust bontja fel, amely az ilyen
lassulást okozza. Célunk, hogy az olvasó a s = s + a[i]
típusú kódot ne csak helyesnek, hanem ütemezhetőnek is
lássa, és meg tudja becsülni, mennyi ciklust veszít egy adott függőségi
minta. A modell, amit használunk, szándékosan egyszerű: egy sorrendi
(in-order), egyszeres kibocsátású, négyfokozatú pipeline. Nem ciklusra
pontos leírás egy konkrét ARM magról, hanem jelölt, didaktikus
modell, amelyre pontos ciklusszám-levezetés adható, és amelynek
korlátait külön jelöljük.
Pipeline (futószalag): a processzor azon szervezési elve, hogy az utasítás végrehajtását egymást követő, egyszerű lépésekre bontja, és a különböző utasítások különböző lépéseit egyidejűleg, átlapolva végzi.
A modellünkben négy fokozat van:
| Fokozat | Név | Mit tesz |
|---|---|---|
| F | fetch | a következő utasítás lehívása az utasítás-memóriából |
| D | decode | dekódolás, regiszterolvasás (operandusok betöltése) |
| E | execute | ALU-művelet, címgenerálás, elágazás-kiértékelés |
| W | writeback | az eredmény visszaírása a regiszterfájlba |
Miért gyorsít az átlapolás? Különbséget kell tennünk latency (késleltetés) és throughput (áteresztőképesség) között. Egyetlen utasítás négy ciklus alatt fut végig (latency = 4), de ha a fokozatok átlapolhatók, akkor a második utasítás már az első „E” fokozatában jár, amikor az első a „W” fokozatban. Stabil állapotban minden ciklusban befejeződik egy utasítás: throughput = 1 utasítás/ciklus. egymástól független utasításra az összes ciklusszám (a feltöltési és kiürítési ciklusokkal együtt), szemben a nem pipeline-olt -nel.
Adatfüggőségi akadály (data hazard): olyan helyzet, amikor egy utasítás operandusa olyan eredmény, amelyet egy korábbi, még a pipeline-ban lévő utasítás állít elő, és nincs olyan útvonal (pl. forwarding), amely az értéket időben eljuttatná a fogyasztóhoz. Ilyenkor a fogyasztó várakozási ciklust (stall) kap, és a pipeline-ba egy buborék (bubble) kerül.
A klasszikus besorolás szerint read-after-write (RAW, olvasás írás után) függőségről van szó: a fogyasztó olvasni akar, a termelő még nem írt. Sorrendi pipeline-ban write-after-write (WAW) és write-after-read (WAR) veszély nem lép fel, mert a kibocsátási sorrend megegyezik a program sorrendjével.
Modellfeltevések (jelölt, egyszerűsített):
Ez a modell nem ciklusra pontos leírás egy AArch64 magról: a valós Cortex-A magok hosszabb, többszörös kibocsátású, sorrenden kívüli (out-of-order) pipeline-nal és bonyolult forwarding-hálózattal rendelkeznek. Ciklusszám-levezetésre azonban pontosan használható.
Tekintsük ezt a két utasítást (A64 ISA):
ADD X1, X2, X3      // termelő: X1 előállítása
SUB X4, X1, X5      // fogyasztó: X1 azonnali felhasználása
Kiindulás: nincs forwarding.
A termelő ADD ciklusai:
| Ciklus | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| ADD | F | D | E | W |
Az X1 tényleges értéke a regiszterfájlban a 4.
ciklus végén jelenik meg, mert a W fokozat ekkor fejeződik
be.
A fogyasztó SUB ideálisan a 2. ciklusban kerülne F-be,
és a D fokozata a 3. ciklusban olvasná az X1-et. Ekkor
viszont a regiszterfájlban még a régi érték van. A fogyasztó D
fokozata csak azután olvashat, hogy a termelő W fokozata
befejeződött, azaz az 5. ciklusnál korábban nem.
Ezért a SUB D fokozata a 3. ciklus helyett az 5.
ciklusban indul. A köztes 3. és 4. ciklus a SUB számára
várakozási buborék. A SUB teljes
életciklusa:
| Ciklus | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|
| SUB | stall | stall | D | E | W |
A két utasítás összes ciklusszáma 7 (a buborékokkal), szemben a független eset 5 ciklusával: 2 stall ciklus.
Forwarding bevezetése. A forwarding (továbbítás,
bypass) lényege: az eredmény nem várja meg a W fokozatot, hanem a
termelő E fokozatának kimenetéről közvetlenül a fogyasztó E fokozatának
bemenetére kerül. Esetünkben a termelő E fokozata a 3. ciklusban
fejeződik be; a SUB E fokozata a 4. ciklusban kezdődik, így
az érték épp időben érkezik. A stall 2-ről 0-ra csökken
— feltéve, hogy a fogyasztó E fokozata legalább egy ciklussal a termelő
E után kezdődik. Ez pontosan teljesül a szomszédos ALU-utasításokra.
Load-use eset. A LDR X1, [X2] utasítás
adata a modell 3. feltevése szerint az E fokozat végén áll elő, vagyis a
modellben ugyanúgy továbbítható, mint egy ALU-eredmény: a szomszédos
fogyasztó nem kap várakozást. Ez a modell
egyszerűsítése. A valós magokban a betöltés eredménye általában később
érhető el, mint egy egyszerű ALU-művelet eredménye; a
load-to-use késleltetés azonban mikroarchitektúra-jellemző, nem
ISA-szabály, és magonként eltér. A modellből számolt ciklusszám ezért
egy konkrét gépre sem alsó korlát, csak a modell szerinti érték.
Ciklusvesztés általános képlete (jelölt modell). Időkonvenció: minden ciklusszám a megnevezett fokozat kezdő ciklusát jelöli, és egy fokozat a ciklusa végén fejeződik be. Legyen
Ekkor
Ha az eredmény az 5. ciklus elején érhető el, a fogyasztónak pedig a 4. ciklusban lenne rá szüksége, ciklust kell várni; ha az eredmény korábban kész, mint ahogy kell, a várakozás 0.
Ellenőrzés a fenti két esettel.
ADD W fokozata a 4. ciklus végén zárul,
így az X1 az 5. ciklus elején olvasható:
.
A SUB D fokozata várakozás nélkül a 3. ciklusban kezdődne:
.
A képlet szerint
stall — egyezik a táblázattal.ADD E fokozata a 3. ciklus végén zárul, az
eredmény a 4. ciklus elején továbbítható:
.
A SUB E fokozata várakozás nélkül a 4. ciklusban kezdődne:
.
A képlet
stallt ad.Munkakönyvtár: ~/arm-labor/a64/a050/ —
az alfejezet minden laborfájlja ide kerül, és minden parancs innen
futtatandó (a könyvtárrendet a Labor-alapkörnyezet alfejezet írja le).
mkdir -p ~/arm-labor/a64/a050
cd ~/arm-labor/a64/a050
A kiindulópont a következő C-függvény:
long sum_seq(const long *a, long n) {
    long s = 0;
    for (long i = 0; i < n; i++) s = s + a[i];
    return s;
}
Assemblyben két változatot írunk ugyanerre a számításra:
lab_sum1 egy akkumulátorral (az X0 lánc),
lab_sum2 kettővel (X0 és X5).
Mindkettő teljes, C-ből hívható függvény az AAPCS64 szerint
(X0 = a, X1 = n, eredmény
X0-ban). A lab-pipe-sum.s tartalma:
// lab-pipe-sum.s — A64 ISA, AArch64 Linux; GNU as.
// long lab_sum1(const long *a, long n);  egy akkumulátor (X0)
// long lab_sum2(const long *a, long n);  két akkumulátor (X0, X5)
// Levélfüggvények, keretet nem építenek, ezért CFI nélküliek (lásd a029).
    .text
    .p2align 2

    .global lab_sum1
    .type   lab_sum1, %function
lab_sum1:                           // belépéskor: X0 = a, X1 = n
    MOV  X4, X1                     // X4 = n
    MOV  X1, X0                     // X1 = a
    MOV  X0, #0                     // X0 = s
    MOV  X2, #0                     // X2 = i
    CMP  X2, X4
    B.GE 2f
1:  LDR  X3, [X1, X2, LSL #3]       // X3 = a[i]
    ADD  X0, X0, X3                 // s = s + X3
    ADD  X2, X2, #1                 // i++
    CMP  X2, X4
    B.LT 1b
2:  RET
    .size   lab_sum1, .-lab_sum1

    .global lab_sum2
    .type   lab_sum2, %function
lab_sum2:                           // belépéskor: X0 = a, X1 = n
    MOV  X4, X1
    MOV  X1, X0
    MOV  X0, #0                     // 1. akkumulátor
    MOV  X5, #0                     // 2. akkumulátor
    MOV  X2, #0
    CMP  X4, #0
    B.LE 4f
1:  ADD  X7, X2, #1
    CMP  X7, X4
    B.GE 2f
    LDR  X3, [X1, X2, LSL #3]
    LDR  X6, [X1, X7, LSL #3]
    ADD  X0, X0, X3
    ADD  X5, X5, X6
    ADD  X2, X2, #2
    B    1b
2:  CMP  X2, X4                     // páratlan n: egy elem maradt
    B.GE 3f
    LDR  X3, [X1, X2, LSL #3]
    ADD  X0, X0, X3
3:  ADD  X0, X0, X5
4:  RET
    .size   lab_sum2, .-lab_sum2

    .section .note.GNU-stack,"",%progbits
A lab_sum1 ciklusában az ADD X0, X0, X3
minden iterációban ugyanarra az X0-ra épül: az előző
iteráció eredményét használja. Ez egy cikluson átívelő függőség
(loop-carried dependency). A lab_sum2 két
független láncot vezet: az ADD X0 és az ADD X5
egyike sem várja a másik eredményét.
Ciklusonkénti levezetés a jelölt modellen. A modellben az utasítások sorrendben, ciklusonként egyesével lépnek be, és — a feltevések szerint — az elágazásnak nincs külön költsége. Várakozás nélkül egy végrehajtott utasításból álló futás ciklus (a +3 a pipeline feltöltése). Meg kell tehát nézni, hol keletkezik várakozás:
Függőség a lab_sum1 ciklusában |
Távolság (utasítás) | Stall | |
|---|---|---|---|
LDR X3 → ADD X0, X0, X3 |
1 | 0 | 0 |
ADD X2 → CMP X2, X4 |
1 | 0 | 0 |
CMP → B.LT (NZCV) |
1 | 0 | 0 |
ADD X0 → következő iteráció ADD X0 |
5 | negatív | 0 |
Forwarding mellett a szomszédos függőség sem okoz várakozást, a lánc
két tagja között pedig öt utasítás van. A lab_sum2-ben
ugyanez a helyzet (ADD X7 → CMP X7: 0;
LDR X6 → ADD X5: 0). Ebben a modellben
tehát egyik változatban sincs stall, és a ciklusszám a
végrehajtott utasítások számából adódik.
esetén:
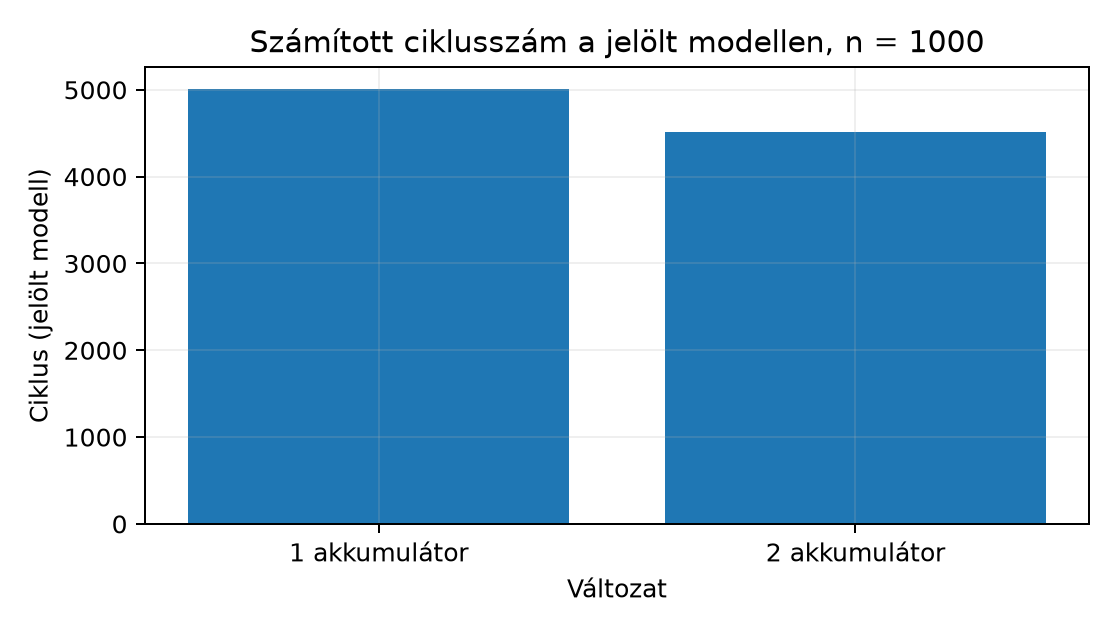
| Változat | Végrehajtott utasítás | Ciklus a modellben | Ciklus / elem |
|---|---|---|---|
lab_sum1: 6 belépő + 1000 × 5 + RET |
5007 | 5010 | ≈ 5,0 |
lab_sum2: 7 belépő + 500 × 9 + 3 kilépő + 2 farok + 1
összevonás + RET |
4514 | 4517 | ≈ 4,5 |
A különbség (kb. 10%) nem a függőségi lánc
megtöréséből származik — a modellben a lánc nem okozott
várakozást —, hanem abból, hogy a lab_sum2 két elemre 9, a
lab_sum1 két elemre 10 utasítást hajt végre: a
ciklusvezérlés aránya kisebb. Az utasításszámokat a laborban az
emulátorral is megszámoltuk (lásd a Források szakaszt).
Mikor számít a függőségi lánc? A lánc akkor válik szűk keresztmetszetté, ha a lánc egy körének késleltetése nagyobb, mint amennyi idő alatt a gép a ciklus többi utasítását amúgy is végrehajtaná. Egyszeres kibocsátású gépen, utasításos ciklusmaggal és ciklus késleltetésű láncművelettel a modell szerint:
A fenti modellben
(továbbított ADD) és
,
ezért a lánc nem számít. Valós, többszörös kibocsátású
(és gyakran sorrenden kívüli) magon a
utasítás egy ciklusnál jóval rövidebb idő alatt is végrehajtódhat, a
hosszabb késleltetésű láncműveletek (például lebegőpontos összeadás)
pedig több ciklust igényelnek — ilyenkor a lánc dönt, és több
akkumulátor valóban gyorsít. Hogy egy adott magon mennyit, azt ez a
modell nem mondja meg: valós ciklusszámhoz egy megnevezett, fizikai
AArch64 processzoron végzett mérés kell (lásd Mikrobenchmark készítése és eredmények
értelmezése).
1. Csak objektummá fordítás — a ciklusmag statikus vizsgálatához elég az assembly-fájl:
# Target: AArch64 Linux; csak összeállítás és visszafejtés, futtatás nélkül.
aarch64-linux-gnu-as -o lab-pipe-sum.o lab-pipe-sum.s
aarch64-linux-gnu-objdump -d lab-pipe-sum.o
2. A teljes labor — a futtatáshoz teszthajtó is
kell, amely a két változatot egy C-referenciával veti össze, a farokágat
is lefedő
értékekre. A lab-pipe-main.c tartalma:
/* lab-pipe-main.c — teszthajtó a lab-pipe-sum.s két függvényéhez. */
#include <stdio.h>

long lab_sum1(const long *a, long n);
long lab_sum2(const long *a, long n);

/* C-referencia; az elemek kicsik, előjeles túlcsordulás nem fordul elő. */
static long lab_sum_ref(const long *a, long n)
{
    long s = 0;
    for (long i = 0; i < n; i++) s = s + a[i];
    return s;
}

int main(void)
{
    static long a[1001];
    static const long ns[] = { 0, 1, 2, 3, 999, 1000, 1001 };
    int ok = 1;

    for (long i = 0; i < 1001; i++) a[i] = (i % 7) - 3;   /* -3..3 */

    for (unsigned k = 0; k < sizeof ns / sizeof ns[0]; k++) {
        long n = ns[k];
        long r = lab_sum_ref(a, n), s1 = lab_sum1(a, n), s2 = lab_sum2(a, n);
        int good = (s1 == r) && (s2 == r);
        printf("n=%4ld ref=%4ld sum1=%4ld sum2=%4ld %s\n",
               n, r, s1, s2, good ? "OK" : "HIBA");
        ok &= good;
    }
    return ok ? 0 : 1;
}
# Target: AArch64 Linux, qemu-user. Tiszta könyvtárban, a két fenti fájlból.
aarch64-linux-gnu-gcc -std=c17 -O2 -Wall -Wextra -static \
lab-pipe-main.c lab-pipe-sum.s -o lab-pipe
qemu-aarch64 ./lab-pipe ; echo "exit=$?"Várt kimenet:
n=   0 ref=   0 sum1=   0 sum2=   0 OK
n=   1 ref=  -3 sum1=  -3 sum2=  -3 OK
n=   2 ref=  -5 sum1=  -5 sum2=  -5 OK
n=   3 ref=  -6 sum1=  -6 sum2=  -6 OK
n= 999 ref=  -5 sum1=  -5 sum2=  -5 OK
n=1000 ref=  -3 sum1=  -3 sum2=  -3 OK
n=1001 ref=   0 sum1=   0 sum2=   0 OK
exit=0
A program a helyességet ellenőrzi; ciklusszámot nem mér, és a QEMU futási idejéből sem olvasható ki ciklusszám.
QEMU-korlát. A qemu-aarch64 user-mode
emulátor (és a qemu-system-aarch64 is) nem ciklusra
pontos: utasítás-szintű dinamikus fordítást (TCG) végez, és nem
modellezi a valós pipeline hosszát, a forwarding-késleltetést vagy a
kibocsátási korlátokat. Az itt megadott ciklusszámok a jelölt
modellből számított értékek; a QEMU-ból csak az
utasítás-viselkedés és a helyesség ellenőrizhető, relatív időmérésre is
csak nagyon fenntartással. Valós ciklusszámhoz fizikai AArch64 host és
pl. hardveres teljesítményszámláló szükséges (lásd Mikrobenchmark készítése és eredmények
értelmezése).
Hiba 1: a QEMU futási időből ciklusszámra
következtetni. Tünet: két implementáció
time-különbsége nem korrelál a levezetett ciklusszámmal.
Hipózis: QEMU TCG nem pipeline-modellez. Adatgyűjtés:
qemu-aarch64 -d in_asm és objdump -d
összehasonlítás. Egy változtatás: hardver nélkül csak az utasításszám és
a statikus elemzés marad; mérés fizikai hostra tolása.
Hiba 2: a modell várakozásmentességét valós gépre
átvinni. A jelölt modellben a továbbított load-use és
ALU-függőség 0 stallt ad. Valós magon a load-to-use késleltetés
általában nagyobb, és mikroarchitektúrától függ — nem ISA-szabály, ezért
egy konkrét számot sem lehet „kötelezőnek” tekinteni. Ellenpróba:
fizikai gépen mérjük ugyanazt a ciklust úgy is, hogy az LDR
és a fogyasztó közé független utasítást teszünk; ha az idő csökken, a
betöltés késleltetése számított.
Hiba 3: az utasításszámot a ciklusszámmal azonosítani. Ha egy ciklusmag 8 utasítás, az nem jelenti azt, hogy 8 ciklus/iteráció: ha van benne 1 cikluson átívelő lánc, a mag hosszabb lehet, mint az utasításszám.
Hiba 4: a fordító optimalizálására hagyatkozni
vakon. A -O2/-O3 sokszor megtöri a
függőségeket, de nem garantált; az objdump -d megmutatja a
tényleges ütemezést. Ellenpróba: a kódot -O0-val és
-O3-mal is disassemblálni és a ciklusmag utasításlistáját
összevetni.
Hiba 5: az utasítás-átrendezést (instruction scheduling) összekeverni a program-szemantika megváltoztatásával. Az ütemezés csak olyan utasításokat cserélhet fel, amelyek között nincs adat- vagy vezérlési függőség. Az átrendezés ötlete fogalmi szinten: a termelő és a fogyasztó közé független utasításokat ékelünk, hogy a stall „hasznos” munkával teljen. Ellenpróba: a cserélt utasítások operandushalmazainak metszetét ellenőrizzük.
1. feladat (magyarázó, alapszint — cél: megértés-ellenőrzés). Rajzolja fel az alábbi utasítássor pipeline-diagramját a jelölt modellben (nincs forwarding), és adja meg az összes ciklusszámot:
MUL  X1, X2, X3
ADD  X4, X1, X5
ADD  X6, X4, X5
Hány stall ciklus keletkezik, ha forwarding elérhető?
2. feladat (implementációs, középszint — cél:
rutinépítés). Írjon A64 assembly-t egy
int64_t dot_product(const int32_t *a, const int32_t *b, int n)
függvényre, amely 64 bites szorzatok összegét adja vissza. Feltétel: az
összeg elfér int64_t-ban; n <= 0 esetén az
eredmény nulla. Azonosítsa a ciklusmag függőségi láncait, majd alakítsa
át két párhuzamos akkumulátorra. Adja meg a módosítás előtti és utáni
várható ciklus/iterációt a jelölt modellen, és indokolja a
különbséget.
3. feladat (hibakeresési/mérési, középszint — cél:
rutinépítés). Fordítsa le a kidolgozott példa
sum_seq-ét -O0 és -O2 szinten.
objdump -d-vel hasonlítsa össze a generált
ciklusmag-utasításokat. Mutassa meg, hol töri meg a fordító a függőségi
láncot, és hol nem. Magyarázza meg, miért nem
elfogadható a QEMU futási idejéből ciklusszámra következtetni, és
nevezze meg, milyen mérési módszer adna hiteles adatot.
1. megoldás — Segítség. Rajzold fel mindhárom
utasítás F/D/E/W négyzetrácsát ciklusonként; a D fokozat
csak akkor indulhat, ha a termelő W fokozata már lezárult
(forwarding nélkül) vagy E fokozata lezárult (forwarding
mellett).
1. megoldás — Teljes megoldás. Nincs forwarding:
MUL W-je a 4. ciklus végén zárul, ADD X4 D-je
csak az 5. ciklusban indulhat → 2 stall; a fogyasztó ADD X6
ugyanígy 2 stallt kap az előző ADD X4-hez képest. Teljes
ciklusszám:
ciklus. Forwarding mellett az ALU→ALU láncokon a stall 0-ra csökken, így
az összes ciklusszám
(független esettel azonos).
2. megoldás — Segítség. A legbelső
LDR→MUL→ADD lánc egyetlen akkumulátorral (X0)
cikluson átívelő láncot alkot — hogyan lehet két független
X0/X8-szerű akkumulátort bevezetni, hasonlóan
a fejezet sum_seq kétakkumulátoros átalakításához?
2. megoldás — Teljes megoldás. Egy akkumulátoros változat:
        // x0=0, x1=a, x2=b, x3=0, x4=n
        // a és b: int32_t; az összeg int64_t, túlcsordulás nélkül
        CMP   X3, X4
        B.GE  dot_done
loop:
        LDRSW X5, [X1, X3, LSL #2]
        LDRSW X6, [X2, X3, LSL #2]
        MUL   X7, X5, X6
        ADD   X0, X0, X7
        ADD   X3, X3, #1
        CMP   X3, X4
        B.LT  loop
dot_done:
A függőségi lánc: ADD X0 → ADD X0 iterációkon át,
valamint LDR → MUL → ADD a magon belül. Két akkumulátorral
az ADD X0 és az ADD X8 független lesz, és a
MUL is kettéválik. A jelölt modellben
(egyszeres kibocsátás, 1 ciklusos továbbított műveletek) a lánc így sem
okozott várakozást, mert két ADD X0 között 7 utasítás van;
a nyereség itt is csak a ciklusvezérlés kisebb arányából jön. Számold
meg a kétakkumulátoros változat elemenkénti utasításszámát, és ebből add
meg a modell szerinti ciklus/elem értéket. A lánc megtörése akkor
számít, ha a láncművelet késleltetése meghaladja a ciklus többi
munkájának idejét — például többszörös kibocsátású magon vagy hosszú
késleltetésű szorzásnál —, de ezt csak mérés dönti el.
3. megoldás — Segítség. Gondold át, mit kell
garantálnia az -O0-nak (minden változó bármikor
megfigyelhető legyen) — ez miért kényszerít ki extra load/store láncot
az akkumulátor körül, amit -O2 elkerülhet?
3. megoldás — Teljes megoldás. -O0
mellett a fordító gyakran minden iterációban kiírja/beolvassa az
s-t a verembe, ami extra load/store láncot ad és rontja az
ütemezést. -O2 mellett s regiszterben marad,
és a fordító néha maga is unroll-ol és több akkumulátort vezet be. A
lánc nem mindig törik meg: a -O2 is
hagyhat szigorúan sorrendi ADD-sorozatot. A QEMU futási
ideje TCG-alapú, nem pipeline-modellező, ezért relatív ciklusszámra
alkalmatlan; hiteles adathoz fizikai AArch64 host és hardveres
PMU-számláló (pl. perf stat cycles eseménnyel)
szükséges, és ott is jelölni kell a QEMU-tól eltérő futási
feltételeket.
A pipeline átlapolással növeli az áteresztőképességet: egy négyfokozatú modellben a latency 4 ciklus marad, de a throughput elérheti az 1 utasítás/ciklust. Az adatfüggőségi akadály (RAW) akkor keletkezik, ha a fogyasztó a termelő eredményét a rendelkezésre állás előtt akarja olvasni: a jelölt modellben forwarding nélkül 2 stall, forwarding mellett ALU→ALU esetben 0 stall adódik, és a modell a load-use esetet is így kezeli (a valós load-to-use késleltetés mikroarchitektúra-függő). A ciklusvesztés azonos időkonvenció mellett . A modellben a kétakkumulátoros összegzés csak a ciklusvezérlés arányát csökkenti; a függőségi lánc többszörös kibocsátású vagy hosszú késleltetésű esetben dönt, amit mérni kell. A QEMU nem ciklusra pontos, ezért az itt szereplő ciklusszámok a modellből számított értékek.
Továbbhasznált definíciók: - Adatfüggőségi akadály (data hazard): a fogyasztó operandusa olyan érték, amelyet egy korábbi, még a pipeline-ban lévő utasítás állít elő, és nincs időben elérhető útvonal. - Forwarding: az eredmény visszaírás előtti továbbítása a termelő kimenetéről a fogyasztó bemenetére. - Cikluson átívelő függőség (loop-carried dependency): egy iteráció eredményére a következő iteráció számítása épül.
A linkek és a dokumentumverziók közös állapota az Olvasói útmutató forrásállapot-táblájában van; itt csak az alfejezet saját megállapításai szerepelnek.
master, nem egy konkrét kiadott verzió állapotát
tükrözi.Ellenőrzési hiányok, amelyek a fenti ellenőrzés után is ténylegesen fennmaradnak:
lab-pipe teszthajtó kimenetét és a két függvény
végrehajtott utasításszámát
(:
5007 és 4514) helyettesítő eszközlánccal mértük — zig cc
(Clang, musl), Unicorn-alapú AArch64 emulátorban, utasításszámláló
hookkal —, nem a könyv GNU/qemu-aarch64 környezetében. A
ciklusszámok ebből a modell szerint számítottak, nem mértek.gcc-aarch64-linux-gnu buildjében
ellenőrizendő.