Egy jelfeldolgozó algoritmusban egy ciklus feltételesen ad hozzá egy mintát egy gyűjtőváltozóhoz. A feltétel a bemeneti jel értékétől függ. Ha a jel rendezett (például monoton növekvő), a feltétel hosszú sorozatokban igaz vagy hamis. Ha a jel véletlenszerű, a feltétel kiszámíthatatlanul váltakozik. Ugyanaz az utasításszám, ugyanaz a memóriahozzáférési minta, mégis drasztikusan eltérő futási időt mérhetünk. Ennek oka a processzor elágazás-előrejelző (branch predictor) egysége. Ez az alfejezet megmutatja, hogyan mérhető ez a hatás, és hogyan kerülhető el az elágazás feltételes utasítással.
Definíció (branch prediction): Az
elágazás-előrejelzés a processzor azon képessége, hogy egy feltételes
elágazás (például b.cond) végrehajtása előtt megjósolja,
hogy az elágazás feltétele teljesülni fog-e, és ennek megfelelően
spekulatívan folytatja a végrehajtást a célcímről vagy a következő
utasítással. Ha a jóslat helyes, az elágazás gyakorlatilag nulla plusz
késleltetéssel hajtódik végre. Ha téves (misprediction), a spekulatívan
betöltött és részben végrehajtott utasításokat el kell dobni, és a
helyes útvonalat be kell tölteni: ez a branch misprediction
penalty, amely tipikusan 10–20 ciklus a modern nagy
teljesítményű ARM magokon.
A prediktor működése fogalmi szinten: a processzor tárolja az elágazás korábbi kimeneteleit, és mintázatot keres. Egy egyszerű kétbites prediktor négy állapotot tart nyilván (erősen nem ugrik, gyengén nem ugrik, gyengén ugrik, erősen ugrik), és a hiszterézis segít elkerülni a zajos váltakozást. A fejlettebb prediktorok (például TAGE, correlating) az elágazások közötti korrelációt is figyelembe veszik. A lényeg: minél szabályosabb a minta, annál nagyobb a találati arány.
Kiszámítható vs. kiszámíthatatlan minta. Tekintsünk
egy if (a[i] >= threshold) feltételt, és jelölje
annak valószínűségét, hogy egy elemre igaz. Ha a tömb rendezett, a
feltétel először sokáig hamis, majd egy ponton igaz lesz, és utána végig
igaz marad: a prediktor ezt megtanulja, a tévesztések száma a váltás
körüli néhány esetre korlátozódik, a találati arány közel 100%.
Ha a tömb véletlen sorrendű, a találati arány a bemenet eloszlásától függ, nem önmagában a sorrendtől. A legegyszerűbb modell: a kimenetelek egymástól függetlenek, és mindegyik valószínűséggel igaz. Ilyenkor a múltból nincs mit tanulni, és a legjobb, amit egy prediktor tehet, hogy mindig a gyakoribb kimenetelt jósolja:
Az 50%-os találati arány tehát a független, kiegyensúlyozott () esetre érvényes. Ha a feltétel az elemek 90%-ára igaz, a véletlen sorrend mellett is 90% találatot ér el az állandó „igaz” jóslat. A kísérletben ezért a két bemenet ugyanazt az értékkészletet és ugyanannyi igaz esetet tartalmazza, és a küszöböt úgy választjuk, hogy legyen; így a két futás csak a sorrendben tér el.
Fontos megjegyezni: a prediktor tanulási ideje miatt a rövid ciklusokban a hatás kevésbé érvényesül. A méréshez elég hosszú ciklus kell (például ).
A korábban megismert feltételes kiválasztás (CSEL,
CSINC, CSINV, CSNEG) lehetővé
teszi, hogy adatfüggő elágazás helyett feltételes mozgatást használjunk.
A Feltételes végrehajtás: CSET/CSEL és
feltételkódok alfejezetben részletesen tárgyaltuk a működést. Itt
most arra használjuk, hogy egy elágazást kiváltsunk: a feltétel
kiértékelése után mindkét ág eredményét kiszámítjuk (vagy egyiket
konstanssal helyettesítjük), és a CSEL választja ki a
feltételnek megfelelőt. Ezáltal a vezérlési folyam mindig ugyanaz marad,
nincs adatfüggő elágazás, a prediktornak nincs mit elvétenie. Az ára:
mindkét ág munkáját el kell végezni (több utasítás), és a feltétel
kiszámítása is plusz utasítás. Kis ágak esetén ez nyereséges lehet, mert
elkerüli a misprediction penalty-t.
Munkakönyvtár: ~/arm-labor/a64/a051/ —
az alfejezet minden laborfájlja ide kerül, és minden parancs innen
futtatandó (a könyvtárrendet a Labor-alapkörnyezet alfejezet írja le).
mkdir -p ~/arm-labor/a64/a051
cd ~/arm-labor/a64/a051
A mérés alapelve: ugyanaz a kódrészlet, ugyanaz az adatmennyiség, csak az elágazás mintázata más. Két tömböt használunk: az egyik rendezett, a másik ugyanazokat az értékeket tartalmazza véletlen sorrendben. A feltétel ugyanaz.
Bemenet. Az elemek a értékek, a küszöb , így pontosan . A rendezett tömb ezeket növekvő sorrendben, a permutált tömb ugyanezeket egy determinisztikus álvéletlen-generátorral (xorshift64) végzett Fisher–Yates-keverés után tartalmazza. Mivel a permutált tömb ugyanazokat az értékeket tartalmazza, az igaz esetek száma és az összeg is azonos.
A kiinduló C-függvény (a teszthajtóban referenciaként szerepel, a mérés nem ezt méri — lásd az 1. tipikus hibát):
long sum_if(const long *a, long n, long threshold) {
    long s = 0;
    for (long i = 0; i < n; i++) {
        if (a[i] >= threshold) {
            s += a[i];
        }
    }
    return s;
}
A két mért változat teljes, C-ből hívható függvény. A
lab-a051_asm.S tartalma:
// lab-a051_asm.S — A64 ISA, AArch64 Linux; GNU as.
// long sum_if_asm (const long *a, long n, long threshold);  adatfüggő elágazással
// long sum_if_csel(const long *a, long n, long threshold);  CSEL-lel, elágazás nélkül
// Levélfüggvények, keretet nem építenek, ezért CFI nélküliek (lásd a029).
    .text
    .p2align 2

    .global sum_if_asm
    .type   sum_if_asm, %function
sum_if_asm:                         // x0 = a, x1 = n, x2 = threshold
    mov     x3, #0                  // s = 0
    mov     x4, #0                  // i = 0
    b       .Lcheck
.Lloop:
    ldr     x5, [x0, x4, lsl #3]    // x5 = a[i]
    cmp     x5, x2
    b.lt    .Lskip                  // adatfüggő elágazás
    add     x3, x3, x5
.Lskip:
    add     x4, x4, #1
.Lcheck:
    cmp     x4, x1
    b.lt    .Lloop                  // ciklusvezérlő elágazás
    mov     x0, x3
    ret
    .size   sum_if_asm, .-sum_if_asm

    .global sum_if_csel
    .type   sum_if_csel, %function
sum_if_csel:                        // x0 = a, x1 = n, x2 = threshold
    mov     x3, #0
    mov     x4, #0
    b       .Lcheck2
.Lloop2:
    ldr     x5, [x0, x4, lsl #3]
    cmp     x5, x2
    csel    x5, x5, xzr, ge         // ha a[i] >= threshold: a[i], különben 0
    add     x3, x3, x5
    add     x4, x4, #1
.Lcheck2:
    cmp     x4, x1
    b.lt    .Lloop2
    mov     x0, x3
    ret
    .size   sum_if_csel, .-sum_if_csel

    .section .note.GNU-stack,"",%progbits
A sum_if_asm ciklusában két feltételes elágazás van: a
b.lt .Lskip (adatfüggő) és a b.lt .Lloop
(ciklusvezérlő, kiszámítható). A sum_if_csel csak a
ciklusvezérlő elágazást tartalmazza; a CSEL a
nullaregisztert (XZR) választja, ha a feltétel hamis.
A teszthajtó előbb ellenőrzi, hogy a két bemenet igaz-darabszáma
egyezik, és mind a négy (függvény, bemenet) pár eredménye megegyezik a
C-referenciával. Csak ezután mér: melegítés, 11 ismétlés, medián és IQR,
elemenkénti nanoszekundumban. A lab-a051.c tartalma:
/* lab-a051.c — elágazásminta-kísérlet: rendezett vs. permutált bemenet. */
#define _GNU_SOURCE
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <time.h>

#ifndef LAB_N
#define LAB_N  (1L << 20)       /* elemszám */
#endif
#define WARMUP 2
#define REPS   11               /* páratlan: egyértelmű medián */

long sum_if_asm (const long *a, long n, long threshold);
long sum_if_csel(const long *a, long n, long threshold);
typedef long lab_fn(const long *, long, long);

/* C-referencia (a kísérlet nem ezt méri; csak a helyességet vetjük össze vele). */
static long sum_if_ref(const long *a, long n, long threshold)
{
    long s = 0;
    for (long i = 0; i < n; i++)
        if (a[i] >= threshold) s += a[i];
    return s;
}

/* Determinisztikus álvéletlen-generátor (xorshift64), hogy a permutáció reprodukálható
 * legyen. */
static uint64_t lab_rng = 0x9E3779B97F4A7C15u;
static uint64_t lab_next(void)
{
    lab_rng ^= lab_rng << 13; lab_rng ^= lab_rng >> 7; lab_rng ^= lab_rng << 17;
    return lab_rng;
}

static double now_ns(void)
{
    struct timespec ts;
    if (clock_gettime(CLOCK_MONOTONIC, &ts) != 0) { perror("clock_gettime"); exit(2); }
    return ts.tv_sec * 1e9 + ts.tv_nsec;
}

static int cmp_double(const void *p, const void *q)
{
    double a = *(const double *)p, b = *(const double *)q;
    return (a > b) - (a < b);
}

int main(void)
{
    const long n = LAB_N, threshold = LAB_N / 2;  /* q = P(a[i] >= threshold) = 0,5 pontosan */
    long *sorted = malloc(n * sizeof *sorted), *perm = malloc(n * sizeof *perm);
    lab_fn *fn[2] = { sum_if_asm, sum_if_csel };
    const char *fname[2] = { "sum_if_asm", "sum_if_csel" };
    const long *in[2] = { NULL, NULL };
    const char *iname[2] = { "rendezett", "permutalt" };
    int rc = 1;

    if (!sorted || !perm) goto out;

    /* Azonos értékkészlet: 0..n-1, egyszer rendezve, egyszer Fisher–Yates-permutációval. */
    for (long i = 0; i < n; i++) sorted[i] = i;
    memcpy(perm, sorted, n * sizeof *perm);
    for (long i = n - 1; i > 0; i--) {
        long j = (long)(lab_next() % (uint64_t)(i + 1));
        long t = perm[i]; perm[i] = perm[j]; perm[j] = t;
    }
    in[0] = sorted; in[1] = perm;

    /* Ellenőrzés a mérés előtt: azonos igaz-darabszám és mind a négy eredmény = referencia. */
    long ref = sum_if_ref(sorted, n, threshold), trues[2] = { 0, 0 };
    for (int d = 0; d < 2; d++)
        for (long i = 0; i < n; i++) trues[d] += in[d][i] >= threshold;
    printf("n=%ld threshold=%ld igaz: rendezett=%ld permutalt=%ld\n",
           n, threshold, trues[0], trues[1]);
    if (trues[0] != trues[1] || sum_if_ref(perm, n, threshold) != ref) goto out;
    for (int f = 0; f < 2; f++)
        for (int d = 0; d < 2; d++)
            if (fn[f](in[d], n, threshold) != ref) {
                printf("FAIL %s / %s\n", fname[f], iname[d]);
                goto out;
            }
    printf("ellenorzes: mind a negy eredmeny = %ld\n", ref);

    /* Mérés: melegítés, majd REPS ismétlés, medián és IQR, elemenként ns-ban. */
    for (int f = 0; f < 2; f++)
        for (int d = 0; d < 2; d++) {
            double t[REPS];
            volatile long sink = 0;
            for (int w = 0; w < WARMUP; w++) sink += fn[f](in[d], n, threshold);
            for (int r = 0; r < REPS; r++) {
                double t0 = now_ns();
                sink += fn[f](in[d], n, threshold);
                t[r] = (now_ns() - t0) / (double)n;
            }
            qsort(t, REPS, sizeof t[0], cmp_double);
            printf("%-11s %-9s median %7.3f ns/elem  IQR %6.3f\n",
                   fname[f], iname[d], t[REPS / 2], t[(3 * REPS) / 4] - t[REPS / 4]);
            (void)sink;
        }
    rc = 0;
out:
    free(sorted); free(perm);
    return rc;
}
Build és futtatás. A fenti két fájlból, tiszta könyvtárban, kiegészítés nélkül:
# Csak objektummá fordítás (statikus vizsgálathoz):
aarch64-linux-gnu-gcc -c lab-a051_asm.S -o lab-a051_asm.o
aarch64-linux-gnu-objdump -d lab-a051_asm.o

# A teljes labor (target: AArch64 Linux, qemu-user):
aarch64-linux-gnu-gcc -std=c17 -O2 -Wall -Wextra -static \
    -o lab-a051 lab-a051.c lab-a051_asm.S
qemu-aarch64 ./lab-a051 ; echo "exit=$?"
A kimenet első két sora determinisztikus:
n=1048576 threshold=524288 igaz: rendezett=524288 permutalt=524288,
majd ellenorzes: mind a negy eredmeny = 412316598272. A
négy időzítési sor értékei futásfüggők; QEMU alatt nem
a prediktor viselkedését tükrözik.
A -static elkerüli a dinamikus linker QEMU-beli
bonyodalmát. A QEMU TCG dinamikus bináris fordítója nem modellezi a
branch predictort, ezért a QEMU-ban kapott időkülönbség az
utasításszámból és a TCG viselkedéséből adódik. Fizikai AArch64
hardveren (Raspberry Pi 4/5) a hatás valódi, és ott kell mérni.
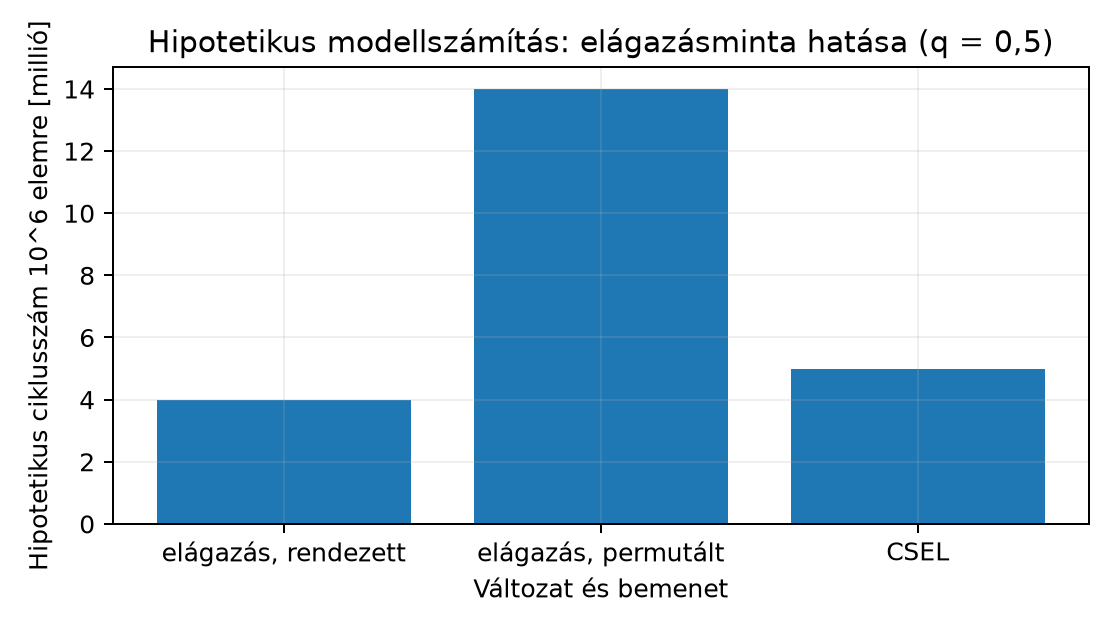
Hipotetikus modellszámítás. Az alábbi táblázat nem
mérés, hanem egy egyszerű modell kiértékelése a következő,
feltételezett paraméterekkel: elágazásos változatnál 4
ciklus/elem a tévesztés nélküli törzsidő, CSEL-es
változatnál 5 ciklus/elem, a tévesztési büntetés 20 ciklus,
,
.
A tévesztési arány a rendezett bemenetnél elhanyagolható (néhány
tévesztés a váltásnál), a permutáltnál a fenti modell alsó korlátja,
;
a CSEL-es változatban nincs adatfüggő elágazás.
| Változat | Bemenet | Adatfüggő tévesztési arány (modell) | Hipotetikus ciklusszám ( elem) |
|---|---|---|---|
| feltételes elágazás | rendezett | ≈ 0 | |
| feltételes elágazás | permutált | 0,5 | |
CSEL |
bármelyik | nincs adatfüggő elágazás |
Ha a bemenetben a feltétel 90%-ban igaz
(),
ugyanez a modell permutált sorrendre is csak 0,1 tévesztési arányt ad:
ciklus — ekkor a CSEL előnye kicsi, vagy el is tűnik.
A QEMU-ban mért időket mindig a fenti korlát figyelembevételével kell értelmezni. A Mikrobenchmark készítése és eredmények értelmezése alfejezet részletesen tárgyalja a mérési módszertant.
A fordító elágazás nélkülire alakítja a kódot.
-O2 szinten a GCC gyakran CSEL-t vagy
CSINC-et generál az if helyett
(if-conversion). Ezért a C változat mérése félrevezető lehet.
Ellenpróba: objdump -d segítségével ellenőrizzük a generált
assemblyt. Ha a cél a feltételes elágazás mérése, kézzel írt assemblyt
vagy -O0-t használjunk.
A rendezett és véletlen tömb nem ugyanazokat az elemeket tartalmazza. Ellenpróba: a két tömböt ugyanabból az adathalmazból készítsük, csak az egyiket permutáljuk. Az igaz esetek számának és az összegnek meg kell egyeznie — a teszthajtó ezt a mérés előtt ellenőrzi. Ha az igaz-arány eltér, a két mérés nem csak a sorrendben különbözik.
A ciklus túl rövid. A prediktor tanulási ideje és a mérési zaj miatt kis esetén nem látszik a különbség. Ellenpróba: elemet használjunk, és több futás mediánját és szóródását (IQR) közöljük.
A QEMU nem modellezi a branch predictort. A QEMU TCG nem szimulálja a prediktor állapotát; a mért idő inkább az utasításszám és a memóriahozzáférés függvénye. Ellenpróba: a mérést fizikai AArch64 hardveren is megismételni, és az eredményeket külön jelölni.
1. feladat (magyarázó, alapszint — cél: megértés-ellenőrzés). Magyarázd el, miért lehet lassabb egy véletlen elágazásminta ugyanannyi utasítás mellett, mint egy rendezett. Térj ki a prediktor működésére és a misprediction penalty fogalmára. Hogyan változik a válasz, ha a ciklus törzse 1 utasításból áll, és a misprediction penalty 15 ciklus?
2. feladat (implementációs, középszint — cél:
rutinépítés). Írj A64 assembly rutint, amely egy
long tömb elemeit összegzi úgy, hogy a negatív értékeket az
abszolút értékükkel helyettesíti. Készíts két változatot: (a) feltételes
elágazással (b.ge/b.lt), (b)
CSEL-lel elágazás nélkül. Fordítsd le
gcc-aarch64-linux-gnu-val, futtasd
qemu-aarch64-val, és mérd az időt
clock_gettime-nal. Készíts rendezett és véletlen bemenetet.
Hasonlítsd össze az eredményeket, és indokold a különbséget.
3. feladat (hibakeresési/mérési, középszint — cél:
rutinépítés). Adott egy C program, amely -O2-vel
fordítva feltételes elágazást tartalmaz. objdump -d
segítségével keresd meg az elágazást. Ezután módosítsd a kódot úgy, hogy
a fordító CSEL-t generáljon (például
cond ? x : y kifejezéssel). Mérd meg mindkét változat
idejét rendezett és véletlen bemeneten. Magyarázd el, miért tér el a két
változat viselkedése.
1. megoldás — Segítség. Számítsd ki az átlagos ciklusköltséget mindkét esetre külön: rendezettnél a prediktor szinte mindig helyesen jósol, véletlennél csak az esetek feléről — mi az elvárt érték egy súlyozott átlagban?
1. megoldás — Teljes megoldás. A prediktor a korábbi kimenetelek alapján mintázatot tanul. Rendezett bemenet esetén a feltétel hosszú sorozatokban azonos, így a prediktor közel 100%-os találati arányt ér el. Véletlen sorrendű bemenetnél a találati arány a kimenetelek eloszlásától függ: független, valószínűséggel igaz kimeneteleknél legfeljebb ; a kiegyensúlyozott, esetben ez 50%. Minden téves jóslatnál a processzor eldobja a spekulatívan végrehajtott utasításokat, és újratölti a pipeline-t: ez a misprediction penalty, tipikusan 15–20 ciklus. Ha a ciklus törzse 1 utasítás, a helyes végrehajtás 1 ciklus, a tévesztés 15 ciklus plusz. A véletlen esetben a futási idő jelentősen megnő. Számszerűen: rendezett esetben 1 ciklus/iteráció, véletlen esetben ciklus/iteráció. Ez a levezetés feltételezi, hogy a prediktor a rendezett mintát tökéletesen jósolja, a véletlen bemenet pedig független és kiegyensúlyozott (). Ha például , az állandó „igaz” jóslat 90%-ot ér el, és a véletlen eset várható ideje ciklus/iteráció.
2. megoldás — Segítség. Az if-ágas
változat szinte szóról szóra lefordítja a
cmp/b.ge/neg/összegzés sorrendet;
a CSEL-es változat előre kiszámítja MINDKÉT lehetséges
eredményt (a[i] és -a[i]), majd a feltétel
alapján választ köztük elágazás nélkül.
2. megoldás — Teljes megoldás. Az assembly rutinok:
// long sum_abs_if(const long *a, long n)
// x0 = a, x1 = n
    mov     x2, #0              // s = 0
    mov     x3, #0              // i = 0
    b       .Lcheck
.Lloop:
    ldr     x4, [x0, x3, lsl #3]
    cmp     x4, #0
    b.ge    .Lpos
    neg     x4, x4
.Lpos:
    add     x2, x2, x4
    add     x3, x3, #1
.Lcheck:
    cmp     x3, x1
    b.lt    .Lloop
    mov     x0, x2
    ret
CSEL-es változat:
// long sum_abs_csel(const long *a, long n)
// x0 = a, x1 = n
    mov     x2, #0              // s = 0
    mov     x3, #0              // i = 0
    b       .Lcheck2
.Lloop2:
    ldr     x4, [x0, x3, lsl #3]
    neg     x5, x4              // x5 = -a[i]
    cmp     x4, #0
    csel    x4, x4, x5, ge      // ha a[i] >= 0, x4 marad, különben x5
    add     x2, x2, x4
    add     x3, x3, #1
.Lcheck2:
    cmp     x3, x1
    b.lt    .Lloop2
    mov     x0, x2
    ret
A méréshez a C programban generáljunk két tömböt: az egyikben a negatív értékek véletlenszerűen, a másikban minden negatív érték előre (például a tömb első felében). Az összeg mindkét esetben ugyanaz. A mért idő QEMU-ban illusztratív; a feltételes elágazás változatánál a véletlen minta lassabb lehet, a CSEL változatnál a minta nem befolyásolja az időt.
3. megoldás — Segítség. objdump -d-ben
keress b.-kezdetű feltételes elágazás mnemonicot az eredeti
programban; az -O2-vel generált CSEL-nél
viszont nincs ilyen, csak egy CMP és egy
CSEL.
3. megoldás — Teljes megoldás. -O2
mellett a GCC gyakran CSEL-t generál. Például:
long f(long x, long y) {
    return x > y ? x : y;
}
A generált kód:
    cmp     x0, x1
    csel    x0, x0, x1, gt
    ret
Ha feltételes elágazást akarunk, -O0-t vagy
volatile-t használhatunk, vagy kézzel írhatunk assemblyt. A
mérésnél a CSEL változat időben független a bemeneti
sorrendtől, míg a feltételes elágazás változat a véletlen mintánál
lassabb. Az eltérés oka a misprediction penalty. A disassembly
ellenőrzése objdump -d-vel történik.
Az elágazás-előrejelző (branch predictor) a korábbi kimenetelekből
tanuló mintázatfelismerő. Kiszámítható (rendezett) elágazásminta esetén
a találati arány közel 100%. Független, véletlen kimeneteleknél a
találati arány legfeljebb
— kiegyensúlyozott esetben 50%, de egy 90%-ban igaz feltételnél 90% —,
és minden téves jóslat (misprediction) 10–20 ciklus veszteséget okoz.
Ugyanaz az utasításszám mellett a véletlen elágazásminta ezért
lényegesen lassabb lehet. A CSEL feltételes kiválasztás
elkerüli az adatfüggő elágazást, cserébe mindkét ág kiszámításáért.
QEMU-ban a branch prediction hatása nem mérhető hardverhűen, mert a TCG
nem modellezi a prediktort; a mérést fizikai AArch64 hardveren kell
validálni.
Továbbhasznált definíciók: -
Elágazás-előrejelzés (branch prediction): a processzor
azon képessége, hogy egy feltételes elágazás kimenetelét a végrehajtás
előtt megjósolja. - Misprediction penalty: a téves
jóslat miatt eldobott spekulatív munka és a helyes útvonal betöltésének
ciklusvesztesége. - If-conversion: feltételes elágazás
átalakítása feltételes utasítássá (például CSEL), így
elkerülve az elágazást.
A linkek és a dokumentumverziók közös állapota az Olvasói útmutató forrásállapot-táblájában van; itt csak az alfejezet saját megállapításai szerepelnek.
CSEL. Ellenőrizve: a
link él (a fejezetszám és a kiadásbetű az Arm-oldalak közös korlátja
miatt nem ellenőrzött).master ág dokumentációja (nem
konkrét kiadott verzió); a hivatalos user-mode fejezet nem állít semmit
a branch prediction modellezéséről — ez a TCG funkcionális (nem
cikluspontos) jellegéből következik, nem egy explicit QEMU-dokumentált
korlát.asm szintaxis, direktívák.
Tartalmilag ellenőrizve: a jelenlegi kiadás binutils
2.47.Ellenőrzési hiányok, amelyek a fenti ellenőrzés után is
ténylegesen fennmaradnak: - A lab-a051 helyességi
részét (azonos igaz-darabszám, mind a négy eredmény egyezése a
referenciával) helyettesítő eszközlánccal — zig cc (Clang,
musl), Unicorn-alapú AArch64 emulátorban, kisebb
-nel
— futtattuk; az időzítési sorokat nem közöljük, mert az emulátor ideje
semmilyen hardverre nem jellemző. A determinisztikus kimeneti sorok
-ra
számítottak. - A QEMU TCG branch prediction viselkedése és a
cntvct_el0 pontossága QEMU user-mode alatt nem ellenőrzött
ebben a munkafolyamatban; a mérésekhez fizikai AArch64 hardver javasolt.
- A konkrét ARM magok misprediction penalty értékei (például Cortex-A76,
Apple M1) a mikroarchitektúra-specifikus dokumentációból ellenőrizendők;
a 10–20 ciklus itt illusztratív nagyságrend.