A Láncszabály és számítási gráf alfejezetben
már kiszámoltuk egy veszteségfüggvény gradiensét a láncszabállyal. A
gradiens önmagában egy irányt ad: amerre a függvény a leggyorsabban nő.
Az optimalizálás ezt az irányt megfordítja, és kis lépésekkel csökkenti
a veszteséget. Ebben az alfejezetben egy saját, kis gradiensmódszert
írunk, majd összehasonlítjuk a SciPy beépített solverével. A cél nem az,
hogy termelési optimalizálót fejlesszünk, hanem hogy pontosan értsük a
success jelzést, a jac paramétert, a
tol-t és a lokális optimum érvényességi korlátját.
A konkrét laborfeladat a Himmelblau-függvény minimalizálása, két paraméterrel:
Itt a paramétervektor, alakja ; skaláris értékű veszteség, ebben a tanpéldában dimenziótlan koordinátákkal. A Himmelblau-függvénynek több, egyenként értékű lokális minimuma van, ezért ideális arra, hogy megmutassa: a solver sikerjelzése nem globális optimalitási bizonyíték. Megfigyelési egységnek egy iterációt tekintünk; a napló minden lépésben tartalmazza az iteráció sorszámát, a paramétereket, a veszteséget és a gradiens normáját. Előzetes becslés: a kezdőpont a függvény északnyugati völgye, a kezdőpont másik völgy felé indul; ezért a két futtatás valószínűleg különböző optimumot talál.
Objektív függvény, gradiens és a solver felülete. Az
angol objective function a minimalizálandó
függvény. A scipy.optimize.minimize első paramétere ez a
függvény, amelynek bemenete egy NumPy-tömb, kimenete egy skalár. A
jac a gradiensfüggvényt jelöli:
,
amely ugyanolyan alakú tömböt ad, mint
.
A Himmelblau-függvényre a parciális deriváltak:
A kezdőpontban kézzel ellenőrizve: és , ezért , . A gradiensvektor , normája . Ez a vektor mutatja a leggyorsabb növekedés irányát, ezért a frissítés irányban csökkenti a veszteséget.
Tolerancia és megállási ok. A numerikus optimalizáló
nem tudja pontosan elérni a minimumot, ezért megállási feltételeket
használ. A scipy.optimize.minimize BFGS-módszerénél a
leggyakrabban használt három küszöb:
gtol: a gradiens normájának küszöbe. Ha
,
a pont közel van egy stacionárius ponthoz, és a solver megáll.ftol: a veszteség két lépés közötti relatív
változásának küszöbe.xtol: a paraméterváltozás küszöbe.Mindegyik a megállás feltétele, nem a helyesség
bizonyítéka. Ha a maximum iterációszám vagy kiértékelésszám éri el a
korlátot, a success hamis lesz, és a message
szövege elmagyarázza a megállási okot. A tol paraméter a
BFGS belső vonalkeresésének toleranciáját vezérli; a
gtol-tól elkülönítve értelmezendő.
Skálázás. A gradiensmódszer lépése , ahol a tanulási sebesség (learning rate). A lépés elfogadható nagyságát a veszteség görbülete és a változók mértékegysége együtt határozza meg. Tekintsük a konvex kvadratikus példát:
Ennek gradiense . A második irány négyszer meredekebb, ezért ugyanaz a oda nagyobb lépést okoz. A irányban a frissítés lineáris rekurzió: . Ez akkor konvergál, ha , azaz . Ha , a szorzó , és a sorozat oszcillálva elszáll. A irányban a feltétel enyhébb, . A szűkebb korlát diktál: legfeljebb . Ez a skálázási kérdés: a változók eltérő mértékegysége vagy az eltérő görbület lelassítja a rögzített lépéses gradiensmódszert, míg a BFGS a görbületet közelítve automatikusan igazítja a lépésirányt és -hosszt.
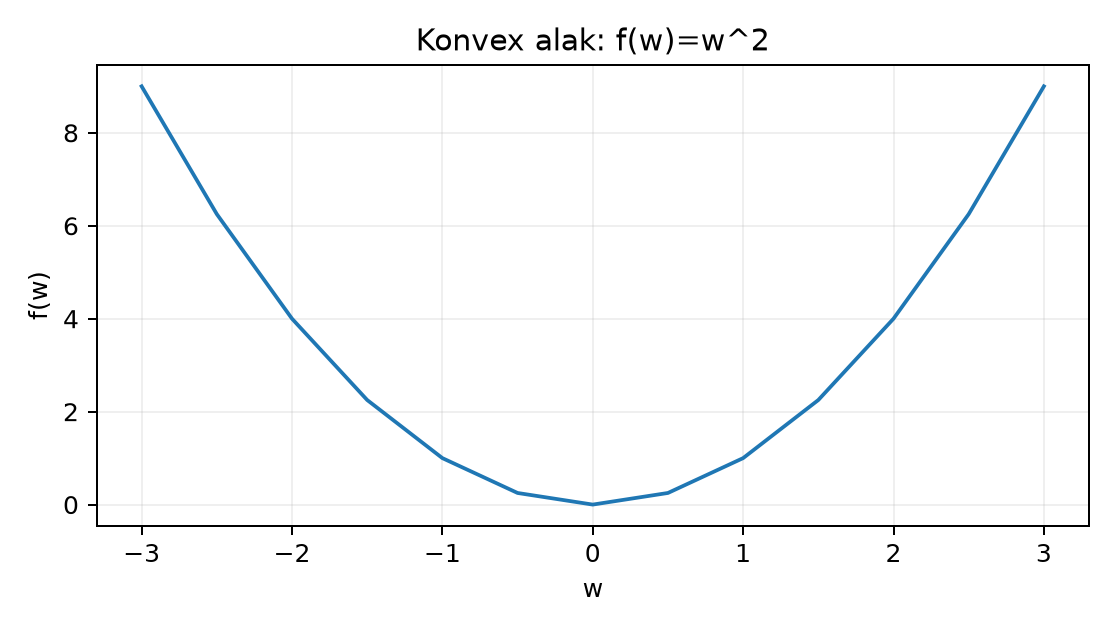
Lokális optimum és konvexitás. A pont lokális minimum, ha létezik olyan környezet, hogy esetén . A globális minimum minden -re teljesíti ugyanezt. Konvex függvényre minden lokális minimum globális; nem konvex függvényre ez nem igaz. A konvexitást intuitíven a húr segítségével ellenőrizhetjük: a függvény konvex, ha bármely két pontját összekötő szakasz a függvény görbéje fölött vagy azon halad.
A fenti görbén bármely két pontot kiválasztva a húr a görbén vagy fölötte van: a függvény konvex. A következő görbe nem konvex: a és pontok között a húr a nulla szinten van, de a görbe középen mélyen alatta halad.
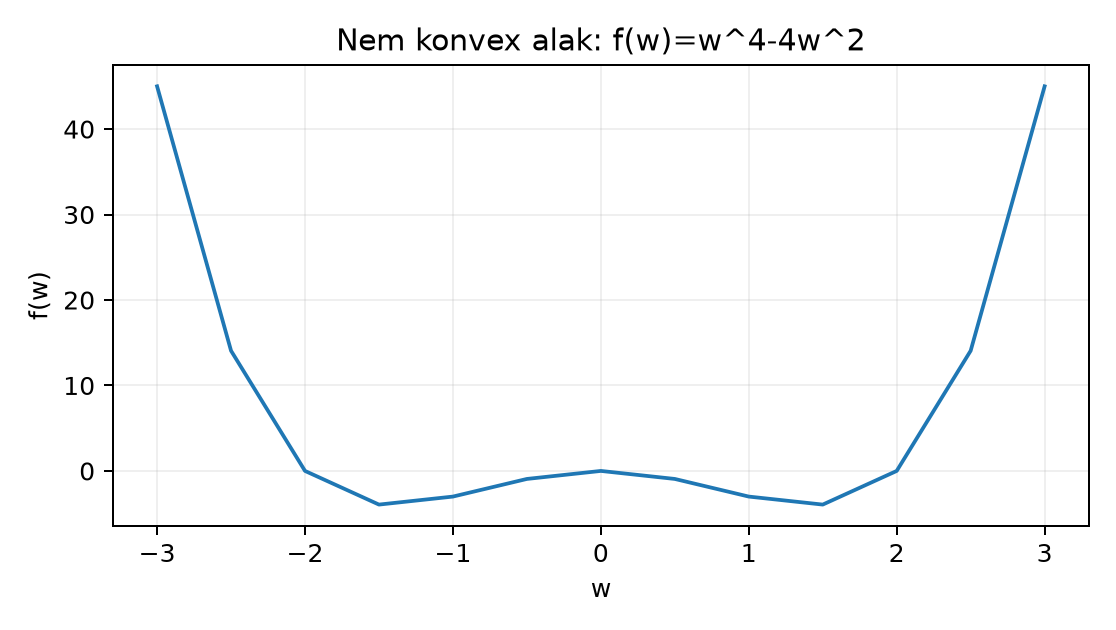
A Himmelblau-függvény nem konvex, ezért a kezdőponttól függően más-más lokális minimumba konvergálhat. A bizonyítás nem előfeltétel, a szemlélet elegendő.
A következő szkript a lab projekt könyvtárában
futtatható, a lab/pyproject.toml által definiált NumPy és
SciPy környezetben. A futtatás parancsa Linux/macOS terminálból és
Windows PowerShellből is python s044_lab.py;
JupyterLab-kernelben ugyanez a kód cellánként is végrehajtható. A
példában nincs véletlen szám, ezért seed nem szükséges. A scipy
verzióérzékeny viselkedése miatt a gtol-t explicit módon
1e-8-ra állítjuk, hogy a megállási kritérium ne az
alapértelmezésen múljon.
import numpy as np
from scipy.optimize import minimize

def himmelblau(w):
    """Objektív függvény: w alakja (2,), a kimenet skalár."""
    x, y = w[0], w[1]
    return (x*x + y - 11.0)**2 + (x + y*y - 7.0)**2

def himmelblau_grad(w):
    """A Himmelblau-függvény analitikus gradiense, alakja (2,)."""
    x, y = w[0], w[1]
    g1 = 4.0*x*(x*x + y - 11.0) + 2.0*(x + y*y - 7.0)
    g2 = 2.0*(x*x + y - 11.0) + 4.0*y*(x + y*y - 7.0)
    return np.array([g1, g2])

def gradient_descent(f, grad, x0, eta=0.005, gtol=1e-8, max_iter=50000):
    """Saját rögzített lépéses gradiensmódszer, teljes iterációs naplóval."""
    x = np.array(x0, dtype=float)
    log = []
    for k in range(max_iter):
        g = grad(x)
        f_val = f(x)
        log.append((k, x.copy(), f_val, np.linalg.norm(g)))
        if np.linalg.norm(g) < gtol:
            return x, f_val, log, f"gradient-norm < {gtol}"
        x = x - eta * g
    return x, f(x), log, f"max_iter={max_iter}"

# Saját módszer két kezdőpontból
for x0 in [(-2.0, 2.0), (0.0, 0.0)]:
    x_opt, f_opt, log, reason = gradient_descent(
        himmelblau, himmelblau_grad, x0)
    print(f"start={x0} -> w={x_opt}, L={f_opt:.3e}, "
          f"iter={len(log)-1}, stop={reason}")
    for row in log[-3:]:
        print("  log:", row)

# Könyvtári solver BFGS-sel, ugyanazzal a gradienssel
for x0 in [(-2.0, 2.0), (0.0, 0.0)]:
    res = minimize(himmelblau, x0, method='BFGS', jac=himmelblau_grad,
                   options={'gtol': 1e-8})
    print(f"BFGS start={x0} -> w={res.x}, L={res.fun:.3e}, "
          f"success={res.success}, nit={res.nit}, msg={res.message}")
    print("  jac at solution:", res.jac)
A kód kimenete az adott géptől és NumPy/SciPy verziótól függően
kismértékben eltérhet; a következő sorok tehát szemléltető
jellegűek, nem ellenőrzött mérési jegyzőkönyv. Az elméletileg várt
viselkedés az, hogy a saját módszer sok iteráció után a
gradient-norm < 1e-08 okkal áll meg, míg a BFGS pár
tucat iteráció alatt ugyanoda jut. A
kezdőpontból a Himmelblau ismert
minimumához közeli pont, a
kezdőpontból a
minimumhoz közeli pont várható; mindkét pontban
.
A saját gradiensmódszerünk ugyanazt a gradiensfeltételt ellenőrzi,
mint a BFGS: a megállás pillanatában
.
A napló utolsó sorában a gradiensnorma közel nulla, ez a közelítő
stacionaritás elfogadható jele. A BFGS res.success=True
értéke ugyanezt jelenti: a solver a beállított toleranciát elérte. A
res.message szövege a konkrét megállási okot adja meg; ha a
futás iterációkorlátba ütközne, a success hamis lenne, és a
message ezt jelezné.
Kézi kontrollként a megtalált pontban érdemes visszahelyettesíteni a
gradiens képletébe. A
pontban
és
,
ezért
.
Ez a Himmelblau négy ismert zérusának egyike, és a veszteség invariáns
tulajdonsága, hogy mindegyikben
.
A másik kezdőpontból kapott pont a gradiens numerikus nulláját adja, de
a pontos ismert minimumtól a toleranciának megfelelő távolságra
maradhat; ez nem hiba, hanem a gtol értelmezése.
A BFGS módszer a gradiensből kvázinewton közelítést épít a görbületre, ezért a lépésirányt és a lépéshosszt is igazítja. A rögzített gradiensmódszerhez képest sokkal kevesebb iterációt használ ugyanahhoz a megállási feltételhez. Ez a különbség nem statisztikai tulajdonság: itt determinisztikus optimalizálásról van szó, a tanítási adatokból származó bizonytalanság nélkül.
A scipy.optimize.minimize success mezője
egy algoritmusspecifikus leállási feltételt jelez, nem globális
optimálissági bizonyítékot. Nemkonvex célfüggvény esetén több kezdőpont,
a függvényérték és a gradiensnorma összevetése szükséges.
Értelmezés. A minimize visszatérési
objektumában magyarázd el a success, message,
nit, fun, jac és
nfev mezők jelentését. Miért nem következik a
success=True értékből, hogy a Himmelblau-függvény globális
minimumában vagyunk?
Implementálás backtrackinggel. Módosítsd a saját gradiensmódszert úgy, hogy rögzített helyett backtracking vonalkeresést használjon. A lépésméretet addig felezd, amíg az Armijo-feltétel nem teljesül: , ahol . Futtasd a és kezdőpontokból, és hasonlítsd össze az iterációszámot a rögzített lépéses változattal.
Hibadiagnózis. Az alábbi kód a konvex kvadratikus példán lépésmérettel futtatja a gradiensmódszert, de a veszteség nem csökken, hanem robban.
def f(w):
    return (w[0]-3.0)**2 + 4.0*(w[1]+1.0)**2 + 5.0

def g(w):
    return np.array([2.0*(w[0]-3.0), 8.0*(w[1]+1.0)])

w = np.array([0.0, 0.0])
for k in range(30):
    w = w - 0.3 * g(w)
    print(k, w, np.linalg.norm(g(w)))
Magyarázd meg a szorzókon keresztül, miért divergál a második komponens, és add meg azt a lépésméret-tartományt, amelyre mindkét komponens konvergál.
1. megoldás. A success logikai érték,
amely azt jelzi, hogy a solver valamelyik megállási feltételt elérte a
beállított toleranciával. A message a konkrét megállási
okot szövegezi, például
Optimization terminated successfully vagy
Maximum number of iterations exceeded. A nit
az iterációk száma, a fun az objektív függvény értéke a
megoldásban, a jac a gradiensvektor ugyanott, az
nfev pedig az objektív függvény kiértékeléseinek száma. A
success=True csak annyit mond, hogy a solver közelítőleg
elsőrendű stacionárius pontot talált a beállított gtol
mellett. A Himmelblau-függvénynek több minimuma van; a
és
kezdőpontokból különböző minimumokat kapunk, és mindkettőre igaz lehet a
success=True. Ezért a siker nem globális optimalitási
bizonyíték.
2. megoldás. A backtrackinges implementáció például:
def gradient_descent_bt(f, grad, x0, eta0=1.0, c=1e-4, rho=0.5,
                        gtol=1e-8, max_iter=50000):
    x = np.array(x0, dtype=float)
    log = []
    for k in range(max_iter):
        g = grad(x)
        f_val = f(x)
        log.append((k, x.copy(), f_val, np.linalg.norm(g)))
        if np.linalg.norm(g) < gtol:
            return x, f_val, log, f"gradient-norm < {gtol}"
        eta = eta0
        while f(x - eta * g) > f_val - c * eta * np.dot(g, g):
            eta *= rho
            if eta < 1e-16:
                return x, f_val, log, "line-search failed"
        x = x - eta * g
    return x, f(x), log, f"max_iter={max_iter}"
A lépéshossz induló értéke nagy, és csak akkor csökken, ha a
veszteségcsökkenés nem éri el az Armijo-előrejelzés legalább
-szeresét.
Így a módszer alkalmazkodik a görbületen változó Himmelblau-felszínhez.
A két kezdőpontból a backtracking jellemzően kevesebb iterációval ér a
gtol alá, mint a rögzített
;
a tényleges iterációszámot a tanuló saját futtatása adja, és a két
módszer azonos tolerancia mellett összehasonlítható.
3. megoldás. A gradiensfrissítés a második komponensre . esetén a szorzó , amelynek abszolút értéke nagyobb 1-nél, ezért a hiba minden lépésben -szeresére nő, előjelet váltva oszcillál. Az első komponensre a szorzó , abszolút értéke , tehát az konvergálna. A közös lépésméretre mindkét komponens feltételének egyszerre kell teljesülnie: és . A másodikból . Így a konvergencia tartománya . A hiba oka a második irány nagyobb görbülete; a javítás vagy kisebb (például ), vagy a változók azonos skálára hozása.
4. megoldás. A konvex kvadratikus függvény minimuma , a minimális veszteség , mert mindkét négyzetes tag itt nulla. A BFGS ezt a pontot adja függetlenül a kezdőponttól, mert konvex függvényen az egyetlen stacionárius pont globális minimum. A átparaméterezéssel , és a gradiens a irányban . A két irány görbülete most és ; a konvergenciát a legszélsőségesebb szorzó korlátozza, és a lépésméret választása ismét más lesz. A minimum helye az új koordinátákban , visszatranszformálva , a minimális veszteség pedig továbbra is : a skálázás nem változtatja meg a feladat matematikai minimumát, csak a gradiensmódszer útját és sebességét. Az invariant tehát mindkét paraméterezésben.
A leggyakoribb tévedés, hogy a solver success jelzését
globális optimalitási vagy statisztikai bizonyítékként kezeljük. A
success=True csak a konvergenciafeltétel elérését jelenti a
megadott toleranciával. Ellenpéldaként tekintsük az egyváltozós
függvényt. A BFGS a
kezdőpontból a
lokális minimumba konvergál, ahol
,
és success=True lesz; a függvény azonban
esetén
-be
tart, tehát globális minimuma nincs is. Hasonlóképpen, ha a
Himmelblau-függvényen két kezdőpontból két különböző, de mindkettő
success=True jelzésű megoldást kapunk, a solver sikere
éppen a lokális jelleg bizonyítéka. Statisztikai értelemben a
paraméterbecslés bizonytalanságát konfidenciaintervallum vagy posterior,
nem a success mező adja meg. A gradiensmódszer visszautal a
Láncszabály és számítási gráf láncszabályból
kapott gradiensre, a gradiensnorma pedig a Sajátérték, SVD és dimenziócsökkentés előképe
alfejezetből ismert euklideszi vektornorma. A Paraméterezett lekérdezés és lekérdezési terv
lekérdezési tervéhez hasonlóan a solver is naplózza a végrehajtott
lépéseket, de a napló megléte önmagában nem helyettesíti az eredmény
értelmi ellenőrzését.
Önellenőrzés: (1) Mit jelent pontosan a gtol=1e-8 a
BFGS-ben? (2) Miért lassul le a rögzített lépéses gradiensmódszer, ha a
változók eltérő skálán vannak? (3) Milyen tulajdonság garantálná, hogy
egy lokális minimum egyben globális is?
A saját rögzített lépéses gradiensmódszer ugyanazt a
gradiensnorma-megállási feltételt használja, mint a
scipy.optimize.minimize BFGS-verziója, de a BFGS a
görbületet közelítve sokkal kevesebb iterációból ér célba. A
jac a gradiensfüggvényt adja át a solvernak, a
gtol a stacionaritás közelítő feltétele, a skálázás pedig a
lépésméret felső korlátját szabja meg. Nem konvex Himmelblau-függvényen
két kezdőpont két különböző, de egyaránt érvényes lokális minimumot
találhat; a success=True ezért nem globális optimalitási
bizonyíték. A következő lépésben az optimalizálás eszköze a
valószínűségi sűrűség és az integrál fogalmával egészül ki, ami a Monte
Carlo-becslések alapja lesz.