Ez az egység a VGG egyik legismertebb tervezési döntését, a kis -as kernelek egymás utáni alkalmazását vizsgálja. A cél annak pontos megértése, hogy a mélység növelése hogyan kapcsolódik a recepciós mezőhöz, a paraméterszámhoz és a nemlinearitáshoz. Az előismeret a 17.2. AlexNet és a kísérleti kontextus történeti kontextusa: az AlexNet nagy kerneleket használt, a VGG ezt cserélte kisebbekre. Szükség van a 16.3. Elméleti és effektív recepciós mező recepciósmező-rekurziójára és a 13.3. Lokális szűrők és tanult reprezentáció lineáris/affin megkülönböztetésére. A kísérleti állításokhoz visszaidézzük az 5.3. Mintavételi bizonytalanság és intervallum mintavételi bizonytalanságról tanultakat: egyetlen futtatás eredménye nem általános tétel.
Induló kérdés: ha egy -es bemeneten egy -ös, stride 1, padding nélküli réteg kimenete , és két egymás utáni -as réteg kimenete szintén , akkor a két blokk ugyanazt a bemeneti tartományt látja? És melyik használ kevesebb paramétert, ha a csatornaszám mindenhol ?
Legyen egy 2D cross-correlation réteg súlya , biasza . A programozói főútban a réteg keresztkorrelációt számol, nem matematikai konvolúciót: a kernel nem fordul meg, az indexezés a 13.2. Konvolúció és cross-correlation konvencióját követi.
Definíció (kernelstack). Két vagy több konvolúciós réteg kompozícióját kernelstacknek nevezzük, ha a rétegek kimenetei között elemenkénti nemlineáris aktiváció, itt ReLU áll. Az -edik réteg kimenete , ahol a cross-correlation, a bemenet.
Definíció (elméleti recepciós mező, RF). A 16.3. Elméleti és effektív recepciós mező rekurziójával: , , és Itt a kimeneti rácson mért lépésköz (jump), a bemeneti rácson mért mező oldalhossza, a stride, a kernelméret, a dilation. A padding nem változtatja sem -et, sem a paraméterszámot.
Lemma (kis kernelek kompozíciója). Tekintsünk két egymás utáni -as cross-correlation réteget stride , dilation és tetszőleges padding mellett; a rétegek közé tegyünk ReLU-t. Legyen mindkét réteg bemeneti és kimeneti csatornaszáma . Ekkor
Bizonyítás. Az (1) ponthoz a rekurziót használjuk. Az első rétegen , , , , így A második rétegen , . Egyetlen -ös rétegen , tehát a mező megegyezik.
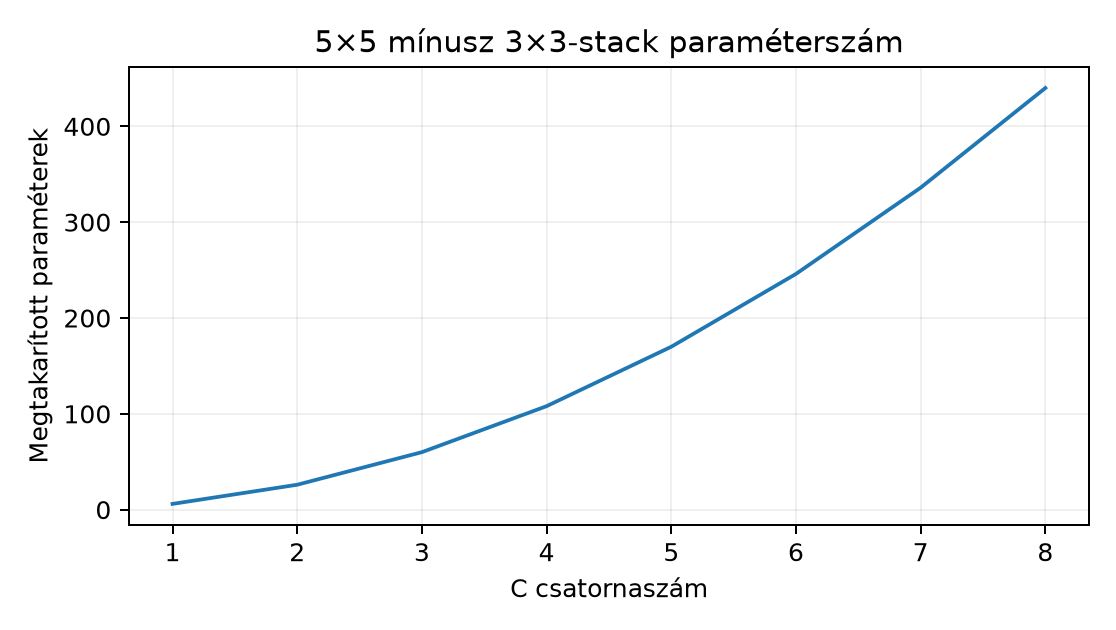
A (2) ponthoz a súlytenzor méretét szorozzuk össze és adjuk hozzá a biaszt. Egy -s, csatornás réteg paraméterszáma , mert minden kimeneti csatornához súly és egy bias tartozik. A stack első rétege , a második ugyanennyi, így Az -ös rétegre . A különbség ami esetén pozitív, mert .
A lemma feltétele fontos: az első és második réteg csatornaszáma is . Ha a bemenet , a középső , a kimenet , akkor és az összehasonlítás már nem független a csatornaválasztástól. A VGG gyakorlatában a csatornaszámok fokozatosan nőnek, ezért a megtakarítás mértéke rétegenként eltérő, de a -as választás a paraméterszámot az azonos csatornájú részekben csökkenti.
A paraméterkülönbséget szemlélteti a következő ábra:
Legyen minden rétegben, stride 1, padding 0, bemenet csatorna helyett csatorna, így a lemma feltétele teljesül. A bemeneti kép . A kimeneti méret padding nélkül:
A térbeli kimenet egyezik, a recepciós mező mindkettőnél . A paraméterszám:
A stack tehát paramétert takarít meg, miközben ugyanazt a bemeneti tartományt fedi le, és egy extra ReLU-t is tartalmaz. Ezt a számítást a következő rövid Python-kóddal ellenőrizhetjük:
import torch
import torch.nn as nn

torch.manual_seed(20261020)
device = torch.device('cpu')
dtype = torch.float32

X = torch.randn(2, 4, 10, 10, dtype=dtype, device=device)

stack = nn.Sequential(
    nn.Conv2d(4, 4, kernel_size=3, padding=0),
    nn.ReLU(),
    nn.Conv2d(4, 4, kernel_size=3, padding=0),
)
single = nn.Conv2d(4, 4, kernel_size=5, padding=0)

def n_params(m):
    return sum(p.numel() for p in m.parameters() if p.requires_grad)

print("stack params:", n_params(stack))   # várt: 296
print("single params:", n_params(single)) # várt: 404

with torch.no_grad():
    y_stack = stack(X)
    y_single = single(X)
print("stack output shape:", y_stack.shape)   # várt: torch.Size([2, 4, 6, 6])
print("single output shape:", y_single.shape) # várt: torch.Size([2, 4, 6, 6])
A kód kimenete itt nem rögzített futtatásból származik; a kommentben megadott értékek a levezetett paraméterszámok és a konvolúciós alakképlet alapján elvárt ellenőrzések. A kód futtatása után ezeknek az értékeknek kell megjelenniük.
A labor célja a fenti két blokk összehasonlítása azonos bemeneten, dokumentált kapacitással. A főút kis CPU-n fut, nincs GPU, nincs előtanított súly.
Input: saját generálású
,
float32, értékei a
intervallumból; a seed 20261020. A
csatorna a szürkeárnyalatos GlyphLab sémát idézi, de ez a labor nem
használja a GlyphLab fájlokat, és nem tanít modellt.
Blokkok:
A blokk: egyetlen -ös réteg, , , padding ; kimeneti alak . Paraméterszám:
B blokk: -as réteg , ReLU, majd -as réteg ; mindkét padding , ezért a kimenet szintén . Paraméterszám:
A labor tehát nem az azonos csatornás lemma feltételét használja, mert az első réteg a bemeneti csatornát -re bővíti. A cél a shape-egyezés, a recepciós mező és a kapacitáskülönbség ellenőrzése, nem a paraméterazonosság.
Kód és futtatási parancs:
# fajl: lab_vgg_stack.py, futtatas: python lab_vgg_stack.py
import torch
import torch.nn as nn

torch.manual_seed(20261020)

X = torch.rand(1, 1, 9, 9, dtype=torch.float32)

blockA = nn.Conv2d(1, 4, kernel_size=5, padding=2)
blockB = nn.Sequential(
    nn.Conv2d(1, 4, kernel_size=3, padding=1),
    nn.ReLU(),
    nn.Conv2d(4, 4, kernel_size=3, padding=1),
)

def n_params(m):
    return sum(p.numel() for p in m.parameters())

with torch.no_grad():
    yA = blockA(X)
    yB = blockB(X)

print("A params:", n_params(blockA))  # elvart: 104
print("B params:", n_params(blockB))  # elvart: 188
print("A shape:", tuple(yA.shape))    # elvart: (1, 4, 9, 9)
print("B shape:", tuple(yB.shape))    # elvart: (1, 4, 9, 9)
print("abs diff max:", (yA - yB).abs().max().item()) # veletlenszeru, nem 0
Ellenőrzés és eredményértelmezés. A futtatás során a két paraméterszámnak rendre -nek és -nak kell lennie. A shape-ek egyezése azt igazolja, hogy a padding úgy lett beállítva, hogy mindkét blokk ugyanazt a térbeli felbontást adja. Az elméleti RF mindkét blokkra : a B blokk első rétege , a második mezőt lát. A különbség a paraméterekben van, és a B blokk egy extra ReLU-t is tartalmaz. A labor nem végez tanítást, így a kimeneti tenzorok különbsége véletlenszerű; ott nem várunk zérust. A futtatás tényleges elvégzése után az eredmények rögzíthetők, de e kézirat a kimenetet nem állítja mértnek.
A [P05] Simonyan–Zisserman-tanulmány absztraktja nagyon mély, – súlyozott rétegű konvolúciós hálózatokat mutat be; a szerzők a hálózat nevében a VGG rövidítést használják. Az architektúra az [S01] kurzusjegyzet szerint kizárólag -as konvolúciókat és -es max-poolingot alkalmaz, a csatornaszámot -ről duplázva -ig növeli. A korábbi [P04] AlexNet ezzel szemben -es és -ös kerneleket is használt, tehát a VGG a kernelméret csökkentésével egyszerűsítette a mintázatot.
A VGG-ben a -as stack előnye nemcsak a paraméterszám. Ugyanazon -ös mezőn belül két ReLU áll rendelkezésre, azaz a blokk kimenete egy mélyebb, darabonként lineáris függvény. Ez több döntési határt képes reprezentálni, mint egyetlen lineáris szűrő utáni ReLU. A paraméterszám-megtakarítás azonban a leglátványosabb a konvolúciós részekben: a lemma szerint azonos mellett a stack olcsóbb.
A VGG másik tanulsága a classifier cost. A hálózat végén a térbeli felbontás -re csökken, a csatornaszám , így az első teljesen összekötött réteg bemenete elem. Ha az első FC réteg neuront tartalmaz, akkor annak súlymátrixa önmagában millió paramétert ad, ami a hálózat paramétereinek döntő többsége. Ez a költség motiválta a későbbi architektúrákban a globális átlag-poolingot, de ez már a 19.2. MobileNet és inverted residual és későbbi egységek témája. Itt a VGG kapcsán annyit rögzítünk: a konvolúciós rétegekben a kis kernelek csökkentik a paraméterszámot, a teljes paraméterköltség viszont a FC fejben összpontosul.
Gyakran hallani, hogy „két -as réteg ekvivalens egy -ös réteggel”. Ez csak a recepciós mezőre igaz. A paraméterszámra sem igaz, ahogy a lemmában láttuk, és főleg az outputra nem igaz, ha a rétegek között ReLU áll.
Ellenpélda. Legyen egy egycsatornás kép, amelynek középső pixelértéke , minden más eleme . Az első -as kernel középső súlya legyen , a többi , padding , bias . Ekkor az első réteg kimenetének középső pozíciójában az érték , a többi pozíción . A ReLU után a középső érték . A második -as kernel minden súlya , padding , bias . A második kimenet középső pozíciója a bemenő kép középső -as ablakának összege; ott egyetlen nemnulla érték a , tehát a kimenet .
Ha létezne olyan -ös lineáris kernel, amely ezzel a stackkel minden bemenetre megegyezik, akkor a fenti inputcsaládon a kimenet alakú lenne valamilyen -rel. Ekkor -re , -re pedig lenne, ami ellentmondás. A stack tehát nem lineáris leképezés, így nem lehet egyetlen lineáris konvolúcióval azonos.
Ha a ReLU-t elhagyjuk, akkor a bias nélküli kompozíció valóban lineáris, és a bemenetre egyetlen effektív kernelként hat; de a VGG-blokk éppen a ReLU beiktatásával válik mély nemlineáris reprezentációvá.
Ellenőrizzük a lemmát -re: a stack paraméterszáma , az -ösé , a különbség , ami a képletből . A recepciós mező mindkettőnél . A kimeneti méret padding nélkül -es bemeneten mindkét blokkra. A kernelstack definíciójában a ReLU a 13.3. Lokális szűrők és tanult reprezentáció affin linearitási ellenpéldájához hasonlóan töri meg a homogenitást: ott a biasos művelet tette affinná a leképezést, itt a ReLU teszi darabonként lineárissá. A 16.3. Elméleti és effektív recepciós mező rekurzióban a padding valóban nem szerepel a mezőképletben, csak a stride és a dilation. Végül az 5.3. Mintavételi bizonytalanság és intervallum tanulsága szerint ha a labor két blokkjának kimenetét összehasonlítjuk, az eltérés egyetlen seedből származó véletlen érték, nem statisztikai állítás a két architektúra minőségéről.
F1 (fogalmi, nehézség 1). Magyarázza el, mi a különbség a recepciós mező és a paraméterszám között, és miért nem elegendő a kettő egyezése ahhoz, hogy két blokkot ekvivalensnek nevezzünk. Térjen ki a ReLU szerepére. Elvárt eredmény: rövid, önálló szöveg, amely a két fogalmat definiálja, és az ellenpélda gondolatát saját szavakkal megismétli.
F2 (levezetési, nehézség 1). Adott csatorna, stride 1, dilation 1, bias minden rétegben. Számítsa ki három egymás utáni -as stack és egyetlen -es réteg elméleti recepciós mezőjét és paraméterszámát. Ellenőrizze, hogy a megtakarítás mintájára milyen képlet adódik. Adja meg a kimeneti méretet is egy -es bemenetre padding nélkül. Elvárt eredmény: a kapott számok, a rekurzió lépései és az alakellenőrzés.
F3 (implementációs, nehézség 2). Írjon
Python-függvényt, amely bemenetként megkapja a kernelek listáját
k_list, a stride-ok listáját s_list, a
dilation listáját d_list, a csatornaszámot C
(minden réteg be- és kimenete), valamint egy bias logikai
értéket. A függvény adja vissza az elméleti recepciós mezőt és a teljes
paraméterszámot. Tesztelje a k_list=[3,3],
s_list=[1,1], d_list=[1,1], C=4,
bias=True esetre; az eredmény RF
,
paraméter
legyen. Elvárt eredmény: futtatható kód, a teszt kimenete és a függvény
forrásszövege.
F4 (hibakeresési, nehézség 2). Az alábbi modell állítólag a VGG-style -as stacket valósítja meg:
class Stack(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(1, 1, 3, padding=1)
        self.conv2 = nn.Conv2d(1, 1, 3, padding=1)

    def forward(self, x):
        return self.conv2(self.conv1(x))
Lokalizálja a hibát, adja meg a következményt, javítsa a
forward metódust, és adjon egy numerikus ellenőrzést, amely
két ellentétes előjelű bemeneten mutatja, hogy a javított modell
nemlineáris. Elvárt eredmény: a hibás rész megnevezése, a javított kód,
és a teszt kimenetének leírása.
F5 (kísérleti tervezés/transzfer, nehézség 3). Tervezzen kísérletet a GlyphLab adaton arra a kérdésre, hogy egy -as stack jobb-e, mint egyetlen -ös réteg az orientációklasszifikációban. Adja meg a megfigyelési egységet, a spliteket, a baseline-t, a változó tényezőt, a metrikát, a seed- és checkpoint-kezelést, valamint az érvényességi korlátot. A válasz nem kérhet előre megadott győztest. Elvárt eredmény: protokollterv, a lehetséges alternatív értelmezések felsorolása.
F1 megoldás. A recepciós mező az a bemeneti halmaz, amelytől egy kimeneti neuron értéke elvileg függhet; hosszát a 16.3. Elméleti és effektív recepciós mező rekurzió adja. A paraméterszám a modell tanulható skalárjainak száma: rétegenként bias-szal. Az egyező RF azt mondja, hogy ugyanazt a bemeneti tartományt olvassák, de a függvény alakja eltérhet. A ReLU megtöri a homogenitást: általában, míg egy lineáris leképezésre mindig . A szakasz ellenpéldájában a középső pixel értékére a stack -t ad, ami nem lineáris; tehát az RF-egyezés nem ekvivalencia.
F2 megoldás. Három -as rétegre a rekurzió: A stride 1 miatt minden -re, így az RF . Egyetlen -es réteg RF-je , tehát egyezik. A paraméterszám: -ra: a megtakarítás . A különbség általános képlete , ami -re pozitív. A kimeneti méret -es bemeneten padding nélkül: három -as után , azaz ; egyetlen -es után , azaz ugyanaz. Alakellenőrzés: a kernelstack minden közbülső kimenete csatornás, így a paraméterképlet konzisztens.
F3 megoldás.
def stack_rf_params(k_list, s_list, d_list, C, bias=True):
    J = 1
    F = 1
    total = 0
    for k, s, d in zip(k_list, s_list, d_list):
        F = F + (k - 1) * d * J
        J = J * s
        total += C * (C * k * k + (1 if bias else 0))
    return F, total

rf, params = stack_rf_params([3, 3], [1, 1], [1, 1], 4, True)
print(rf, params)   # 5 296
Ellenőrzés:
,
;
paraméter mindkét rétegre
,
összesen
.
A függvény szélső esete: ha k_list üres,
,
total=0, ami a bemeneti réteg RF-jét és paraméterszámát
adja.
F4 megoldás. A hiba a forward
metódusban van: hiányzik a ReLU a két konvolúció között. Következmény: a
modell lineáris, tehát két lineáris konvolúció kompozíciójaként egyetlen
effektív kernelre redukálható, és nem VGG-style stack. A javítás:
def forward(self, x):
    return self.conv2(torch.relu(self.conv1(x)))
Numerikus ellenőrzés: generáljunk két -as tenzort, az egyik középső pixel , a másik középső pixel , a többi . A javított modell kimenetének középső pozíciójában a bemeneti -re pozitív, -re nulla vagy eltérő érték adódik, míg a lineáris kompozícióra az értékek egymás negatívjai. A teszt futtatásakor a javított modell és értéke nem lesz egymás ellentettje, ami a nemlinearitást igazolja; a régi modellre viszont teljesül.
F5 megoldásminta. A protokoll a következő lehet. A
megfigyelési egység a scene_id, mert a két nézet ugyanahhoz
a jelenethez tartozik; a split a GlyphLab metadata.csv
szerinti train/val/test, osztályonkénti jelenetszám
.
A baseline egyetlen
-ös
konvolúciós blokk: Conv(1→8, 5×5, padding 2), ReLU, MaxPool(2×2), majd
egy FC fej. A változó tényező a konvolúciós blokk szerkezete: a
kísérleti modell Conv(1→C, 3×3, padding 1), ReLU, Conv(C→8, 3×3, padding
1), ReLU, MaxPool, azonos FC fejjel. A C értéket úgy
választjuk meg, hogy a konvolúciós blokk paraméterszáma a lehető
legközelebb legyen a baseline
-hoz;
például
esetén
,
ami nem azonos, ezért a paraméterkülönbséget a riportban expliciten
közöljük. A tanítás CPU-n, float32, Adam vagy SGD kereszt-entrópiával,
5-10 seeddel. A választás a legjobb val loss alapján történik, a tesztet
csak a végén értékeljük, a corrupt tesztet külön, párosítva. A metrika a
teszt accuracy; a seedek közötti szórást is jelentjük. Érvényességi
korlát: a GlyphLab szintetikus, a paraméterszám nem pontosan egyezik, és
az egyetlen adathalmazon mért különbség nem általánosítható természetes
képekre. Az F5 tehát tervet és nem garantált eredményt ad; negatív
eredmény is értékes.
A két egymás utáni -as, stride 1 konvolúció elméleti recepciós mezője , pontosan akkora, mint egyetlen -ösé. Azonos bemeneti és kimeneti csatornaszám mellett a stack paraméterszáma , az -ösé , tehát a mélyebb változat kevesebb súlyt használ. A megtakarítás azonban nem jelenti a függvények lineáris ekvivalenciáját, mert a közbeiktatott ReLU nemlinearitást visz be; ezt egy egycsatornás ellenpélda igazolja. A VGG ezt az elvet használja, és a paraméterköltség jelentős része a teljesen összekötött fejben összpontosul. A labor két blokk forwardját és dokumentált kapacitását ellenőrzi.
A 17.4. Architektúra összehasonlítása kontrollált keretben egység architektúrákat hasonlít össze kontrollált keretben: a VGG, AlexNet és LeNet közötti különbségeket nem csupán leíró módon, hanem azonos adaton, azonos kereszt-entrópiával, rögzített seedekkel és dokumentált paraméterszámmal méri. Az itt levezetett paraméter- és RF-számítás ott alapellenőrzésként szolgál.