A 19.1. Depthwise separable és pointwise réteg egységben szétválasztottuk a térbeli és a csatornakeverő operátort, és levezettük, hogy a depthwise separable kompozíció paraméter/MAC aránya a teljes konvolúcióhoz képest . Itt azt vizsgáljuk, hogyan rendezhető el ez a két művelet egy olyan reziduális blokkban, amelynek a bemenete és kimenete vékony, a köztes reprezentációja viszont széles. Ehhez a 18.1. Reziduális blokk és identitásút reziduális gondolatát, a 18.2. Batch normalization train és eval módban BatchNorm-életciklusát és a 15.2. Inputgradiens és átfedő recepciós mezők depthwise gradienst használjuk fel; osztályozási cél esetén a 7.2. Softmax és többosztályos cross-entropy logitos cross-entropy konvencióját.
Induló becslés. Egy 16 csatornás -as feature mapon egy -as teljes konvolúció súlyt használ. Ha a 16 csatornát egy -es réteggel 48-ra növeljük, a depthwise szűrő súlyt igényel, a visszavetítő pedig súlyt. Az inverted residual tehát nem attól takarékos, hogy a belső réteg széles; a nyereség abból jön, hogy a blokk határán lévő vékony reprezentációk közötti szomszédos blokkok -es csatornakeverései olcsók, a drágább térbeli szűrés pedig csatornánként szétválasztva fut a széles köztes téren.
A MobileNetV2 központi tervezési elvei az inverted residual, a linear bottleneck és az expanzió [P09]. Az eredeti blokk és a labor saját, egyszerűsített blokkja a [P09] alapján (3.2–3.3. szakasz, 2–3. o.; 1. táblázat és 4. fejezet, 4. o.; 2. táblázat és 4(d) ábra, 5. o.):
| Elem | MobileNetV2 [P09] | Labor (InvertedResidual) |
|---|---|---|
| expanzió | konvolúció , ReLU6 | konvolúció , BatchNorm, ReLU |
| köztes réteg | depthwise, stride , ReLU6 | depthwise, stride , BatchNorm, ReLU |
| projekció | lineáris konvolúció, aktiváció nélkül | lineáris konvolúció, BatchNorm, aktiváció nélkül |
| expanziós faktor | a fő kísérletekben, az első réteg kivételével állandó; közel azonos eredményt ad | (kis CPU-s demó) |
| normalizálás | BatchNorm minden réteg után | BatchNorm minden konvolúció után |
| shortcut | stride 1 blokkban (4(d) ábra), egyező be- és kimeneti csatornaszámnál | use_skip = (stride == 1) and (cin == cout) |
| aktiváció | ReLU6, alacsony pontosságú számítás melletti robusztusság miatt | nn.ReLU (paraméterként cserélhető) |
A saját blokk tehát oktatási egyszerűsítés, nem a közölt hálózat reprodukciója: más expanziós faktort és aktivációt használ, és csak egyetlen blokkot vizsgál, nem a 2. táblázat 19 reziduális bottleneck rétegét.
A következő specifikáció didaktikai szerződés; a [P09] (absztrakt és 3.3. szakasz) szerint a be- és kimeneti reprezentáció thin bottleneck, a köztes expanziós rétegben lightweight depthwise szűrők dolgoznak, a linear bottleneck pedig a kis dimenzióban információt romboló nemlinearitást kerüli.
Definíció (expanziós réteg). Legyen és az expanziós faktor. Az expanzió -es konvolúció, amelynek súlyalakja ; kimenete . A minden kimeneti csatornája a bemeneti csatornák lineáris kombinációját adja azonos térbeli pozícióban.
Definíció (köztes depthwise szűrő). A köztes csatornán méretű depthwise konvolúció fut, stride , szimmetrikus zero padding , . A [D10] szerint ez keresztkorreláció; a súlyalak .
Definíció (lineáris bottleneck). A záró -es projekciós réteg csatornát vetít, . A projekció után nem alkalmazunk nemlinearitást; az aktivációs függvény és a normalizálás esetleges további elrendezése a konkrét modell receptjéhez tartozik, a döntő pont az, hogy a csatornacsökkentő kimenetén a vékony reprezentációt nem törjük meg ReLU-val.
Definíció (inverted residual). A 18.1. Reziduális blokk és identitásút hagyományos reziduális blokk széles be- és kimenettel dolgozik, és középen szűkít. Az inverted residual ezt megfordítja: a be- és kimenet vékony ( és ), a köztes expanzió széles (), a shortcut pedig a vékony reprezentációkat köti össze: , ha az alakok ezt megengedik. A [P09] absztraktjában ez az „input and output of the residual block are thin bottleneck layers” megfogalmazás saját szavas összegzése.
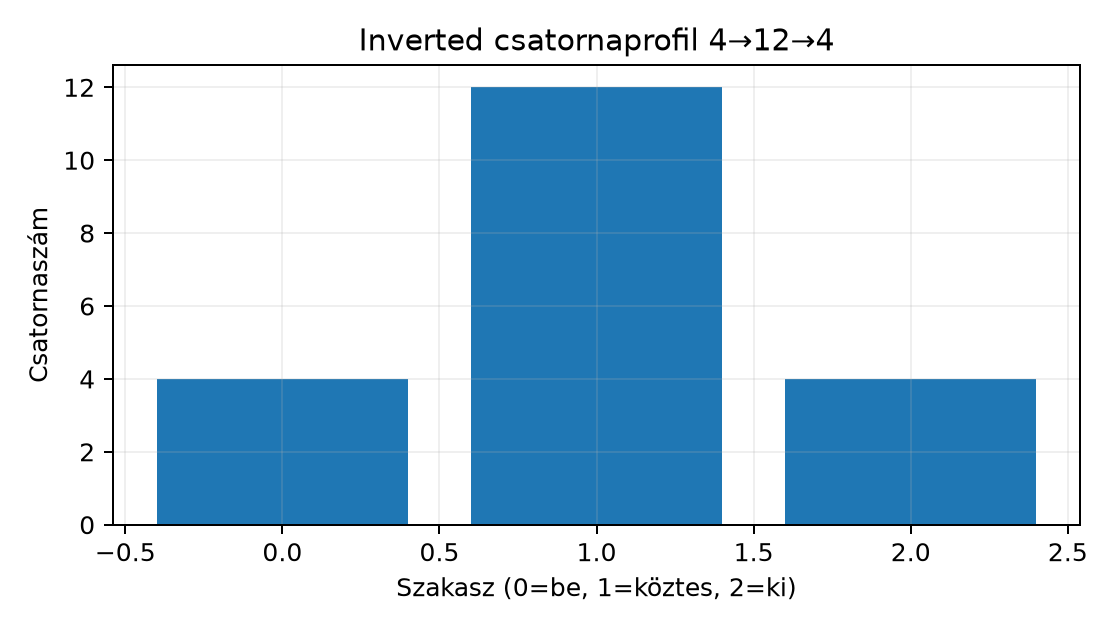
A csatornaprofilok egy , példán:
A width multiplier (szélességi szorzó) olyan globális skálázó tényező, amely a hálózat vékony csatornaszámait szorozza: , , a köztes expanzió pedig lesz. A téralakok változatlanok; megváltoztatása tehát nem érinti a skip téralak-feltételét, csak a csatornaszámokat.
A width multipliert ne keverjük az expanziós faktorral: egy blokkon belüli szélességarány, a hálózat egészére ható erőforrás-skála. és esetén a köztes csatornaszám a képletekben; a megvalósítás ilyenkor kerekítési konvenciót igényel, ezért a labor egész értékeket használ, vagy a kerekítést expliciten rögzíti. A [P10] absztraktja a width, depth és resolution együttes, koherens skálázását vizsgálja; a width multiplier ehhez kapcsolódó eszköz, a pontos MobileNetV2-beli értéktáblázat a [P09] teljes szakaszának ellenőrzését igényli.
Lemma (inverted residual blokk alakja, paraméter- és MAC-költsége, skip-feltétele). Legyen . Az inverted residual blokk három konvolúcióból áll: expanzió , majd depthwise szűrő , stride , szimmetrikus padding , dilation nélkül, végül projekció . A konvolúciós biast nullának vesszük; BatchNorm esetén annak affin paramétereit külön számoljuk. Ekkor:
és ugyanígy -ből; a [D10] képlete mellett. 3. A projekció kimenete . 4. A skip pontosan akkor alkalmazható e specifikációban, ha a rövid út és a főág alakja azonos: , , és a padding biztosítja , . Ellenkező esetben az összeadás vagy hibát ad, vagy nem értelmezhető az adott specifikációban. 5. A konvolúciós súlyparaméterek száma bias nélkül
a MAC-szám pedig
Ha és mérettartó paddinggel, akkor
Bizonyítás. Mindhárom réteg a [D10] közölt keresztkorrelációs specifikációját követi. Az expanzió bemeneti csatornaszáma , kimeneti , kernel ; mivel a kernel nem nyúl túl a térbeli pozíción, a kimeneti téralak . A depthwise beállítás azt jelenti, hogy minden bemeneti csatornához pontosan egy kimeneti csatorna tartozik, ezért a súlyalak . A kimeneti méret a [D10] képlete esetén. A projekció kernel , így a téralak marad, a csatornaszám . A (4) állítás az elemenkénti összeadás alakfeltételéből következik: csak akkor értelmes, ha mind a négy dimenzió megegyezik; mivel itt -et a stride/padding páros határozza meg, és szükséges. A paraméterszámok: az expanzió , a depthwise , a projekció szorzata; a MAC minden kimeneti elemenként a kernel bemeneti elemszáma, ezért az expanzió szorzás-akkumulációt ad, és így tovább. Ezzel a lemma bizonyított; ez saját levezetés, nem a [P09] tétele.
Következmény. A skip alkalmazhatósága a réteggráfon lokálisan ellenőrizhető: meg kell nézni a blokk be- és kimeneti csatornaszámát, a depthwise stride-ját és a téralak-megőrző paddinget. Stride esetén a rövid út kihagyandó, mert a főág downsamplinget hajt végre.
Legyen , , , , , , . Ekkor az alakok:
Skip: alkalmazható, mert , , és a , padding téralak-tartó. Paraméterek: . MAC: az expanzió ; a depthwise ; a projekció ; összeg .
Stride esetén ugyanezzel a bemenettel , a projekció kimenete . A skip nem alkalmazható, mert a rövid út alakú, a főág ; az elemenkénti összeadás shape hibát ad. Ha de , stride mellett a téralak egyezne, de a csatornaszám nem; e specifikációban szintén nincs skip, mert vetítő shortcutot nem vezettünk be.
A labor egyetlen fájl,
lab/n074/inverted_residual_demo.py. Cél: a blokk
implementálása, a stride
és
shape-ellenőrzése, valamint a konvolúciós paraméterszám összevetése a
kézi 204 értékkel. A BatchNorm a 18.2. Batch
normalization train és eval módban szerint train módban
batchstatisztikát számol; a shape-re nincs hatása, ezért a labor
shape-kontrollja a BN állapotától független, de a modell kiértékeléséhez
később eval() mód kell.
# lab/n074/inverted_residual_demo.py
import torch
import torch.nn as nn

class InvertedResidual(nn.Module):
    """Didaktikai inverted residual, lineáris bottleneck-tel.

    F(X) = Project(Act(BN(DW(Act(BN(Expand(X)))))))
    Y    = F(X) + X, ha stride == 1 es cin == cout.
    """

    def __init__(self, cin, cout, expand=3, stride=1, activation=nn.ReLU):
        super().__init__()
        self.use_skip = (stride == 1) and (cin == cout)
        hidden = expand * cin
        self.conv = nn.Sequential(
            nn.Conv2d(cin, hidden, 1, bias=False),   # expanzió
            nn.BatchNorm2d(hidden),
            activation(),
            nn.Conv2d(hidden, hidden, 3, stride=stride,
                      padding=1, groups=hidden, bias=False),  # depthwise
            nn.BatchNorm2d(hidden),
            activation(),
            nn.Conv2d(hidden, cout, 1, bias=False),  # projekció, utána NINCS aktiváció
            nn.BatchNorm2d(cout),
        )

    def forward(self, x):
        y = self.conv(x)
        if self.use_skip:
            return y + x
        return y


def conv_params(module):
    """Csak a Conv2d súlyparaméterek száma, a BatchNorm affin paraméterei nélkül."""
    total = 0
    for m in module.modules():
        if isinstance(m, nn.Conv2d):
            total += sum(p.numel() for p in m.parameters())
    return total


def main():
    torch.manual_seed(20261020)
    x1 = torch.randn(1, 4, 8, 8, dtype=torch.float32)
    x2 = torch.randn(1, 4, 8, 8, dtype=torch.float32)

    m1 = InvertedResidual(4, 4, expand=3, stride=1)
    m2 = InvertedResidual(4, 4, expand=3, stride=2)

    y1, y2 = m1(x1), m2(x2)
    # A lemmából számított alakok; a futás assert-tel ellenőrzi.
    assert y1.shape == torch.Size([1, 4, 8, 8])
    assert y2.shape == torch.Size([1, 4, 4, 4])
    assert m1.use_skip is True
    assert m2.use_skip is False
    # Konvolúciós súlyok: 3*4*(4+9+4)=204; teljes modell ennél több a BN miatt.
    assert conv_params(m1) == 204
    print("y1 shape:", tuple(y1.shape))
    print("y2 shape:", tuple(y2.shape))
    print("conv params m1:", conv_params(m1))
    print("total params m1:", sum(p.numel() for p in m1.parameters()))

if __name__ == "__main__":
    main()
Futtatás a lab könyvtárból:
cd lab/n074
python inverted_residual_demo.py
A lab-profilban (PyTorch 2.14.1+cpu) mért kimenet:
y1 shape: (1, 4, 8, 8),
y2 shape: (1, 4, 4, 4), conv params m1: 204,
total params m1: 260; minden assert teljesült.
A teljes paraméterszámban a három BatchNorm affin paraméterei is benne
vannak: a két rejtett
(
csatornás) BatchNorm
,
a kimeneti
()
,
így
.
A labor a konvolúciós 204 értéket ellenőrzi, hogy a lemmával
összevethető legyen.
F1 (fogalmi, nehézség 1). Magyarázza el saját szavakkal, mit jelent az expanzió, a lineáris bottleneck és az inverted residual. Adja meg a csatornaprofilt , esetén. Mitől „fordított” ez a 18.1. Reziduális blokk és identitásút hagyományos reziduális blokkjához képest? Egy ellenpéldával mutassa meg, hogy a 19.1. Depthwise separable és pointwise réteg depthwise separable sorozat önmagában még nem inverted residual. Átadandó: legfeljebb fél oldal, a három definíció, a profil és az ellenpélda.
F2 (levezetési, nehézség 2). Adott , , , , , , , bias nélkül. Számolja ki az összes köztes tenzoralakot, értékét, a konvolúciós paraméterszámot és a MAC-et. Döntse el a skip alkalmazhatóságát, és írja fel az általános skip-feltételt. Átadandó: lépésenkénti levezetés alakellenőrzéssel és a skip indoklásával.
F3 (implementációs, nehézség 2). Módosítsa a
laborblokkot úgy, hogy a main() függvény a fenti
,
,
,
stride
esetre is lefusson, és assert-ekkel ellenőrizze a kimeneti
alakot, a use_skip értékét és a konvolúciós
paraméterszámot. Átadandó: teljes futtatható kód, parancs, a
várt értékek.
F4 (hibakeresési, nehézség 2). Az alábbi két hiba közül válasszon egyet, lokalizálja, írja le az okát és következményét, javítsa, és adja meg a visszaellenőrzés lépését.
# A) hibás skip: a stride-ot figyelmen kívül hagyja
self.use_skip = True
# B) hibás bottleneck: a projekció után is aktiváció fut
nn.ReLU(),
nn.Conv2d(hidden, cout, 1, bias=False),
nn.ReLU(),
Átadandó: diagnózis, javított kódrészlet, ellenőrző futtatás várt eredménye.
F5 (kísérleti/transzfer, nehézség 3). Tervezzen GlyphLab-kísérletet a width multiplier hatására: baseline és változat, minden más rögzített. Használja a 7.2. Softmax és többosztályos cross-entropy logitos cross-entropy konvencióját és a GlyphLab scene-szintű splitjét. Átadandó: kérdés, hipotézis, adat/split, baseline, változó tényező, metrika, best-checkpoint szabály, CPU erőforrás becslés és konkrét érvényességi korlát.
F1. Az expanzió -es csatornanövelés ; a lineáris bottleneck a projekciós utáni nemlinearitás elhagyása, hogy a vékony reprezentációt ne törje meg aktiváció; az inverted residual vékony be/kimenettel és széles köztes réteggel dolgozik, a shortcut a vékony reprezentációkat köti össze. , profil: . A 18.1. Reziduális blokk és identitásút hagyományos blokkja ezzel szemben széles határral és szűk középpel dolgozik; a „fordított” jelző erre a megcserélt profilra utal. A 19.1. Depthwise separable és pointwise réteg depthwise separable sorozat például csatornamenetet adhat, de nincs vékony–széles–vékony profil és nincs reziduális összeadás; tehát nem inverted residual.
F2. Bemenet . Expanzió: , kimenet . Depthwise , , :
kimenet . Projekció: . Skip nem alkalmazható, mert a rövid út , a főág ; az általános feltétel az alakazonosság: , és téralak-tartó padding mellett . Paraméterek: . MAC: expanzió ; depthwise ; projekció ; összeg . A kimeneti téralak páros bemenetre pontos; páratlan esetén a floor-képlet adná a helyes értéket.
F3. A megoldás kiegészített
main-részlete:
def main_extended():
    torch.manual_seed(20261020)
    x = torch.randn(2, 8, 16, 16, dtype=torch.float32)
    model = InvertedResidual(8, 8, expand=2, stride=2)
    y = model(x)
    assert y.shape == torch.Size([2, 8, 8, 8])
    assert model.use_skip is False
    assert conv_params(model) == 400
    print("F3 OK:", tuple(y.shape), conv_params(model))
A teljes fájl úgy futtatható, hogy ezt a függvényt is meghívjuk a
main() után. A várt paraméterszám 400 az F2-ből; a shape
pedig
.
F4. Az A) hiba oka: a use_skip
engedélyezése stride
mellett is; következménye a forwardban y + x kísérlet, ahol
a főág
,
a rövid út
;
a PyTorch ilyenkor shape-mismatch hibát ad (a batch mérettől
függetlenül), vagy véletlen broadcast esetén szemantikailag hibás
eredményt. Javítás:
self.use_skip = (stride == 1) and (cin == cout).
Visszaellenőrzés: stride
modellre forward hívás shape-asserttel, stride
modellre a skip aktív. A B) hiba: a projekció után ReLU megtöri a
lineáris bottleneck definíciót; a kis csatornaszámú kimenet további
nemlinearitása pont azt a kockázatot hozza be, amelyet a [P09]
absztraktja szerint a terv elkerül. Javítás: az utolsó ReLU törlése;
visszaellenőrzés a blokk modullistájának vizsgálatával, hogy az utolsó
konvolúció után csak BatchNorm áll.
F5. Minta terv. Kérdés: csökkenti-e
a GlyphLab top-1 pontosságát, és hogyan változik a korrupt teszt páros
romlása? Hipotézis: a width csökkentése rontja a kapacitást, de kis
adaton a regularizáló hatás részben ellensúlyozhat. Adat: GlyphLab
data/images.npy, a rögzített scene-split; a modell
kiválasztása csak a train/val spliten, a végső teszten egyszer. Változó
tényező:
;
baseline az
azonos architektúra. Metrika: top-1 accuracy; a korrupt tesztet
párosítva a clean testtel. Best checkpoint: legalacsonyabb val loss; a
7.2. Softmax és többosztályos cross-entropy
szerint logitos CrossEntropyLoss, int64 target. Erőforrás:
CPU, kis batch, például 32, a GlyphLab 24×24-es mérete miatt néhány ezer
lépés. Korlát: a GlyphLab nem természetes képi benchmark; egy seed nem
általánosítható, a width hatása a kis szélességek mellett kerekítésfüggő
lehet; a korrupt teszt csak a befagyasztott modellen értékelhető.
A MobileNet-család verzióit nem szabad részletezés nélkül összemosni. A MobileNetV1 szellemiségéhez a 19.1. Depthwise separable és pointwise réteg depthwise separable oszlopa áll közel; a MobileNetV2 a [P09] 3.2–3.3. szakasza szerint az inverted residual és linear bottleneck fogalmát vezeti be. Ha valaki azt mondja, hogy „a MobileNetV2 csak depthwise separable konvolúciók egymásutánja”, az ellenpélda a shortcut: a vékony–széles–vékony profil reziduális összeadása nem következik a separable kompozíció puszta definíciójából. Hasonló hiba a width multiplier és az expanziós faktor felcserélése: az egész hálózat vékony csatornaszámait skálázza, pedig egy blokk belső szélességét; a kettő szorzata , nem pedig az „felezése” önmagában. A MobileNet további változatairól (V1, V3) e kézirat nem ad részletes blokkreceptet; a fenti táblázat csak a [P09]-ben ellenőrzött V2-blokkra vonatkozik.
Ellenőrizze, hogy (1)
esetén a blokk profilja
;
a depthwise továbbra is csatornánként szűr, és a shortcut feltétele a
szokásos stride/padding szabály. (2)
,
,
,
esetén a skip nem alkalmazható a csatornaeltérés miatt;
az x + y shape hibát adna. (3) Stride
mellett a depthwise downsamplingje után a projekció
már nem változtatja a téralakot, ezért a stride-ot a középső rétegben
kell keresni. Visszahívás a 18.2. Batch
normalization train és eval módban egységből: a BatchNorm train
módban batchstatisztikát és futó buffert frissít, eval módban a running
statisztikát használja; a blokk shape-lemmája ettől független, de egy
tényleges tanítási kísérletben a módváltást a checkpoint-protokollal
együtt kell rögzíteni. A 15.2. Inputgradiens és
átfedő recepciós mezők egységből: a depthwise visszafelé menetben
csatornánként scatter-add zajlik, az
-es
rétegek pedig csatornakeverő gradienst szállítanak. A 7.2. Softmax és többosztályos cross-entropy
egységből: osztályozási fej logitsot adjon, cél int64, softmaxot ne
tegyünk a loss elé.
Az inverted residual blokk vékony be- és kimeneti reprezentációk közé széles, depthwise szűrővel feldolgozott expanziót illeszt; a projektáló utáni nemlinearitás elhagyása a lineáris bottleneck. A lemmában levezettük az összes köztes alakot, a paraméter- és MAC-képleteket, valamint a skip alakfeltételét: , stride és téralak-tartó padding. A , -as példán a konvolúciós paraméterszám , a MAC ; stride esetén a skip nem alkalmazható. A width multiplier a vékony csatornákat globálisan skálázza, és nem azonos az expanziós faktorral. A labor PyTorchban ellenőrzi a shape-eket és a 204 súlyt; a futás e kéziratban nem elvégzett, a kimenet számított.
A 19.3. EfficientNet és architektúraskálázás egység az EfficientNet [P10] megközelítését tárgyalja: ott a width, depth és resolution együttes, koherens skálázását vizsgáljuk, ami a width multiplier itteni fogalmát hálózatszintű keresési problémává bővíti. A 19.4. ConvNeXt és a recept/architektúra elválasztása ConvNeXt-egység pedig a modernizált CNN-recepteket választja el az architektúra nevének puszta említésétől [P11].