A 19.2. MobileNet és inverted residual egységben a MobileNetV2 inverted residual blokkját és a width multiplier fogalmát vizsgáltuk. Ott a width multiplier egyetlen beállítás volt; most azt kérdezzük, hogyan skálázzuk együtt egy CNN mélységét, szélességét és bemeneti felbontását. Előismeret: a konvolúciós réteg MAC-számítása 14.3. Paraméterszám, MAC és aktivációmemória, a normrétegek paraméterezése 18.3. Pre-activation, kis batch és alternatív normalizálás, valamint az osztályozási loss-szerződés 7.3. Bináris, multilabel és regressziós cél. Induló becslés: ha egy hálózat minden csatornaszámát kétszerezzük, vajon a paraméterszám és a műveletszám is kétszereződik?
Legyen egy baseline CNN darab kernelű, stride 1-es, azonos térbeli alakot megőrző paddinges, groups=1 konvolúciós rétege. A bemeneti kép , az -edik réteg bemeneti és kimeneti csatornaszáma és . A bemeneti képbatch NCHW alakú [D10].
A három skálázási dimenziót szorzókként értelmezzük:
A skálázott modell csatornáit -ként értelmezzük; valós esetén a tényleges implementáció egészre kerekít, de a költségmodellben valós szorzóval dolgozunk.
Állítás (a rögzített bemeneti csatornaszám hatása).
Jelölje
a rögzített bemeneti csatornaszámú első konvolúció,
pedig az utána következő, csatornák között skálázott konvolúciók
baseline-MAC-ját. Ekkor
.
Tegyük fel, hogy a konvolúciók groups=1 típusúak, a térbeli
méret mindkét tengelyen
-szeresére
nő, és a csatornaszám-kerekítést figyelmen kívül hagyjuk. Ha a belső
csatornaszámok
-szeresükre
nőnek, változatlan mélység mellett a pontos skálázási
képlet:
Ha a hálózatot ezenfelül olyan, alakkompatibilis belső blokkok ismétlésével mélyítjük, amelyek egy példányának alap MAC-ja , és amelyek között nem kell további illesztőréteg, akkor az erre a külön megadott építési szabályra érvényes képlet:
Valós architektúrákban a depth skálázása új átmeneti vagy downsampling rétegeket igényelhet, ezért az utóbbi képlet ott közelítés, nem univerzális azonosság.
Indoklás. Egy standard keresztkorrelációs réteg MAC-ja . A belső rétegekben mindkét csatornadimenzió -vel, a térbeli dimenziók szorzata -tel változik, tehát a költség -szeres. Az első réteg bemeneti csatornaszáma viszont rögzített (például RGB-nél 3), így ott a költség -szeres. Alakkompatibilis belső blokk -szeres ismétlése további tényezőt ad, míg az első réteg egyszer szerepel. A két költséget összeadva kapjuk a formulát.
A széles körben használt szabály ezért csak közelítés. Ebben az egyszerű modellben a hozzá viszonyított eltérés:
, esetén a közelítés relatív hibája mellett nem nullához tart, hanem -hoz. A rögzített bemeneti csatornaszámú első réteg tehát akkor hanyagolható el, ha már a baseline költségéből is kis részt képvisel, nem pusztán attól, hogy a hálót szélesítjük. A bias-műveletek és BatchNorm paraméterei nem szerepelnek a konvolúciós MAC ezen definíciójában. A belső konvolúciók súlyparamétereinek költsége hasonló okból -tel változik, de a teljes modell pontos paraméterszámához a stemet, a fejet és a normalizálást külön hozzá kell adni.
Az iménti költségállítás csak a műveletszámot írja le; abból nem következik, hogy milyen arány adja a legjobb pontosságot adott mellett. A [P10] absztraktjában ellenőrzött állítás szerint a szerzők azt találták, hogy a mélység, szélesség és felbontás kiegyensúlyozott, együttes skálázása jobb hatékonyságú modelleket adhat, mint egyetlen dimenzió növelése.
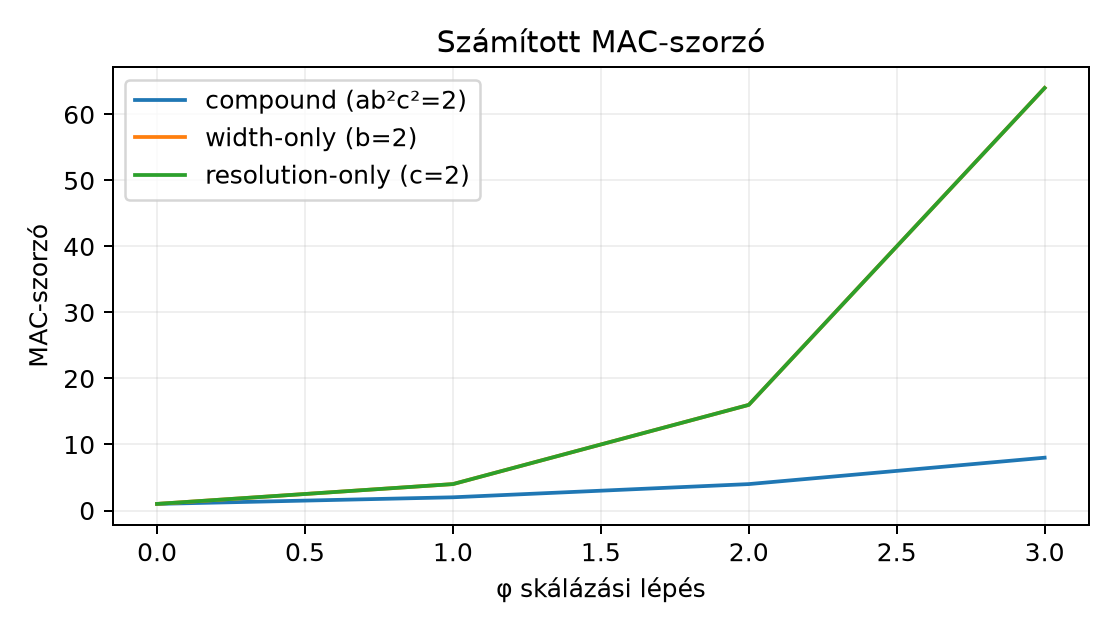
A módszer elterjedt paraméterezése az alábbi alakot használja. Egy compound coefficient és három pozitív, a keresés során rögzített arány mellett
ahol a baseline skálát jelöli. A fenti egyszerűsített, belső rétegek dominanciájára építő költségmodell szerint a MAC-szorzó közelítőleg
tehát ha egy lépésben eggyel nő, és az feltételt választják, akkor a modell MAC-ja lépésenként körülbelül kétszereződik. Státusz: ez az algebrai szerkezet a fenti költségmodellből származtatható, de az, hogy mely értékek optimálisak, empirikus keresési eredmény, nem elméleti optimumtétel. A konkrét arányokat itt nem tételezzük fel, mert a választásuk adatokhoz és implementációhoz kötött empirikus keresés tárgya. Az alábbi ábra képletből számolt szemléltetés: a depth-only, width-only és resolution-only stratégia eltérő MAC-görbéje.
Vegyünk egy -as, 3 csatornás bemenetű baseline modellt négy konvolúciós réteggel: , , , , mind same padding, stride 1. Az egyes rétegek MAC-ja:
tehát . Válasszunk , , skálázást. Az egyszerűsített becslés . A pontos érték, az első réteg alakjával számolva: . A közelítő hiba MAC, azaz körülbelül a pontos költséghez viszonyítva. Nagyobb esetén ez az arány nem szükségképpen csökken: -nél a tényleges költséghez viszonyított relatív hiba határértéke .
A labor két kis modellt hasonlít össze azonos bemeneten:
width=1.0 és width=1.4. A mérés CPU-n fut,
float32 dtype-tal, rögzített seed mellett. A kód a
lab/n075/ munkakönyvtárban futtatható:
# lab/n075/n075_scale_bench.py
import time
import torch
from torch import nn

def make_cnn(width, base=(16, 32, 64, 128), num_classes=10):
    ch = [max(1, int(c * width)) for c in base]
    layers, prev = [], 3
    for c in ch:
        layers += [nn.Conv2d(prev, c, 3, padding=1),
                   nn.BatchNorm2d(c), nn.ReLU()]
        prev = c
    layers += [nn.AdaptiveAvgPool2d(1), nn.Flatten(),
               nn.Linear(prev, num_classes)]
    return nn.Sequential(*layers)

def count_params(model):
    return sum(p.numel() for p in model.parameters())

def bench_forward(model, x, warmup=5, iters=30):
    model.eval()
    with torch.no_grad():
        for _ in range(warmup):
            model(x)
        t0 = time.perf_counter()
        for _ in range(iters):
            model(x)
        t1 = time.perf_counter()
    return (t1 - t0) / iters

torch.manual_seed(0)
x = torch.randn(4, 3, 24, 24, dtype=torch.float32)
for w in (1.0, 1.4):
    m = make_cnn(w)
    t = bench_forward(m, x)
    print(f"width={w:.1f} params={count_params(m):,} forward={1000*t:.2f} ms")
Jelölt, nem elvégzett kimenet: a fenti kézi arányból
várt nagyságrend width=1.0 esetén mintegy 99 210 paraméter,
width=1.4 esetén mintegy 190 000 paraméter; a forward idő
24×24-es CPU batch esetén jellemzően 1–20 ms, de ez hardverfüggő, és
mérési eredménynek nem tüntethető fel. Az összehasonlítás azonos gépen,
azonos folyamaton belül, melegítés és ismétlés mellett értelmes; small
batch esetén az időmérés zaját a melegítési és ismétlési szám
növelésével kontrolláljuk.
Protokoll. Kérdés: hogyan változik a méret és az
inference-idő a width növelésekor? Input: egy rögzített 4×3×24×24-es
véletlen float32 tensor; modellek: a fenti make_cnn két
width értékkel. Eszköz: helyi CPU, device="cpu",
torch.no_grad() és model.eval(). Seed:
torch.manual_seed(0) csak a bemenet és a súlyok
inicializálásához szükséges; a mérési zajt melegítés és 30 ismételt
forward átlaga kezeli. Parancs: python n075_scale_bench.py.
Ellenőrzés: a paraméterszámok az alábbi táblázatban várható, a futásidő
környezetfüggő.
| width | csatornák | várható paraméterszám | megjegyzés |
|---|---|---|---|
| 1.0 | 16, 32, 64, 128 | 99 210 | kézi számítás |
| 1.4 | 22, 44, 89, 179 | 190 731 | egészre kerekítve |
Az átadandó eredmény: a tényleges futás után a nyers mért időpár, a hányados, a PyTorch-verzió és a processzor azonosítója. A fenti táblázat számított, nem futtatott eredmény; a labor akkor vált ellenőrzötté, ha a hallgató saját környezetben rögzíti a nyers kimenetet.
F1 (fogalmi, nehézség 1). Magyarázza el, miért nem azonos a width multiplier és a MobileNetV2 expansion faktor . Adjon egy ellenpéldát, amelyben az egyik nő, a másik nem.
F2 (levezetési, nehézség 2). A fenti baseline MAC-ú modellre , , választást alkalmazunk. Vezesse le az egyszerűsített közelítő MAC-szorzót, majd az elméleti, alakkompatibilis belső blokk ismétlésének feltétele mellett a stem–body képlet szerinti MAC-ot. Adja meg a belső paraméterszorzót is.
F3 (implementációs, nehézség 2). Írjon függvényt
scale_estimate(M0, w, d, r), amely az egyszerűsített
költségbecslést adja vissza, majd ellenőrizze a
bemenetre a 2 764 800-as értéket. Tolerancia: relatív
.
F4 (hibakeresési, nehézség 2). Az alábbi kód a
MAC-szorzót lineárisnak számolja: cost = w*d*r*M0. Mi a
hiba, mi a következménye egy skálázási döntésben, és hogyan javítjuk?
Ellenőrizze az F3 példán.
F5 (kísérleti/transzfer, nehézség 3). Tervezzen GlyphLab-kísérletet adott compute budget mellett: három változat – depth-növelés, width-növelés, és a kettő kombinációja –, azonos -re beállított MAC-kal. Adjon megfigyelési egységet, splitet, baseline-t, metrikát és következtetési korlátot.
F1. Az expansion faktor egy blokk belső expanziós rétegének csatornaszorzója, míg a width multiplier a teljes hálózat minden konvolúciós rétegének csatornáit skálázza. Ellenpélda: egyetlen bottleneck blokkban , de ; hálózatszintű mellett a blokk bemeneti/kimeneti vékony csatornája duplázva van, a belső expanziós arány változatlan maradhat.
F2. Az egyszerűsített költségszorzó , így a közelített MAC . Az alakkompatibilis belső blokk ismétlését feltételező pontos képlet , mellett MAC. A belső súlyparaméterek skálaszorzója ; a stem és a fej külön számolandó.
F3. Megoldás:
def scale_estimate(M0, w, d, r):
    return d * (w ** 2) * (r ** 2) * M0

out = scale_estimate(172800, 2.0, 1.0, 2.0)
assert abs(out - 2_764_800) / 2_764_800 < 1e-3
A hányados-ellenőrzés a közelítő képlet implementációját ellenőrzi, nem a tényleges modell MAC-jával való egyezést. Az utóbbihoz a stem és a belső blokkok költségét külön kell számolni.
F4. A kód a depth
-vel
való közelítő lineáris skálázását tartalmazza, de a felbontás két
tengelyének együttes
hatását és a width belső rétegekre érvényes
hatását nem: minden belső rétegben a súly csatorna-csatorna szorzata
miatt nő. Következmény: a modell a tényleges MAC-ját alulbecsüli, így
adott budgetre túl nagy width-et választ. Javítás:
cost = d * w**2 * r**2 * M0. Az F3 példán
2**2 * 1 * 2**2 * 172800 = 2764800, ellentétben a hibás
2*1*2*172800=691200 értékkel.
F5. Lehetséges terv. Input:
data/images.npy 360×1×24×24, címke
data/labels.npy. Megfigyelési egység:
scene_id, mert a két nézet ugyanahhoz a jelenethez
tartozik; a train/val/test felosztás jelenetszintű, class-stratified, és
a corrput teszt csak a végén használható. Baseline: a 19.2. MobileNet és inverted residual alfejezetbeli
kis modell változatlanul. Változó: három változat, MAC-juk a compute
budgetre normálva; a felbontás 24×24-en rögzített, ezért a resolution
tengelyt kihagyjuk vagy csak kis r=1 marad. Metrika: validálási
cross-entropy, választás a legjobb validációs checkpointtal; záróteszt
accuracy a clean–corrupt páron. Következtetési korlát: GlyphLab nem
természetes képi benchmark, ezért az eredmény csak a toy-domainre
érvényes.
Gyakori tévedés, hogy a compound scaling képlete minden hardverre optimális szabály. Ellenpélda: memória-sávszélesség-korlátos eszközön a resolution növelése -es aktivációmemória-növekedést okoz, míg a depth növelése soros függőséget visz a futásidőbe; ugyanaz a MAC-budget más-más optimumot ad CPU-n és GPU-n. A heurisztika tehát keresési kiindulópont, nem hardverfüggetlen tétel.
Ellenőrizze: a költségmodell feltevései között szerepel a stride 1, a
méretmegtartó padding, a groups=1, valamint a
csatornaszámok kerekítésének elhagyása; a bias tag alacsonyabb rendű; a
compound képlet arányai empirikusak. A width multiplier 19.2. MobileNet és inverted residual fogalmát most
hálózatszintű költségskálázásként alkalmaztuk; a BatchNorm paraméterei
18.3. Pre-activation, kis batch és alternatív
normalizálás a csatornaszámokkal együtt
-vel
nőnek, a loss-szerződés 7.3. Bináris, multilabel és
regressziós cél viszont független a skálázástól.
A depth, width és resolution külön mérhető skálázási tengely. A feltételesen pontos stem–body költségmodellből levezethető a közelítő MAC-szorzó és a belső súlyparaméterek skálázása; az első réteg külön kezelendő, és relatív költsége csak akkor hanyagolható el, ha a baseline-ban is kicsi. A compound scaling e három tengelyt egy együtthatóval hangolja, de a konkrét arányok empirikus keresésből származnak, nem elméleti optimumból. A labor két width értékű kis modell méretét és CPU-idejét veti össze; a kimenet e kéziratban jelölt szemléltetés. A képlet hardverfüggősége miatt az eredmény helyi, nem általános optimalitási garancia.
A 19.4. ConvNeXt és a recept/architektúra elválasztása egység ConvNeXt kapcsán a modernizált CNN-recepteket vizsgálja [P11], ahol a skálázást az architektúra-változtatástól elkülönítve értelmezzük.