Az 5.2. Várható érték, variancia és likelihood egységben a Bernoulli-minta likelihoodjából megkaptuk, hogy egy elemű megfigyelés mellett az ismeretlen valószínűség maximum-likelihood becslése , ahol a sikerek száma. Ez a becslés azonban egyetlen szám. Ha a generátor másik véletlen mintát adott volna, a becsült is más lenne: a becslés maga is véletlen mennyiség. Jelen egységben ezt az ingadozást formalizáljuk, és azt a kérdést tesszük fel, hogyan tudunk olyan tartományt adni, amely megbízhatóan lefedi az igazi paramétert.
Kezdő becslésként gondoljunk egy méretű Bernoulli-mintára. Ha sikert kapunk, az MLE . Az olvasó becsülje meg: mekkora az az intervallum, amelyet „biztonságosnak” érez a valódi számára? A fejezet végére ezt az intuitív képet precíz eljárással váltjuk ki.
A szükséges előismeret az 5.2. Várható érték, variancia és likelihood valószínűségi alapfogalma: véletlen változó, várható érték, variancia, likelihood és sűrűségfüggvény. A 4.3. Jacobi-mátrix, láncszabály és VJP dimenzió-ellenőrzési szokása annyiban tér vissza, hogy minden becslésnél megadjuk a tensor alakját, az 1.3. Adatfelosztás és a megfigyelési egység megfigyelési-egység elve pedig a függetlenségi feltétel pontos megfogalmazásakor lesz döntő.
Legyen
Bernoulli-minta, azaz minden
-re
és
.
Az egyes megfigyelések értékeit jelölje
.
A vektorba rendezett megfigyelés
;
Python-tensor alakja (N,), float32 vagy
int64, bár a Bernoulli-célhoz az int64 a
természetes. Itt az oszlopvektor-konvenció a minta matematikai
tárgyalását szolgálja; a kódban a NumPy-tömb hossza adott.
A becslési eljárás és a becsült érték megkülönböztetése kulcskérdés.
Definíció (statisztika). A mintából számolt tetszőleges függvényt statisztikának nevezzük. Fontos esete a Mintaösszeg-számláló:
alakja Pythonban egyetlen int64 skalár.
Definíció (becslő). A paraméter becslője
A leképezés a minta teréből a paramétertartományba képez; ugyanaz a becslő más mintán más értéket ad. Ezért a maga is véletlen változó, amelynek eloszlása van. A paraméter ezzel szemben ismeretlen konstans. Ez a felfogás a klasszikus, gyakorisági statisztika kerete.
Várható érték. Mivel a -k Bernoulli-eloszlásúak -re, a várható érték linearitása miatt
Ez a torzítatlanság: a becslő eloszlása a valódi paraméter köré központosul.
Variancia. A függetlenség miatt a tagok kovarianciája nulla, ezért
Itt felhasználtuk, hogy Bernoulli-eloszlásra .
A szóródás mértékegységben kifejezett változata a standard hiba.
Definíció (standard hiba). A becslő standard hibája
Ez az érték az ismételt mintavételi ingadozás tipikus nagyságrendjét méri, de a valódi -től függ, így önmagában nem ismert. A megfigyelt mintából képezhető standardhiba-becslés
amely a valódi helyére az MLE-t írja. Ez már kiszámítható a mintából.
A standard hiba elvont, analitikus képlet. A kérdés az, hogyan mutatható meg közvetlenül az ingadozás. Ehhez szimulációs protokollt rögzítünk, amely a valódi paraméter ismeretét többszöri független minta generálására használja.
Protokoll (szimulációs kísérlet).
Legyen a kézenfekvő példa: , , . A lehetséges minták száma , tehát a szimuláció részben bejárja a mintateret. A standard hiba a képletből
Ennek ellenőrzése a szimulációval a következő szakasz laborjának célja. A tapasztalati szórás várhatóan közel lesz -höz, de nem pontosan egyenlő vele, hiszen mintából kapott becslés ingadozik.
A becslő minőségének mérésére két további fogalom szolgál.
Definíció (torzítás). A becslő torzítása
A fenti MLE torzítatlan, így . Torzítás nélkül is lehet nagy a szórás; a kettőt együtt méri a négyzetes hiba.
Definíció (négyzetes hiba). .
A várható érték linearitásával, a jelöléssel,
Az MLE esetében ezért
Ez a dekompozíció az, amely miatt a torzítást és a szórást külön érdemes mérni: egy torzítatlan, de nagy szórású becslő rosszabb lehet, mint egy enyhén torzított, de kis szórású. A dekompozíció levezetett állítás, feltétele csupán az, hogy mindkét momentum véges legyen.
A konfidenciaintervallum az ismételt mintavétel nyelvén fogalmaz meg garanciát. Nem a paraméterről állít valószínűséget; a véletlen az intervallum készítésében van.
Definíció (konfidenciaintervallum). Az szintű konfidenciaintervallum-eljárás olyan , ahol a minta mérhető függvényei, és minden megengedett paraméterre
A jelölés hangsúlyozza: az eljárást ugyanazzal a -vel ismételten mintavéve, hosszú távon legalább arányban fedi le az intervallum a paramétert. Az egyenlőtlenség a konzervatív változat; sok gyakorlati intervallum csak aszimptotikusan éri el a névleges lefedettséget.
Ez a definíció az, ami a gyakori félreértést eloszlatja: a 95%-os szint nem jelenti azt, hogy az aktuálisan kiszámított 0,95 valószínűséggel tartalmazza a paramétert. A paraméter vagy benne van, vagy nincs; a valószínűségi állítás az eljárás hosszú távú viselkedéséről szól. Egy adott intervallum utólagos valószínűsége posterior-értelmezést igényelne, amelyhez prior kell.
A Bernoulli-paraméterre a tankönyvben egy egyszerű, konzervatív intervallumot építünk, amely a Hoeffding-korláton alapul. A szükséges koncentrációs állítást pontos feltételekkel mondjuk ki.
Tétel (Hoeffding-korlát Bernoulli-mintára). Legyen iid Bernoulli() minta. Ekkor bármely mellett
A tétel bizonyítása a pillanatgeneráló függvény Markov-egyenlőtlenségén és a Bernoulli-változó Hoeffding-lemmáján alapul. A teljes bizonyítás megtalálható a [B01] 6. fejezetében, a koncentrációs egyenlőtlenségek tárgyalásánál; a jelen tankönyvben a véges melletti numerikus ellenőrzést használjuk, és a mértékelméleti keret bizonyítását nem ismételjük. A szimuláció megmutatja, hogy a korlát mennyire konzervatív.
Következmény (Hoeffding-féle intervallum). Válasszunk szintet, és legyen
Ekkor az intervallum
legalább lefedettségű konfidenciaintervallum.
Levezetés. A tételben a lefedettség romlását akarjuk, ami ekvivalens feltétellel. Az egyenlőséggel választott tehát garantálja, hogy a lefedési hiba legfeljebb . Mivel az intervallum szimmetrikus és a tétel a -re vonatkozik, az állítás következik. Ez levezetett eredmény; itt a Bernoulli-paraméterre alkalmazzuk, de a mögötte álló Hoeffding-tétel ennél általánosabb. Feltétele a megfigyelések függetlensége és korlátossága (itt ); nem kell sem azonos eloszlás, sem diszkrétség, ezért bármely -be eső, akár folytonos célváltozóra is érvényes (ekkor helyett az átlagos várható érték szerepel), -korlátos változóra pedig -tel skálázva. A korlát akkor nem alkalmazható, ha a megfigyelések függnek egymástól (például ugyanazon jelenet két nézete, 5.4. Függő képek, seedek és resampling), vagy ha a változó nem korlátos. ∎
Számpéldával: legyen és , azaz 95%-os szint. Ekkor
Ha a mintában sikert figyeltünk meg, akkor , így az intervallum:
Ez nagyon széles. A Hoeffding-korlát erőssége az, hogy minden -re és minden -re érvényes; a hátránya az, hogy a névleges szintnél sokkal konzervatívabb, különösen közepes -re. Ezért nagyobb mintánál pontosabb, normális approximációra épülő intervallumokat használunk.
A maximum-likelihood becslés aszimptotikus normalitása alapján a kézenfekvő közelítő intervallum
ahol a standard normális eloszlás kvantilise. Ez a Wald-intervallum. Csak nagy mintára érvényes közelítő eljárás, ezért a definícióban a névleges lefedettség nem garantált. Ennek ellenére a programozói gyakorlatban a lefedettségvizsgálat a leggyorsabb ellenőrzés arra, hogy az eljárás egy konkrét páros mellett mennyire használható.
A Wald-intervallum névleges eljárása:
Az intervallumot a tartományra szokás metsszeni, mivel a paraméter eleve oda esik; a mi laborunk ezt a lépést is elvégzi.
A lefedettségi szimuláció a definíciót operacionalizálja. Rögzítünk egy rácsot, például , minden -re sok, egymástól független mintát generálunk, minden mintából intervallumot készítünk, és megnézzük, hány intervallum tartalmazza az adott -t. A lefedettségi arány a rács függvényében rajzolva megmutatja a Wald-intervallum híres gyengeségeit.
A gyakori tévedés itt már látható: a szimuláció a ismeretére épül, tehát tanulási célra alkalmas, de valódi kísérletben a paramétert nem ismerjük. A lefedettségi szimuláció nem bizonyíték a Wald-intervallum általános érvényességére; ez egy empirikus mérés, amelynek határa a szimulált -tartomány és az választása.
Tekintsünk egy elemű Bernoulli-mintát: . Számoljuk ki a becslést, a standardhiba-becslést és a Hoeffding-intervallumot.
Így a konzervatív intervallum , a metszet után , ami természetesen mindig lefedi a paramétert, de nem informatív.
Ez a példa azt mutatja, hogy a kis minta és a konzervatív korlát kombinációja üres teljesítményhez vezethet. A Wald-intervallum ugyanerre a mintára mellett:
amelyet a intervallumra metszve -t kapunk. A Wald-intervallum itt már szűkebb a Hoeffding-féle -nél, de kis mintán nem garantálja a névleges lefedettséget.
A labor egyetlen NumPy-munkamenetben elvégzi a szimulációt; a lenti kimenetek a lab-profilban (NumPy 2.3.5, SciPy 1.18.1) mért értékek.
A munkakönyvtár: lab/n019. A kód
coverage_binomial.py néven fut.
"""Bernoulli-becslő lefedettségi szimulációja.

A kód a Wald-intervallum és a Hoeffding-intervallum lefedettségét
becsüli ismételt mintavétellel. A kimeneteket a konzolra írja.
"""
from __future__ import annotations

import numpy as np
from scipy.stats import norm

rng = np.random.default_rng(20261020)
N = 20
R = 2000
alpha = 0.05
z = norm.ppf(1 - alpha / 2)
p_grid = np.arange(0.01, 1.0, 0.01)

cover_wald = np.zeros_like(p_grid)
cover_hoeff = np.zeros_like(p_grid)

for idx, p in enumerate(p_grid):
    x = rng.binomial(1, p, size=(R, N))
    se = np.sqrt(np.clip(x.mean(axis=1) * (1 - x.mean(axis=1)), 0.0, 1.0) / N)
    low = x.mean(axis=1) - z * se
    high = x.mean(axis=1) + z * se
    cover_wald[idx] = np.mean((low <= p) & (p <= high))
    eps = np.sqrt(np.log(2 / alpha) / (2 * N))
    cover_hoeff[idx] = np.mean(
        np.abs(x.mean(axis=1) - p) <= eps
    )

print(f"N={N}, R={R}, alpha={alpha}")
print("Legkisebb Wald-lefedettség:", cover_wald.min())
print("Legnagyobb Wald-lefedettség:", cover_wald.max())
print("Legkisebb Hoeffding-lefedettség:", cover_hoeff.min())
print("Legnagyobb Hoeffding-lefedettség:", cover_hoeff.max())
print("Wald-lefedettség p=0.1-nél:", cover_wald[9])
print("Wald-lefedettség p=0.5-nél:", cover_wald[49])
A kódot a python coverage_binomial.py paranccsal
futtatjuk. A lab-profilban mért kimenet:
N=20, R=2000, alpha=0.05
Legkisebb Wald-lefedettség: 0.169
Legnagyobb Wald-lefedettség: 0.956
Legkisebb Hoeffding-lefedettség: 0.991
Legnagyobb Hoeffding-lefedettség: 1.0
Wald-lefedettség p=0.1-nél: 0.882
Wald-lefedettség p=0.5-nél: 0.951
Értelmezés:
A futtatás után a következő ellenőrzések ajánlottak:
cover_wald.shape == p_grid.shape és a
p_grid.size == 99, mert
np.arange(0.01, 1.0, 0.01) 99 elemű, alakja
(99,).se képletben a clip megelőzi a negatív
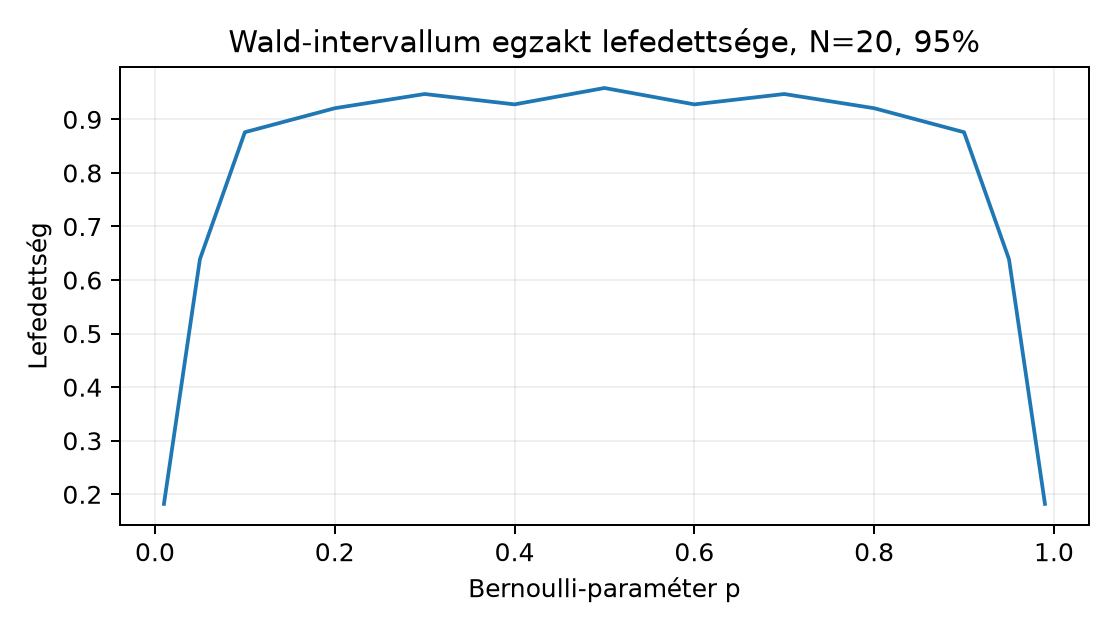
értékeket, amit a numerikus kerekítés okozhat.A diagram a Wald-intervallum egzakt lefedettségét ábrázolja , mellett: , ahol a -hez tartozó Wald-intervallum. A számítás véletlenmentes (nincs seed és ismétlésszám), a pontok a rács kiválasztott értékei.
A görbe nem sima „U” és nem is sima harang: a két szélen meredeken a névleges szint alá zuhan ( és mellett ), a középső tartományban pedig a binomiális eloszlás diszkrétsége miatt fűrészfogszerűen ingadozik, többnyire alatt; a teljes 99 pontos rácson a legnagyobb érték -nél . A kirajzolt pontok csak mintavételezik ezt a szakadásos függvényt, ezért a két pont közötti egyenes nem a valódi lefutás.
A leggyakoribb tévedés a konfidenciaintervallum és a posterior tartomány összekeverése. A konfidenciaintervallum definíciója az ismételt mintavételre hivatkozik. Egy prior és a Bayes-tétel nélkül az állítás
nem értelmes, mert a -nek nincs eloszlása. Ennek ellenpéldája:
Gyakorlati haszna mégis van a konfidenciaintervallumnak: ha a becslési eljárást ismételten végrehajtanánk a felhasználás során, a lefedettségi arány garantálható. A modellkísérletekben a különböző seedekből származó eredmények szórása 5.4. Függő képek, seedek és resampling témája, és nem azonos a paraméterre vonatkozó konfidenciaintervallummal.
Ebben az egységben három állítástípus szerepel:
Ez az elhatárolás teszi lehetővé, hogy a hallgató ne keverje a korlátot és a becsült lefedettséget. A Hoeffding-korlát garantált, a Wald-lefedettség szimulációja nem.
A 95%-os konfidenciaintervallumot gyakran úgy értelmezik, hogy „95% valószínűséggel a paraméter az intervallumban van”. Ez nem állítható a gyakorisági definícióból. Az ellenpélda: ha és , a Wald-intervallum metszet a -gyel. Ha a valódi paraméter , az intervallum nem tartalmazza -t. Az eljárás lefedettsége -nél ugyanakkor nem 0,95, hanem annál kisebb. A két állítás más objektumról szól.
A hallgató a következő kérdésekkel tesztelheti a fogalmak elsajátítását:
clip a
standardhiba-becslés előtt?Rövid visszahívás 5.2. Várható érték, variancia és likelihood: a várható érték linearitása az, amely a torzítatlansági levezetést lehetővé teszi, a függetlenség pedig a kovarianciás tagok eltűnéséért felelős.
Nehézség: 1. Előfeltétel: 5.3. Mintavételi bizonytalanság és intervallum definícióinak ismerete. Átadandó: saját szavakkal írt magyarázat és egy példa.
Magyarázza el, mi a különbség a becslő és a becslés között, valamint a standard hiba és a becsült standard hiba között. Adjon egy elemű Bernoulli-mintát, amelyre a becslő értéke , és számolja ki a becsült standard hibát.
Nehézség: 2. Előfeltétel: a variancia és a függetlenség alapjai. Átadandó: teljes levezetés és a végeredmény.
Legyen iid Bernoulli() minta, és . Vezesse le a várható értékét, varianciáját és standard hibáját. Ellenőrizze a képletet az szélső esetben: mi a standard hiba?
Nehézség: 2. Előfeltétel: a labor kódjának megértése. Átadandó: futtatható függvény a kért kimenettel.
Írjon Python-függvényt wald_interval(x, alpha) néven,
amely egy (N,) alakú Bernoulli-mintából kiszámolja a
Wald-intervallum
végpontjait. A függvény a scipy.stats.norm.ppf
használatával, float64 pontossággal dolgozzon, és a
végpontokat a
tartományra metssze. Az ellenőrzéshez használja az
,
mintát. A várt intervallumot hat tizedesjegyre számolja ki.
Nehézség: 2. Előfeltétel: a labor kódjának ismerete. Átadandó: a hiba oka, következménye, javítása és ellenőrzése.
A következő kódrészlet a Hoeffding-lefedettséget méri, de hibás:
eps = np.sqrt(np.log(2 / alpha) / (2 * N))
cover = np.mean(np.abs(x.mean(axis=1) - p) < eps)
Mi a hiba, és miért vezet a lefedettség alulbecsléséhez? Javítsa a kódot, és indokolja a választott összehasonlító operátort a definíció alapján.
Nehézség: 3. Előfeltétel: a lefedettségi szimuláció elve. Átadandó: protokollterv, lehetséges baseline és érvényességi korlát.
Tervezzen szimulációt annak vizsgálatára, hogy a Hoeffding-intervallum lefedettsége hogyan viselkedik, ha a minták nem függetlenek, hanem az 1.3. Adatfelosztás és a megfigyelési egység GlyphLab-struktúrához hasonlóan párokba rendeződnek: minden pair azonos rejtett paraméterű Bernoulli-változók. Milyen protokollal különítené el a függetlenség megsértésének hatását? Milyen korlátot érvényesítene a konklúzióban?
A becslő a minta teréből a paramétertérbe képező függvény, tehát maga is véletlen változó. A becslés e függvény adott realizált mintára vett értéke: . A standard hiba a becslő eloszlásának szórása, mely a valódi -től függ; a becsült standard hiba a paraméter ismeretlen értékét a mintából becsült értékkel helyettesíti.
Példa: . Ekkor , , és
A várható érték linearitásával, mivel minden Bernoulli-eloszlású -re,
Így torzítatlan. A varianciához a függetlenséget használjuk:
A standard hiba ennek négyzetgyöke:
Szélső eset: . Ekkor , ami éppen a Bernoulli-változó szórása. Ez konzisztens: egyetlen megfigyelésből a becslés maga a megfigyelés, így ingadozása megegyezik az eredeti változóéval.
"""Wald-intervallum Bernoulli-mintára."""
from __future__ import annotations

import numpy as np
from scipy.stats import norm


def wald_interval(x: np.ndarray, alpha: float) -> tuple[float, float]:
    """A Wald-féle konfidenciaintervallum [L, U] végpontjai.

    x: (N,) alakú 0/1 értékű minta, float64.
    alpha: a hiba valószínűsége, pl. 0.05.
    """
    N = x.shape[0]
    p_hat = x.mean()
    se = np.sqrt(p_hat * (1 - p_hat) / N)
    z = norm.ppf(1 - alpha / 2)
    L = max(0.0, p_hat - z * se)
    U = min(1.0, p_hat + z * se)
    return L, U


x = np.array([1, 0, 0, 1], dtype=np.float64)
alpha = 0.05
L, U = wald_interval(x, alpha)
print(f"L={L:.6f}, U={U:.6f}")
Számolás: , , . Az intervallum végpontjai:
Az elvárt kimenet L=0.010009, U=0.989991, amit a metszet
nem módosít, hiszen mindkét végpont a
belsejében van.
A hiba a szigorú < operátor. A lefedettségi definíció
megengedő egyenlőtlenséget ír elő:
.
Ezért a
eseményt kell vizsgálni. A Bernoulli-mintaátlag diszkrét:
csak a
értékeket veheti fel. Ezért az egyenlőség eseményének lehet
pozitív valószínűsége, amikor
teljesül valamely lehetséges mintaátlagra. A szigorú <
ilyenkor ténylegesen alulbecsülheti a zárt intervallum lefedettségét;
más paraméterértéknél a különbség nulla.
Javított kód:
cover = np.mean(np.abs(x.mean(axis=1) - p) <= eps)Ellenőrzés: a lefedettségi arány így konzisztens a Hoeffding-korlát állításával, miszerint a hiba valószínűsége legfeljebb . Az elméleti lefedettség a Hoeffding-feltételek mellett legalább ; a véges szimulációban mért lefedettség véletlen ingadozása miatt lehet a névleges szint alatt is.
A transzferfeladat protokollja:
scene_id-hez húzunk egy közös
rejtett értéket; a két nézet
feltételesen független
Bernoulli()
változó. A függetlenség megsértését az jelenti, hogy a
scene-enként változik, de a nézeteken belül közös.A hallgató a feladatmegoldásban a fenti szerkezetet töltse ki a konkrét szimulációs lépésekkel. A megoldásminta a terv szerkezetét és az alternatívák indoklását értékeli, nem egy előre adott numerikus eredményt.
A becslő a minta függvénye, így maga is véletlen változó; a becslés a konkrét mintán kapott érték. Az iid Bernoulli-minta MLE-je torzítatlan, varianciája , a standard hiba ennek négyzetgyöke. A négyzetes hiba varianciára és torzításnégyzetre bomlik. A konfidenciaintervallum lefedettsége ismételt mintavételi gyakoriság: a Hoeffding-intervallum garantáltan legalább szintű, míg a Wald-intervallum csak aszimptotikus közelítés. A labor sok szintetikus mintából méri a lefedettséget; a kapott arány szimulációs bizonyíték, nem analitikus garancia. A 95%-os intervallum nem azonos a paraméter 95%-os posterior valószínűségével, mert utóbbihoz prior szükséges.
A lefedettségi szimuláció a bizonytalanság egy fajtáját méri. A gyakorlatban a különböző betöltött seedekből származó modellek szóródása is mintavételi bizonytalanság, ám az adatok függhetnek egymástól: ugyanazon jelenet két nézete nem független. Az 5.4. Függő képek, seedek és resampling egység ezt a függő struktúrát és a bootstrap alapjait vezeti be.
A Wald-intervallum kis mintás lefedettségét a fejezet nem külső forrásból veszi át, hanem saját számítással mutatja meg: a chart a binomiális eloszlásból egzaktul számolt értékeket ábrázolja (, ), a labor szimulációja (, seed 20261020) pedig Monte-Carlo-hibán belül ugyanezt adja. Más esetén a görbe részletei megváltoznak, a szélek alá-lefedése és a diszkrétség okozta ingadozás nem.