Ebben az egységben az 5.1. Esemény, feltétel és véletlen változó alfejezetben bevezetett eloszlásokhoz rendelünk összefoglaló számokat, és megfordítjuk a kérdés irányát: nem azt kérdezzük, hogy adott paraméter mellett mi a megfigyelés valószínűsége, hanem hogy adott megfigyeléshez melyik paraméter a legvalószínűbb magyarázat. Ehhez definiáljuk a várható értéket, varianciát, kovarianciát, majd a likelihoodot és a maximum likelihood becslést (MLE). A 4.2. Parciális derivált és gradiens alfejezetből a deriválást használjuk a maximum megtalálásához, az 1.2. Szakmailag megalapozott modellezési állítások alfejezetből pedig az állítástípus-fegyelmet: a momentumok levezetése tétel, a numerikus Riemann-közelítés empirikus ellenőrzés.
Induló becslés. Egy szabályos dobókocka sok dobásának átlaga hosszú távon hová tart? Tippeljen egy számot, mielőtt a várható értéket bevezetjük. (A helyes válasz ; a levezetést lentebb adjuk.)
A likelihood tárgyalásához négy fogalmat külön kell választani; a felcserélésük gyakori hibaforrás a modellezési jelentésekben.
Definíció (adat). Az adat a megfigyelt realizációk véges sorozata. Ebben az egységben skalár megfigyelésekkel dolgozunk: , ahol Bernoulli-címke esetén , kategorikus címke esetén . A tenzoralak a programban vagy ; az a minta elemszáma.
Definíció (modell és paraméter). A modell egy eloszláscsalád ahol minden rögzített paraméterhez egy-egy eloszlás tartozik, és a lehetséges paraméterek halmaza. Bernoulli-modellnél és . A paraméter a modell egy pontját választja ki; a valódi adatgeneráló mechanizmus ismeretlen.
Definíció (becslési eljárás és becslés). A becslési eljárás egy függvény, amely minden lehetséges mintához egy -beli értéket rendel: . A konkrét realizációból számolt a becslés. Az eljárás a recept, a becslés az eredmény — ugyanaz a különbség, mint a függvény és a függvényérték között.
A GlyphLab adatban kép címkéje kategorikus modellt követhet; a kép maga nem ebben az egységben modellezett megfigyelés, csak a címke. A modellválasztás külön döntés, a paraméter becslése pedig az adaton végzett számítás.
Definíció (diszkrét várható érték). Legyen diszkrét valószínűségi változó súlyfüggvénnyel. Ha akkor várható értéke
A feltétel nem díszítés. A abszolút összegezhetőség biztosítja, hogy az összeg sorrendje ne változtassa az eredményt. Példa nélküli divergens eset: legyen minden egészre; ez valóban eloszlás, mert , de , tehát nem létezik véges értékként.
Definíció (folytonos várható érték). Legyen folytonos valószínűségi változó sűrűségfüggvénnyel. Ha , akkor A sűrűség és a határozott integrál kapcsolatát 5.1. Esemény, feltétel és véletlen változó tisztázta: , a sűrűség pontbeli értéke nem valószínűség.
Tétel (linearitás). Ha létezik, akkor tetszőleges esetén
Bizonyítás (diszkrét eset). A definícióból: mert . Folytonos esetben az összeget integrálra cserélve ugyanez a lépés. A típusú kifejezések várható értékére használjuk a helyettesítési szabályt: diszkrét esetben ; folytonos esetben . Ez utóbbi a transzformációs tétel következménye, amelynek bizonyítását itt elhagyjuk; a felhasznált konkrét -k mind polinomok, amelyekre az eredményt közvetlen integrállal is ellenőrizzük.
Definíció (variancia és szórás). Ha létezik, akkor feltéve, hogy ez a várható érték véges. A szórás , mértékegysége azonos -ével.
Tétel (számítóképlet). és .
Bizonyítás. Legyen . A linearitást alkalmazva: A második állításhoz , így
Definíció (kovariancia). Két véges varianciájú valószínűségi változó kovarianciája A korreláció , amennyiben mindkét szórás pozitív; ez értékű, és csak lineáris kapcsolatot mér.
Tétel (összeg varianciája).
Bizonyítás. Jelölje , . A linearitásból , így
Ha és független, akkor , amiből , tehát . A megfordítás nem igaz. Ellenpélda: legyen egyenletes eloszlású a halmazon, . Ekkor , , és , ezért a kovariancia . Mégsem függetlenek, mert , míg .
A folytonos momentumok kiszámításához a Riemann-integrál egyetlen tételét használjuk.
Tétel (Newton–Leibniz-formula, polinomokra kimondva). Ha folytonos a zárt intervallumon, és =f az -n, továbbá folytonos -n, akkor egészre a polinom primitív függvénye .
A tételt itt a szükséges polinom-esetre alkalmazzuk; általános bizonyítását nem végezzük el, mert az integrálelmélet körültekintő felépítése a könyv keretein kívül esik. A folytonosság elegendő feltétel a Riemann-integrálhatósághoz, de a formula a megadott feltételpár mellett lépésről lépésre használható.
Tétel (egyenletes eloszlás momentumai). Legyen , azaz sűrűsége az intervallumon és azon kívül, ahol valósak. Ekkor
Bizonyítás. Először a várható érték: Itt az utolsó lépés a azonosság, ami a feltétel miatt egyszerűsíthető. A második momentum: A számítóképletből:
A -en egyenletes esetben , . Ez a momentum közvetlenül kapcsolódik 5.1. Esemény, feltétel és véletlen változó Riemann-összegéhez: az integrál ugyanaz a terület, amelyet ott téglalapokkal közelítettünk.
Definíció (likelihood). Rögzített megfigyeléshez a likelihood függvény diszkrét esetben; folytonos modellnél helyett sűrűség áll. A log-likelihood ahol természetes logaritmus. A szorzatból összeg lesz, ami numerikusan stabilabb; a log szigorú monotonitása miatt és maximumhelye azonos.
A likelihood fontos tulajdonsága: rögzített adat mellett a paraméter függvénye. Nem a paraméter valószínűsége, nem normalizált eloszlás, és nem egyenlő a Bayes-féle posteriorral — erre a tipikus tévedés részben adunk ellenpéldát.
Tétel (Bernoulli-minta MLE). Legyen minta, és . A Bernoulli-modell likelihoodja és ha , akkor az egyetlen belső maximumhely Ha , akkor a maximum ; ha , akkor .
Bizonyítás. Minden egyes megfigyelés likelihoodja ; független minta esetén ezek szorzata adja -t. A kitevők összeadódnak: az -esek száma , a -ké . A log-likelihood Feltéve , az első derivált A második derivált minden -re, tehát szigorúan konkáv a intervallumon; egyetlen stacionárius pontja globális maximum. A egyenlet: A szélső esetek: esetén , ami -ban maximális; esetén , ami -ben maximális. Ilyenkor a derivált zérushelye nincs a belső tartományban, ezért a maximumot a tartomány szélén keressük — a belsőponti feltétel a kulcs.
A likelihood értékét a maximumban a kézi példában számítjuk ki.
Legyen pénzérme-feldobás eredménye . Ekkor , az MLE . A likelihood a maximumhelyen: a log-likelihood pedig Ellenőrzés közeli pontban: , tehát a numerikus kép összhangban van a tétellel.
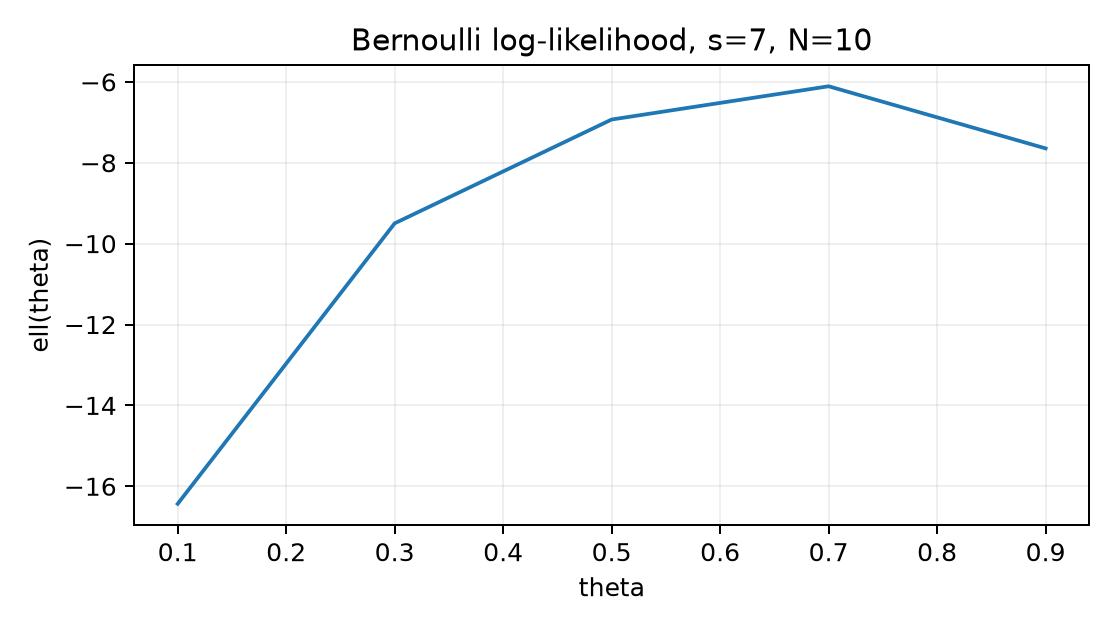
A következő ábra egy nagyobb minta, , log-likelihoodját mutatja; a maximum -nél van.
A line chart kerekített; a pontos értékek közvetlen behelyettesítéséből adódnak, a maximum ténylegesen .
A labor két célt ellenőriz egyszerre: (1) szimulált kategorikus
mintából MLE-t illesztünk, beleértve a nullszámosságú osztály szélső
esetét; (2) a folytonos egyenletes momentumot kézi integrállal és
midpoint Riemann-összeggel is kiszámítjuk. A kód a
lab/n018_likelihood.py munkakönyvtárban készül, az inputot
maga generálja, tehát nincs külső adatletöltés. A seed
20261020, a lebegőpontos típus float64.
# lab/n018_likelihood.py
# Futtatás: python lab/n018_likelihood.py
import numpy as np

rng = np.random.default_rng(20261020)

# --- 1. Kategorikus minta és MLE ---
p_true = np.array([0.5, 0.3, 0.2, 0.0], dtype=np.float64)
K = p_true.size
N = 200
y = rng.choice(K, size=N, p=p_true)          # int64 osztályindexek
counts = np.bincount(y, minlength=K)
p_hat = counts / N                           # MLE kategorikus modellre

print("counts     :", counts)
print("p_hat      :", p_hat)
print("sum        :", p_hat.sum())
print("nemnegativ :", np.all(p_hat >= 0.0))

# A generáló p negyedik komponense 0, ezért a minta sem tartalmazhatja.
assert counts[3] == 0
assert p_hat[3] == 0.0
assert np.isclose(p_hat.sum(), 1.0, atol=1e-12)

# --- 2. Stabil Bernoulli log-likelihood a szélekkel ---
def bernoulli_loglik(theta, s, n):
    if theta == 0.0:
        return 0.0 if s == 0 else -np.inf
    if theta == 1.0:
        return 0.0 if s == n else -np.inf
    return s * np.log(theta) + (n - s) * np.log(1.0 - theta)

# Szélső konvenciók ellenőrzése
assert bernoulli_loglik(0.0, 0, 10) == 0.0
assert bernoulli_loglik(1.0, 10, 10) == 0.0
assert bernoulli_loglik(0.0, 1, 10) == -np.inf

# --- 3. Egyenletes [0,1] momentumok: kézi integrál és midpoint Riemann ---
a_val, b_val = 0.0, 1.0
n_bins = 1000
h = (b_val - a_val) / n_bins
mid = a_val + (np.arange(n_bins, dtype=np.float64) + 0.5) * h
density = 1.0 / (b_val - a_val)

Ex_num = np.sum(mid * density * h)
Ex2_num = np.sum(mid**2 * density * h)
Ex_analytic = (a_val + b_val) / 2.0
Ex2_analytic = (a_val**2 + a_val * b_val + b_val**2) / 3.0
var_analytic = (b_val - a_val)**2 / 12.0

print("Ex numerikus  :", Ex_num)
print("Ex analitikus :", Ex_analytic)
print("Ex2 numerikus :", Ex2_num)
print("Ex2 analitikus:", Ex2_analytic)
print("abs hiba Ex   :", abs(Ex_num - Ex_analytic))
print("Var numerikus :", Ex2_num - Ex_num**2)
print("Var analitikus:", var_analytic)
Az utolsó rész pontos egyezése: a
várható érték analitikus értéke
;
a midpoint szabály lineáris függvényekre pontos a szimmetria miatt,
tehát az Ex_num
-öt
ad, és abs hiba Ex
.
A varianciánál a numerikus
körülbelül
;
a tolerancia a midpoint hiba nagyságrendje, körülbelül
alatt. A kód kimenetében a counts konkrét értékei a seedelt
realizációtól függenek; ezek itt előre nem rögzített mérési eredmények,
ezért nem is közlünk kitalált kimenetet. A három assert a
4-es osztályra viszont determinisztikusan teljesül, mert a generáló
.
F1 — fogalmi, nehézség 1. Definiálja a diszkrét várható értéket, és mutassa meg, hogy a , eloszlás teljesíti a normalizálást, de nincs véges várható értéke. Adja meg, melyik feltétel sérül.
F2 — levezetési, nehézség 2. Vezesse le a Bernoulli-eloszlás varianciáját és felhasználásával, majd független Bernoulli-változó összegének varianciáját a kovarianciás összegképletből. Mondja ki, hol használja a függetlenséget.
F3 — implementációs, nehézség 2. Írjon
categorical_mle(y, K) függvényt, amely az y
int64 tömb és a
osztályszám alapján visszaadja a
becsléseket. Kezelje a nullszámosságot
értékkel, a kimenet nemnegatív és 1 összegű legyen. Tesztelje
y = np.array([0,0,2]), K=3 bemeneten.
F4 — hibakeresési, nehézség 2. Az alábbi kód a Bernoulli MLE-t akarja kiszámítani.
def bad_mle(s, N):
    if s == 0:
        return 0.0
    if s == N:
        return 1.0
    return s / (N - s)   # HIBA
Lokalizálja a hibát, adja meg az okát, a következményét esetén, és a javított képletet. Ellenőrizze a javítást úgy, hogy a log-likelihood deriváltja a kapott pontban nulla legyen.
F5 — kísérleti/transzfer, nehézség 3. Tervezzen kísérletet: a kategorikus MLE becslési hibája hogyan változik a minta elemszámával? A generáló eloszlás legyen , , legalább 3 seed. Metrika: . Adjon protokollt, baseline-t, megfigyelési egységet és következtetési korlátot. Előre megadott győztest nem kérünk.
F1. A diszkrét várható érték definíciója: , ha . A megadott eloszlás normalizált: . A momentumhoz tartozó sor , ami divergál, tehát az abszolút összegezhetőség feltétele sérül; nem létezik véges értékként. Ez mutatja, hogy a normalizálás önmagában nem garantál momentumot.
F2. Bernoulli esetén , és mivel , ezért . A számítóképletből . Az összeg varianciájához a kovarianciás képletet iterálva: Független esetén a kovariancia ; itt használjuk a függetlenséget. Így . Alakellenőrzés: , a variancia nemnegatív, és vagy esetén , ahogy a konstans változótól várjuk.
F3. A függvény:
import numpy as np

def categorical_mle(y, K):
    counts = np.bincount(y, minlength=K).astype(np.float64)
    return counts / counts.sum()

y = np.array([0, 0, 2], dtype=np.int64)
p = categorical_mle(y, 3)
assert p.shape == (3,)
assert np.all(p >= 0.0)
assert np.isclose(p.sum(), 1.0, atol=1e-12)
assert p[1] == 0.0 and np.isclose(p[0], 2.0/3.0)
A minlength=K biztosítja, hogy a nem látott osztály is
szerepeljen
számmal; a counts.sum() mindig
,
ezért nincs nullával osztás.
F4. A hiba a derivált egyenletének hibás megoldása. A feltételből adódik, nem . A hibás képlet esetén -öt ad, ami kívül esik a paramétertartományon, tehát nem valószínűség. Következmény: a „becslés” értelmetlen, és a likelihood nem is értelmezett ott. Javítás: . Ellenőrzés: , továbbá , tehát maximum.
F5. Egy lehetséges terv: a megfigyelési egység egy
adott
méretű, adott seeddel generált kategorikus minta; a generáló
rögzített, tehát a becsült
eltérése az ismert igazságtól mérhető. Minden
cellában kiszámítjuk
-t,
és az azonos
-hez
tartozó értékeket átlagoljuk. Baseline: mindig az egyenletes
becslés
hibája, hogy a tanult becslés ennél jobb-e. A protokoll rögzíti a
seedeket
(),
a NumPy-verziót és a default_rng generátort. Várt trend:
nagyobb
mellett az átlagos
csökken, mert a számláló becslés konzisztens; ezt nem garantáljuk előre
az adott 3 seedre. Következtetési korlát: három seed kis minta a
becslési eljárás szórására, nem bizonyítja a konvergenciát; az eredmény
a generáló eloszlásra érvényes, más eloszlásra nem.
A leggyakoribb értelmezési hiba: „a likelihood a paraméter valószínűsége, tehát normalizálással eloszlást kapunk prior nélkül.” Ez nem igaz, és a normalizálás önkényes eredményre vezet. Tekintsük az , Bernoulli-mintát. A likelihood értékei és esetén és . Ha a rácson normalizálunk, a -hez tartozó súly . Ha viszont a rács , a -hez tartozó súly . Ugyanannak a mintának és paraméterpontnak „valószínűsége” meredeken függ attól, milyen más pontokat vettünk fel a rácson — egy valódi eloszlás ezt nem teheti. A likelihood csak hányadosokban hordoz összehasonlító erőt: rácsfüggetlen. Ezzel szemben a posterior az 5.1. Esemény, feltétel és véletlen változó Bayes-tételéből származik, és prior nélkül nem definiált.
Visszahívás: 5.1. Esemény, feltétel és véletlen változó alfejezetben a sűrűséget területként értelmeztük — ezt használtuk az egyenletes momentum integráljában. 4.2. Parciális derivált és gradiens alfejezetben a gradiens alak-egyeztetését tanultuk — a likelihood maximumának keresése egyváltozós deriválás, de ugyanaz a stacionáriuspont-logika.
A várható érték az eloszlás középpontját, a variancia a szóródását méri; mindkettőhöz véges momentum szükséges. A kovariancia két változó együttes ingadozását összegzi, de a nulla kovariancia nem jelent függetlenséget. Egyenletes eloszlásra az első két momentum a Newton–Leibniz-formulával, polinom-primitív függvényekkel vezethető le. A likelihood rögzített adat mellett a paraméter függvénye, szorzatalakját a logaritmus összeggé alakítja. Bernoulli-minta esetén a log-likelihood konkáv, a belső maximum , a és szélső eseteket külön kell kezelni. A likelihood nem normalizálható a paraméter eloszlásává prior nélkül.
Az 5.3. Mintavételi bizonytalanság és intervallum a becslés bizonytalanságát vizsgálja: az MLE egyetlen szám, de más minta más becslést adna. Ott a konfidenciaintervallum és a bootstrap segítségével különítjük el a paraméter igazságát a mintavételi ingadozástól.