A 4.1. Függvény, határérték és derivált egyetlen valós paraméter esetén értelmezte a deriváltat: a függvény lokális lineáris közelítésének meredekségét. A neurális hálózat tanítása során azonban a veszteség egyszerre sok súlytól függ, ezért azt kérdezzük: ha egy dimenziós paramétervektort egyszerre több irányban is elmozdíthatunk, melyik irányban változik a leggyorsabban a veszteség, és hogyan foglalható össze a változás egyetlen vektorban? A fejezet a parciális deriváltat, a gradienst, az iránymenti deriváltat és a többváltozós differenciálhatóságot építi fel. Előismeret: határérték és egyváltozós derivált a 4.1. Függvény, határérték és derivált alfejezetből, valamint a mátrixszorzás és az oszlopvektor-konvenció a 3.2. Mátrixszorzás és affín réteg alfejezetből. Induló becslésként gondoljuk végig: ha , akkor a pontból a irányba tett kis lépés vajon növeli vagy csökkenti az értéket? A válaszhoz mindkét koordináta menti változást össze kell kapcsolnunk.
Legyen nyílt halmaz, , és . Az -edik koordináta szerinti parciális derivált (partial derivative) az pontban az egyváltozós derivált mintájára definiálható:
ahol az -edik standard bázisvektor, pedig olyan, hogy . A parciális derivált tehát úgy vizsgálja a függvényt, hogy csak az -edik koordinátát mozgatjuk, a többit rögzítjük. A , és jelölések mind ugyanezt jelentik. Az eredmény skalár, mértékegysége a függvényérték és a koordináta mértékegységének hányadosa; a könyv későbbi fejezeteiben jellemzően „veszteségegység per súlyegység”.
1. példa. Legyen , . Az első parciális derivált a rögzítése mellett a egyváltozós függvény deriváltja:
és hasonlóan
A pontban a két parciális derivált és . Az első azt mondja meg, hogy csak a koordinátát mozgatva a függvény lokálisan meredekséggel változik; a második ugyanezt mondja a irányra.
A parciális deriváltakból képzett vektort gradiensnek (gradient) nevezzük:
A könyv oszlopvektor-konvenciót használ: a gradiens alakja megegyezik
az input
alakjával. Ha a függvény argumentuma mátrix vagy magasabb dimenziós
tensor, a gradiens a parciális deriváltaknak ugyanolyan alakú,
komponensenkénti rendezett gyűjteménye. A PyTorch-ban a
.grad mező alakja ezért megegyezik annak a tensornak az
alakjával, amelyre a skalár veszteséget deriváltuk [D05]. Az 1. példában
.
A parciális deriváltak csak a koordinátatengelyek menti változást írják le. Általános irányhoz rögzítsünk egy , vektort. A irányú iránymenti derivált (directional derivative) az
határérték, ha létezik. Ez a egyváltozós függvény deriváltja a pontban. Ha , az érték a irányú meredekség; ha nem egységvektor, a definíció arányosan nagyobb lépést vizsgál, ezért minden -ra.
A gradiens és az iránymenti derivált kapcsolatát a következő lemma adja.
Lemma (iránymenti derivált a gradiensből). Ha differenciálható az pontban, akkor minden vektorra
Bizonyítás. A többváltozós differenciálhatóság definíciója szerint létezik olyan vektor, amellyel
és a maradéktag teljesíti a feltételt. Rögzítsünk egy irányt, és helyettesítsünk -t:
Mivel ,
tehát a differenciahányados határértéke . A esetre mindkét oldal nulla.
A lemma közvetlen következménye a legmeredekebb változás iránya. Ha , akkor a Cauchy–Schwarz-egyenlőtlenséggel
és egyenlőség pontosan akkor áll, ha (pozitív gradiensű irány). A gradiens iránya tehát a legmeredekebb növekedés iránya, nagysága pedig az egységnyi hosszúságú lépésre jutó maximális növekedés. A negatív gradiens iránya a legmeredekebb csökkenésé; erre épül majd a gradienslépés a 6.1. Objektív, reguláris tag és gradienslépés alfejezetben.
A parciális deriváltak puszta létezése nem elegendő ahhoz, hogy a fenti lineáris közelítés igaz legyen. A pontos definíció a következő. Az függvény differenciálható (differentiable) az pontban, ha létezik olyan vektor, amellyel
Ekkor az vektor éppen a gradiens: . Szavakkal: a függvény jól közelíthető egy lineáris funkcionállal, és a hiba a -nál gyorsabban tart nullához. A gradiens ennek a lineáris funkcionálnak a reprezentánsa a standard belső szorzatban.
A gyakorlatban hasznos elégséges feltétel a következő.
Tétel (folytonos parciális deriváltak). Ha az függvény minden parciális deriváltja létezik az egy környezetében, és azok folytonosak az pontban, akkor differenciálható -ben.
A tétel bizonyítása az egyváltozós középértéktétel koordinátánkénti alkalmazásával történik; a teljes levezetést itt nem ismételjük meg, mert a 4.1. Függvény, határérték és derivált nem építette fel a többváltozós középértéktételt. Az állítás standard anyag, lásd [B01] többváltozós differenciálszámítási fejezeteit (a forrásstátuszt a fejezet végi lista rögzíti). A fontos gyakorlati üzenet: ha a parciális deriváltakat zárt képletből, folytonos elemi műveletekkel kapjuk, a differenciálhatóság általában teljesül; a nem folytonos pontokban külön vizsgálat szükséges.
A neurális hálózatok tanításában gyakran előforduló kvadratikus veszteség a következő. Legyen a batchelt bemenet ( megfigyelés, jellemző), a célvektor, a paramétervektor. A közönséges legkisebb négyzetek felezett négyzetösszege:
A konstans a későbbi gradiens egyszerűsítésére szolgál; a minimum helyét nem befolyásolja. Számítsuk ki a -edik parciális deriváltat komponensenként. Az lineáris kifejezés szerinti deriváltja . A láncszabály és az összeg deriválási szabálya szerint
Mivel ez minden -re fennáll, a teljes gradiens:
Ez a levezetés a könyv saját kidolgozása; a mátrixderivált-szabályok ugyanezt adják. Az alakellenőrzés kulcsa: , , így a szorzat dimenziós, pontosan a alakja. A bias nélküli lineáris réteg veszteségének gradiense ezzel a képlettel számítható; a biasos affin esetben a konstans tag deriváltja a konstans bemenetre vonatkozó képletben kap szerepet, de ezt a 4.3. Jacobi-mátrix, láncszabály és VJP és 10.2. Affín réteg és aktiváció backward fejti ki.
Egy szinthez tartozó kontúrvonal vagy szintvonal (contour, level set) az
halmaz. Két paraméter esetén ez a felület szintvonala; magasabb dimenzióban szintfelületről beszélünk.
Lemma (gradiens merőleges a szintvonalra). Legyen differenciálható, és legyen differenciálható görbe a szintvonalon, . Ekkor
vagyis a gradiens merőleges a szintvonal pontbeli érintőjére.
Bizonyítás. Mivel minden -re, konstans. Deriváljuk mindkét oldalt szerint a pontban. A láncszabály és az iránymenti derivált lemma szerint
Ez pontosan a merőlegességi állítás.
A lemma indokolja, miért mutat a gradiens a szintvonalakra merőlegesen: ha egy szintvonalon mozogva a függvényérték nem változik, akkor a leggyorsabb változás irányának merőlegesnek kell lennie erre a mozgásra. A gradiens iránya ezen felül a növekvő függvényértékek felé mutat; nagysága heurisztikusan a szintvonalak sűrűségéhez köthető, de ez utóbbi nem pontos, általános tétel, csak szemlélet.
Tekintsük a
kétparaméteres veszteséget. A parciális deriváltak:
tehát a gradiens
A pontban:
Ellenőrizzük először az iránymenti deriváltat a irányban. A lemmából . Numerikusan, mellett a differenciahányados:
a számított közelítésben -hez közeli értéket ad; a részletes numerikus kontrollt a labor F3 feladata végzi el.
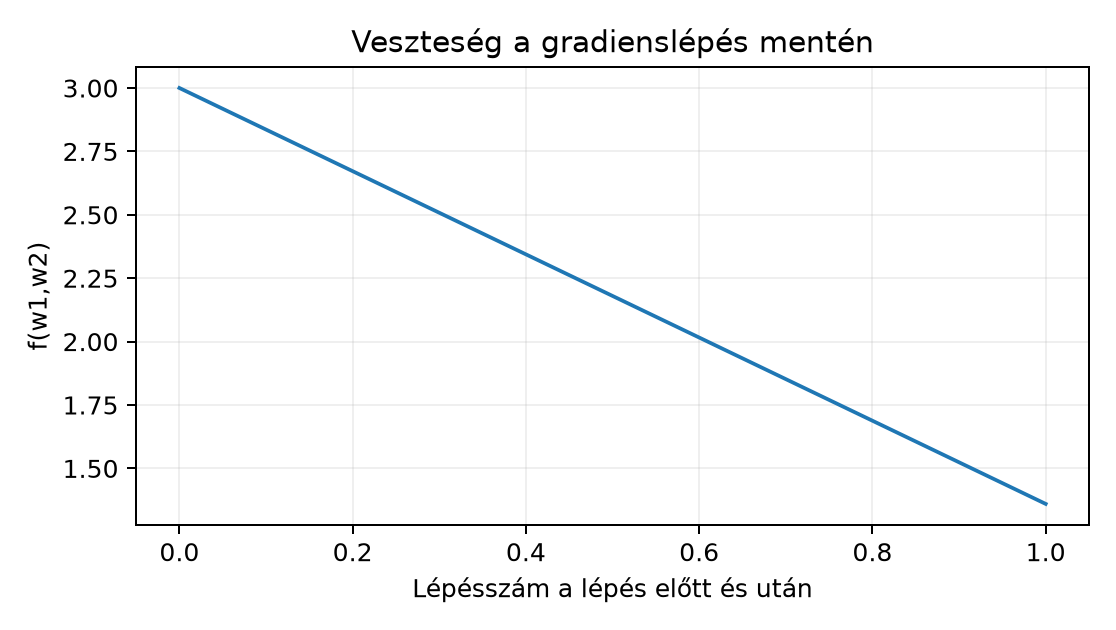
Végezzünk egy gradienslépést lépésközzel a negatív gradiens irányában:
Az új függvényérték:
ami kisebb, mint a kezdeti . A lépés irányában a veszteség tehát csökkent. Hangsúlyozzuk: ez egy konkrét numerikus példa, nem általános konvergenciaállítás; a lépésköz megválasztásának feltételeit a 6.2. Konvexitás és sima optimalizálási határ tárgyalja.
A labor a fenti
függvényre rajzol szintvonalakat és egy gradienslépést, majd kézzel
ellenőrzi a lépést. A kód NumPy-t és Matplotlibet használ; a függvény
számításához float64 típust, a kiindulóponthoz
értéket rögzítünk.
# lab/n014_grad_demo.py
# Futtatas: python lab/n014_grad_demo.py
import numpy as np
import matplotlib.pyplot as plt

def f(w):
    w = np.asarray(w, dtype=np.float64)
    return (w[0] - 1.0) ** 2 + 2.0 * (w[1] + 1.0) ** 2

def grad_f(w):
    w = np.asarray(w, dtype=np.float64)
    return np.array([2.0 * (w[0] - 1.0),
                     4.0 * (w[1] + 1.0)], dtype=np.float64)

w0 = np.array([2.0, -2.0], dtype=np.float64)
eta = 0.1
g0 = grad_f(w0)
w1 = w0 - eta * g0
print("w0 =", w0, " f(w0) =", f(w0))
print("grad f(w0) =", g0)
print("w1 =", w1, " f(w1) =", f(w1))

# Szintvonalak es a lepes szamitott abrazolasa
w1_vals = np.linspace(-1.0, 3.0, 101)
w2_vals = np.linspace(-3.0, 1.0, 101)
W1, W2 = np.meshgrid(w1_vals, w2_vals)
F = (W1 - 1.0) ** 2 + 2.0 * (W2 + 1.0) ** 2
plt.contour(W1, W2, F, levels=[0.25, 0.5, 1.0, 2.0, 4.0])
plt.quiver(w0[0], w0[1], -eta * g0[0], -eta * g0[1],
           angles='xy', scale_units='xy', scale=1,
           color='tab:red', width=0.012)
plt.scatter([w0[0], w1[0]], [w0[1], w1[1]], color='black', s=25)
plt.gca().set_aspect('equal')
plt.xlabel('w1')
plt.ylabel('w2')
plt.title('Gradiens lepes: szamitott szemleltetes')
plt.savefig('lab/n014_grad_step.png', dpi=120)
A kézirat ezt a kódot nem futtatta; az alábbi kimenet ezért analitikus kézzel számított érték, nem mért futás. A futtatás után a várt értékek:
w0 = [ 2. -2.]  f(w0) = 3.0
grad f(w0) = [ 2. -4.]
w1 = [ 1.8 -1.6]  f(w1) = 1.36
A lépés szemléltetése a szintvonalakkal együtt:
Az ábra és a kimenet ellenőrzése három ponton történik: a gradiens értéke ; a frissített pont ; a veszteség -ról -ra csökken. Ha a lépés irányát a pozitív gradiensre cserélnénk, a veszteség nőne; ez a labor lehetséges negatív kontrollja.
F1 (fogalmi, nehézség 1). Definiálja pontosan a parciális deriváltat és a gradienst egy függvényre. Magyarázza el, miért nem elegendő a három parciális derivált létezése a differenciálhatósághoz. Adjon rövid ellenpélda-vázlatot.
F2 (levezetési, nehézség 2). Legyen . Számítsa ki vektort, a irányú iránymenti deriváltat, és a legmeredekebb növekedés irányába mutató egységvektort az pontban. Ellenőrizze az eredményt a definíciójából is egy konkrét kis -ra.
F3 (implementációs, nehézség 2). Írjon Python
függvényt, amely centrális differenciával közelíti egy
függvény gradiensét:
.
Használja a labor
függvényét,
,
float64 típust és a
pontot. Az elvárt átadandó eredmény: a numerikus gradiens és az
analitikus
közötti abszolút hiba mindkét komponensben
alatt van.
F4 (hibakeresési, nehézség 2). A következő függvény a labor gradiensét hivatott számítani:
def hibas_grad(w):
    w = np.asarray(w, dtype=np.float64)
    return np.array([4.0 * (w[0] - 1.0),
                     2.0 * (w[1] + 1.0)], dtype=np.float64)
A pontban a helyes gradiens , a függvény azonban értéket ad. Lokalizálja a hibát, magyarázza el a következményét egy gradienslépésre, javítsa a kódot, és ellenőrizze a javítást ugyanabban a pontban.
F5 (kísérleti/transzfer, nehézség 3). Tervezzen protokollt annak ellenőrzésére, hogy a negatív gradiens irányú lépés mikor csökkenti a veszteséget. Megfigyelési egység: egy rögzített pont; a változó tényező: a lépésköz; a metrika: előjeles különbség. Számítsa ki a labor függvényére a , eseteket, és indokolja, miért nő a veszteség -nál. Adja meg, milyen további értékeket vizsgálna, és mi a kísérlet érvényességi korlátja.
F1 megoldás. A parciális derivált definíciója esetén -ra:
ahol a háromdimenziós standard bázisvektor. A gradiens
A puszta létezés nem elég, mert a differenciálhatóság ennél erősebb, közös lineáris közelítést követel: a maradéktagnak minden irányból -nál gyorsabban kell nullához tartania. Ellenpélda-vázlat: az origón kívül , az origóban ; mindkét parciális derivált létezik és nulla az origóban, de a függvény nem folytonos ott, így nem differenciálható.
F2 megoldás. A parciális deriváltak és . A pontban:
Az iránymenti derivált a lemma alapján . A normájú vektor miatt az egységirányra normált érték . A legmeredekebb növekedés egységvektora . Numerikus ellenőrzés -tel: , így a differenciahányados -hoz tart; a melletti eltérés , mert sima.
F3 megoldás. A teljes függvény:
import numpy as np

def f(w):
    w = np.asarray(w, dtype=np.float64)
    return (w[0] - 1.0) ** 2 + 2.0 * (w[1] + 1.0) ** 2

def numerical_grad(f, w, h=1e-5):
    w = np.asarray(w, dtype=np.float64)
    g = np.zeros_like(w)
    for i in range(w.size):
        e = np.zeros_like(w)
        e[i] = 1.0
        g[i] = (f(w + h * e) - f(w - h * e)) / (2.0 * h)
    return g

w = np.array([2.0, -2.0], dtype=np.float64)
g_num = numerical_grad(f, w)
g_an = np.array([2.0, -4.0], dtype=np.float64)
print("numerikus:", g_num)
print("abszolut hiba:", np.abs(g_num - g_an))
A centrális differencia csonkolási hibája és a lépésköz melletti kerekítési hiba együttesen nagyságrendű eltérést ad, ami bőven a korlát alatt van. A kódot a hallgató futtassa; a kézirat itt nem állít mért kimenetet, csak a képletből következő várt értéket.
F4 megoldás. A hiba oka: a hibas_grad a
szerinti parciális derivált együtthatójának
helyett
-et,
a
szerintinek
helyett
-t
használ; a két komponens együtthatója fel van cserélve. Következmény: a
frissítés
mellett
lenne, ami a helyes
helyett rossz irányú és hibás nagyságú lépést ad; a
ebben a konkrét pontban még csökkenhetne ugyan, de más pontokban
növekedést is okozhat, és a tanítás torzul. Javítás: az együtthatókat
rendre
-re
és
-re
kell cserélni:
def javitott_grad(w):
    w = np.asarray(w, dtype=np.float64)
    return np.array([2.0 * (w[0] - 1.0),
                     4.0 * (w[1] + 1.0)], dtype=np.float64)
Ellenőrzés a
pontban: javitott_grad(w) értéke
,
megegyezik az analitikus gradienssel.
F5 megoldás. A protokoll rögzíti a pontot és a gradienst. A változó az lépésköz, a kimenet . Számolás:
A növekedés oka: a kvadratikus függvény mentén a gradiens maga is változik; túl nagy lépésköz átugorja a minimumot, és a túloldalon nagyobb értéket talál. A kísérlet ezért csak azt állíthatja, hogy elég kis -ra a lépés csökkenti a veszteséget, nem azt, hogy minden -ra csökken. Tovább vizsgálandó értékek: a csökkenés tartományának határához; az érvényességi korlát, hogy az eredmény erre az egy függvényre és pontra vonatkozik, nem általános optimalizálási garancia.
A leggyakoribb tévedés: ha minden parciális derivált létezik egy pontban, akkor a függvény ott differenciálható. Ez hamis. A klasszikus ellenpélda a
függvény. Az origóban mindkét parciális derivált létezik és nulla:
és szimmetrikusan . A függvény mégsem differenciálható az origóban, mert nem is folytonos ott: az egyenes mentén , ami nem tart a -hoz, ha . A 4.1. Függvény, határérték és derivált alfejezetbeli egyváltozós tétel analógiája itt is érvényes: a differenciálhatóságból következik a folytonosság, ezért a folytonosság hiánya kizárja a differenciálhatóságot. Ráadásul az irányú iránymenti derivált sem létezik, mert
nem konvergál esetén. A gradiens-képletből számított tehát nem adná a tényleges iránymenti viselkedést; ez is mutatja, hogy a lemma feltétele, a differenciálhatóság, lényeges.
Ellenőrizze a fejezet állításait három ponton. (1) A kvadratikus veszteség gradiensének alakja: , , esetén , azonos alakú a paraméterrel. (2) Az iránymenti derivált homogenitása: a definícióból közvetlenül látszik, és a lemmával is konzisztens. (3) A kontúr-merőlegesség: a szintvonalon konstans, így az érintő irányú derivált nulla. Visszahívás a 3.2. Mátrixszorzás és affín réteg alfejezetből: a mátrixszorzás alak-egyeztetése itt a gradiens alakjának ellenőrzésében ismétlődik; a 4.1. Függvény, határérték és derivált alfejezetből: az egyváltozós határértékes definíciót terjesztettük ki irányonként.
A parciális derivált egy többváltozós függvény egy koordinátája szerinti, rögzített többi változójú deriváltja. A gradiens a parciális deriváltak oszlopvektora, alakja az input alakjával egyezik. Az iránymenti derivált a irányú egyváltozós derivált; differenciálható függvény esetén . Ebből következik, hogy a gradiens a legmeredekebb növekedés iránya, és merőleges a szintvonalakra. A differenciálhatóság erősebb, mint a parciális deriváltak létezése: a lineáris közelítés maradékának minden irányból -nál gyorsabban kell nullához tartania. A kvadratikus veszteség gradiense ; a labor ezt két paraméteren, kézi értékekkel és gradienslépéssel ellenőrizte.
A 4.3. Jacobi-mátrix, láncszabály és VJP a többváltozós láncszabályt és a Jacobi-mátrixot vezeti be. A gradiens itt tanult alak-egyeztetése ott válik a vektor–Jacobi-szorzat alapjává: a rétegenkénti visszafelé számításban a skalár veszteség gradiense mindig a megfelelő tensor alakjában jelenik meg.