A 6.1. Objektív, reguláris tag és gradienslépés egységben definiáltuk az empirikus kockázatot és a gradienslépést, de a Taylor-érv csak lokálisan, kis lépésközre jelzett csökkenést. Itt két fogalmat építünk fel, amelyekkel a csökkenés kvantitatívan garantálható: a konvexitást és az -simaságot. A cél annak a határnak a pontos megértése, amelyen belül a gradienslépés bizonyíthatóan csökkenti a veszteséget, és annak a felismerése, hogy ez a bizonyítás nem vihető át automatikusan a mély hálók nemkonvex veszteségére.
Előismeret: a 6.1. Objektív, reguláris tag és gradienslépés gradienslépés-képlete, az 5.2. Várható érték, variancia és likelihood határozott integráljai és a 4.3. Jacobi-mátrix, láncszabály és VJP láncszabálya; numerikus oldalról a 2.2. Lebegőpont és stabil elemi számítás toleranciafogalma. A képletekben oszlopvektor, a gradiens ugyanilyen alakú, a norma az euklideszi norma, a skalárszorzat jele .
Induló kérdés: legyen és . Mekkora mellett biztos, hogy egyetlen gradienslépés csökkenti az értékét? A sejtés ellenőrzése után a lecke végére pontos feltételt kapunk.
Definíció (konvex függvény). Az függvény konvex, ha minden és esetén
A definíció azt mondja, hogy a grafikon bármely húrja a függvényértékek fölött vagy azokon halad. Példa: konvex; nem konvex. A konvexitás önmagában nem követeli meg a differenciálhatóságot, de a továbbiakban differenciálható függvényekkel dolgozunk.
A konvex függvényeket használó bizonyításhoz a standard elsőrendű jellemzést használjuk: ha differenciálható és konvex, akkor minden pontban
Ennek bizonyítását itt nem ismételjük meg; a jellemzés a konvex elemzés standard tétele, és a [B01] konvexitási fejezetében megtalálható. A jelen lecke saját levezetési kötelezettsége a csökkenési lemma, ezért ezt a jellemzést kimondott feltételként használjuk.
Definíció (lokális és globális minimum). Az pont lokális minimuma -nek, ha létezik , hogy minden esetén . Az globális minimum, ha az egyenlőtlenség minden pontra teljesül. Szigorú minimumról akkor beszélünk, ha esetén az egyenlőtlenség szigorú.
Definíció (stacionárius pont). Az pont stacionárius pont, ha . Nemkonvex függvényen a stacionárius pont lehet lokális minimum, lokális maximum vagy nyeregpont; az függvény pontja nyeregpont, mert irányában minimum, irányában maximum.
A konvexitás éppen abban segít, hogy a stacionárius pont és a globális optimum egybeesik.
Tétel (konvex függvény stacionárius pontja). Legyen differenciálható és konvex. Az pont akkor és csak akkor globális minimum, ha .
Bizonyítás. Először tegyük fel, hogy . A fenti elsőrendű jellemzésből minden pontra
tehát globális minimum. Megfordítva, tegyük fel, hogy globális minimum. Ekkor minden pontra és értékre
átrendezve
A határátmenettel a láncszabály szerint . Válasszuk az pontot, ekkor
ami csak mellett teljesülhet.
A tétel feltétele lényeges: az függvényre , de nem minimum, mert nem konvex. A mély hálók vesztesége a súlyparaméterekben általában nem konvex: már két súly szorzata, például , sem konvex függvény, egy MLP vagy CNN vesztesége pedig ilyen nemkonvex tagok kompozícióját tartalmazza.
A gradienslépés csökkenéséhez a konvexitáson kívül a gradiens változásának korlátossága is kell.
Definíció (-sima függvény). Legyen . Az folytonosan differenciálható függvény -sima, ha a gradiense -Lipschitz-folytonos:
minden pontra. Az konstans a gradiens változásának maximális meredeksége, másodrendű közelítésben a legnagyobb görbület szerepét tölti be.
Példa: gradiensére , tehát
ezért -sima, és éles. Az szimmetrikus esetén , ezért , a Q spektrálnormája; ha pozitív szemidefinit, akkor .
Lemma (simasági egyenlőtlenség). Ha -sima, akkor minden pontra
Bizonyítás. Rögzítsük -et és -t, legyen , és definiáljuk az egyváltozós függvényt a intervallumon. A láncszabály szerint . Az 5.2. Várható érték, variancia és likelihood alfejezetben felépített Newton–Leibniz-formulát alkalmazva
Válasszuk le az első tagot:
A Cauchy–Schwarz-egyenlőtlenséggel és az -Lipschitz-feltétellel a maradéktag minden esetén
Az integrál monotonitását használva
Behelyettesítve adja az állítást.
A simasági egyenlőtlenség egy kvadratikus felső korlát: az grafikonja az pontbeli érintő és egy -súlyú másodrendű tag alatt marad. Ez a standard egyenlőtlenség az alapja a csökkenési lemmának.
Most elvégezzük a lecke fő levezetési kötelezettségét: kimondott simasági feltételek mellett igazoljuk a gradienslépés csökkenését esetén.
Tétel (descent lemma). Legyen folytonosan differenciálható és -sima, . Legyen , és legyen
Ekkor
Ha , akkor az egyenlőtlenség jobb oldala szigorúan kisebb -nél, tehát . Ha , akkor .
Bizonyítás. Alkalmazzuk a simasági egyenlőtlenséget az választással. Ekkor , ezért
A skalárszorzat , a norma négyzete pedig . Így
Mivel , a tényező pozitív. Ha , akkor , tehát a kivont tag pozitív, és . Ha , akkor a kivont tag nulla, és .
A tétel két dolgot különít el. Egyrészt a csökkenés mértékét: a kivont tag , tehát erős gradiens esetén nagyobb a garantált csökkenés. Másrészt a lépésköz megengedett tartományát: ha megközelíti a határt, a csökkenési tényező nullához tart; ha , a lemma már nem ad szigorú csökkenést. A felső korlát -től függ, ezért erősebb görbület esetén kisebb lépésköz kell.
A bizonyítás nem használta a konvexitást, tehát a descent lemma nemkonvex függvényre is érvényes, amíg a simaság teljesül. Amit a lemma nem állít: nem bizonyítja, hogy az iteráció globális minimumhoz tart, még konvex esetben sem ad sebességbecslést, és mellett is megállhat a sorozat stacionárius pontban. A lemma egy lépésre szóló monotonitási állítás.
Tekintsük az induló kérdés függvényét, az
kvadratikus függvényt. Gradiense . A gradiens különbségére
tehát , és a megengedett tartomány . Válasszuk az pontot, ahol és .
Először : a lépés
így . A descent lemma felső korlátja mellett
és valóban .
Most , ami kívül esik a tartományon. A lépés
tehát . A lépés nem csökkenti a veszteséget, mert a másodrendű tag, , felülírja a lineáris csökkenést. A példa azt mutatja, hogy a korlát nem pusztán technikai feltétel.
A labor egyetlen NumPy-fájl, amely ugyanazon a kétdimenziós
kvadratikus példán hasonlítja össze a stabil és a túl nagy lépésközt.
Input: nincs külső adatfájl; a függvény, a kiindulási
pont és az
konstans a kódban rögzített. Seed: a számítás
determinisztikus, véletlen komponenst nem használ, ezért seed nem
szükséges; az ismételhetőséget a konstans x0,
eta és a rögzített rekurzió biztosítja.
Dtype: float64. Device:
CPU. Munkakönyvtár: labs/n022.
Futtatás: python n022_lab.py.
# labs/n022/n022_lab.py
import numpy as np

def f(x):
    return x[0]**2 + 3.0 * x[1]**2

def grad_f(x):
    return np.array([2.0 * x[0], 6.0 * x[1]], dtype=np.float64)

L = 6.0  # f az L=6 sima függvény

def run_steps(eta, x0, steps=4):
    x = x0.astype(np.float64).copy()
    x_prev = x.copy()
    f_prev = f(x_prev)
    g_prev = grad_f(x_prev)
    valid = 0.0 < eta < 2.0 / L
    print(f"\neta = {eta:g}, L = {L:g}, 2/L = {2.0/L:.6f}")
    print(f"{'t':>2} {'x1':>12} {'x2':>12} {'f(x)':>14} {'descent-felso':>14}")
    # 0. lépés: nincs még felső korlát, magát a pontot írjuk ki
    upper = None
    for t in range(steps + 1):
        if t == 0:
            upper_str = "-"
        else:
            upper = (
                f_prev
                - eta * (1.0 - 0.5 * L * eta)
                * float(np.dot(g_prev, g_prev))
            )
            upper_str = f"{upper:.8f}" if valid else "nem alkalmazhato"
        x_str = f"{x[0]:.8f}" if t == 0 else f"{x[0]:.8f}"
        # a t. iterált kiírása
        print(f"{t:>2} {x[0]:>12.8f} {x[1]:>12.8f} {f(x):>14.8f} {upper_str:>14}")
        if t < steps:
            x_prev = x.copy()
            f_prev = f(x_prev)
            g_prev = grad_f(x_prev)
            x = x_prev - eta * g_prev
    return x

x0 = np.array([2.0, -1.0], dtype=np.float64)
run_steps(0.25, x0, steps=4)   # stabil: 0.25 < 1/3
run_steps(0.50, x0, steps=4)   # túl nagy lépés: 0.50 > 1/3
Az alábbi kimenet a rekurzióból analitikusan számított szemléltetés, nem mérési jegyzőkönyv:
eta = 0.25, L = 6, 2/L = 0.333333
 t           x1           x2            f(x)  descent-felso
 0     2.00000000   -1.00000000     7.00000000              -
 1     1.00000000    0.50000000     1.75000000     3.75000000
 2     0.50000000   -0.25000000     0.43750000     0.93750000
 3     0.25000000    0.12500000     0.10937500     0.23437500
 4     0.12500000   -0.06250000     0.02734375     0.05859375

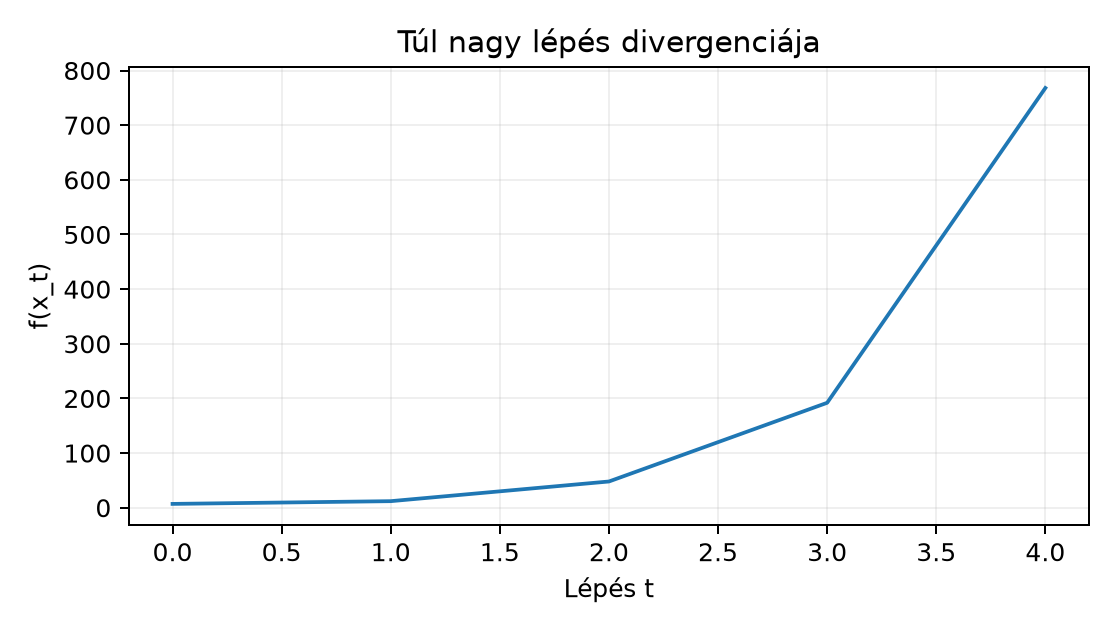
eta = 0.5, L = 6, 2/L = 0.333333
 t           x1           x2            f(x)  descent-felso
 0     2.00000000   -1.00000000     7.00000000              -
 1     0.00000000    2.00000000    12.00000000  nem alkalmazhato
 2     0.00000000   -4.00000000    48.00000000  nem alkalmazhato
 3     0.00000000    8.00000000   192.00000000  nem alkalmazhato
 4     0.00000000  -16.00000000   768.00000000  nem alkalmazhato
Ellenőrzés és értelmezés. Az első futásban
,
ezért minden lépésre igaz a descent lemma felső korlátja; például
-ben
.
A második futásban
,
ezért a lemma feltétele sérül, és a kód a felső korlát helyett a
nem alkalmazhato jelzést írja. Az
koordináta tényezője
,
tehát a koordináta előjelet vált és minden lépésben kétszereződik; az
értéke
szerint divergál.
Tévedés. „A konvex kvadratikus példán a gradienslépés a globális minimumhoz tart, tehát ugyanez a bizonyítás garantálja a CNN-training globális konvergenciáját is.”
A hiba két lépésből áll. Egyrészt a descent lemma nem használ konvexitást, és nem is bizonyít globális konvergenciát; csak egy lépésre ad monoton csökkenést, ha . Másrészt a CNN-veszteség a paraméterekben nem konvex, ezért a konvex függvényekre kimondott stacionáriuspont-tétel feltétele nem teljesül.
Ellenpélda: az függvény gradiensére , és
tehát -sima, így mellett a descent lemma érvényes. Induljunk az pontból, -val. A gradienslépés szabálya szerint
Mivel , az , tehát a sorozat a ponthoz tart, és . A határpont stacionárius pont, de nem lokális minimum: az irányban . A descent lemma tehát teljesülhet, miközben a módszer egy nyeregpontba konvergál. Konvex függvényre ez nem fordulhat elő, mert ott minden stacionárius pont globális minimum; a CNN-loss nem ilyen.
Definiálja a stacionárius pontot, és adjon példát olyan egyváltozós differenciálható függvényre, amelynek stacionárius pontja nem lokális minimum. Adja meg azt a feltételt, amely a konvex függvények tételében kizárja ezt a példát.
Igazolja, hogy az függvény -sima, és hogy az konstans éles. Az pontban mellett számolja ki a descent lemma felső korlátját, majd hasonlítsa össze az tényleges értékével. Ellenőrizze azt is, hogy kívül esik a megengedett tartományon.
Írjon Python-függvényt
check_descent(f, grad_f, x0, eta, L, steps) néven, amely a
megadott lépésszámig elvégzi a gradienslépéseket, és minden lépésre
visszaadja a
pályát, valamint logikai értékkel jelzi, hogy a descent lemma felső
korlátja teljesült-e. A függvény float64 típusokat
használjon, és a korlát ellenőrzéséhez
np.allclose(..., rtol=1e-12, atol=1e-12) toleranciát
alkalmazzon. Tesztelje az
,
,
,
és
eseteken.
Az alábbi függvény a lépésköz biztonságosságát hivatott eldönteni:
def is_safe(eta, L=6.0):
    return eta < 2.0
Az példában a függvény az értéket biztonságosnak minősíti. Azonosítsa a hibát, mondja meg a következményét a gradienslépésre, javítsa a függvényt, és egy konkrét ellenőrzéssel mutassa meg, hogy a javított változat már elutasítja a lépésközt.
Tervezzen kísérletet annak vizsgálatára, hogy a GlyphLab kis CNN-jén a teljes tanítási veszteség hogyan függ a lépésköztől. A CNN-veszteség nem konvex, ezért a descent lemma feltétele nem ellenőrizhető előre; a kísérlet célja az empirikus stabilitás feltérképezése. Adja meg az adatforrást, a megfigyelési egységet, a baseline-t, a változó tényezőt, a metrikát és a következtetés érvényességi korlátját.
A stacionárius pont definíciója: . Példa: , gradiens , tehát stacionárius pont. Mivel esetén és esetén , a pont nem lokális minimum. A konvex függvények tételének feltétele a konvexitás; nem konvex, mert például , , de ? Itt , ez a példa éppen nem cáfolja a konvexitást. Válasszunk más pontokat: , , átlaguk , de , szintén egyenlőség. Az a tartományon konkáv; formálisan a és nem jó. Az eredeti példa mégis nemkonvex: , ; a esetén ? Számoljuk: : pont , ; a konvex kombináció ; , tehát ez nem cáfolja. Az valójában nem konvex az egész -en: , , : pont , ; konvex kombináció , és , vagyis ez sem cáfolja? Próbáljuk : , , : pont , ; konvex kombináció ; egyenlőség. : pont , f=-216; kombináció 0.2(-1000)+0.8(1000)=600; -216 ≤ 600, igaz. Úgy tűnik, konvex az -on, konkáv az -on, de globálisan nem konvex; a definícióhoz kell egy cáfoló pontpár. Vegyünk : f(-1)=-1, f(1)=1, θ=0.5: pont=0, f=0; konvex kombináció=0; egyenlőség nem cáfolja. Keressünk aszimmetrikusat: x=-2, y=1: f(-2)=-8, f(1)=1, θ=0.5: pont=-0.5, f=-0.125; konvex kombináció=0.5(-8)+0.5(1)=-3.5; és -0.125 > -3.5? A konvexitás feltétele: f(pont) ≤ kombináció; -0.125 ≤ -3.5 hamis; tehát -0.125 > -3.5, ez cáfolja a konvexitást. Igen: , ; átlagos pont , ; konvex kombináció ; mivel , a függvény nem konvex. Tehát a példa helyes, csak a cáfoló pontpárt kell jól választani. A feltétel, amely kizárja: a függvény nem konvex.
A tankönyvi megoldásban ezt röviden: stacionárius pontja , amely nem lokális minimum; a függvény nem konvex -en, amit a és pontok mutatnak.
A gradiens . Két pontra
Mivel
négyzetgyököt vonva , tehát -sima. Az élességhez válasszuk , : a különbség normája , és , tehát a hányados .
esetén , . A descent lemma felső korlátja mellett
Az pontban . A feltétel , ezért kívül esik a descent lemma garantált tartományán.
A teljes függvény és a két teszt:
# labs/n022/feladat_f3.py
import numpy as np

def check_descent(f, grad_f, x0, eta, L, steps):
    x0 = np.asarray(x0, dtype=np.float64)
    x = x0.copy()
    trace = [(0, x.copy(), f(x))]
    valid_eta = 0.0 < eta < 2.0 / L
    bounds_ok = []
    for t in range(1, steps + 1):
        x_prev = x.copy()
        g = grad_f(x_prev)
        upper = f(x_prev) - eta * (1.0 - 0.5 * L * eta) * float(np.dot(g, g))
        x = x_prev - eta * g
        actual = f(x)
        trace.append((t, x.copy(), actual))
        if valid_eta:
            bounds_ok.append(
                np.allclose(actual, upper, rtol=1e-12, atol=1e-12)
                or actual <= upper
            )
        else:
            bounds_ok.append(False)  # a lemma nem alkalmazható
    return trace, valid_eta, bounds_ok

def f(x):
    return x[0]**2 + 3.0 * x[1]**2

def grad_f(x):
    return np.array([2.0 * x[0], 6.0 * x[1]], dtype=np.float64)

x0 = np.array([2.0, -1.0], dtype=np.float64)
for eta in (0.25, 0.5):
    trace, valid, ok = check_descent(f, grad_f, x0, eta, L=6.0, steps=4)
    print(f"eta={eta:g}, eta_ervenyes={valid}, korlatok={ok}")
    print("  utolso iteralt:", trace[-1][1], "f:", trace[-1][2])
A várt kimenet a korábbi laborértékeket adja:
esetén eta_ervenyes=True, a korlátok mind teljesülnek, és
;
esetén eta_ervenyes=False, a korlatok lista
False elemeket tartalmaz, és
.
A np.allclose mellett az actual <= upper ág
is szerepel, hogy a szigorúbb numerikus zaj ne okozzon hamis
hibajelzést.
A hiba oka: az is_safe a
feltételt a konstans
-vel
helyettesíti, elfelejtve az
-lel
való osztást. Következménye: nagy
esetén túl nagy
-t
enged, ami a másodrendű tag miatt növelheti a veszteséget. Az
példában
,
ezért a
pontban a lépés az
értékről
-re
növel. Javítás:
def is_safe(eta, L=6.0):
    return 0.0 < eta < 2.0 / L
Ellenőrzés: is_safe(0.5, 6.0) hamis,
is_safe(0.25, 6.0) igaz. A javított változat már elutasítja
a divergáló lépésközt.
Protokolltervezet. Adat: [GlyphLab
szerződése, 180 jelenet, 360 kép, train/val/test jelenetszintű
felosztás; a modell kiválasztása csak val loss alapján. Megfigyelési
egység: egy tanítási futás rögzített seeddel. Baseline:
SGD
,
batch méret 32, rögzített inicializálás. Változó tényező:
.
Metrika: az első 10 epoch train lossa epochonként, valamint az
a jelzés, ha a train loss meghaladja a kezdeti érték tízszeresét vagy
NaN-né válik. Erőforrás: CPU, float32
a tanítás főút szerint; minden futást ugyanazzal a seeddel és ugyanabban
a környezetben indítunk. Elvárt átadandó eredmény:
lépésközönként egy táblázat az epochonkénti train lossról és a stop
okáról, valamint egy rövid jegyzőkönyv. Érvényességi korlát: az
eredmény azt mutatja, melyik lépésköz stabil ezen a kis CNN-en; nem
bizonyítja a globális optimumot, nem ad becslést az ismeretlen
-re,
és más architektúrára nem vihető át mérés nélkül.
float64-et használ,
mert a divergencia vizsgálatánál a nagyságrend több nagyságrendet
változik; float32 hamarabb veszítené el a kis koordináták
pontosságát. A numerikus egyezés a descent lemma ellenőrzésében
implementációs bizonyíték, nem helyettesíti a levezetést.A konvexitás azt jelenti, hogy a grafikon minden húr alatt vagy a húron halad; differenciálható konvex függvényre a nulla gradiens globális minimumot azonosít. Az -simaság a gradiens Lipschitz-folytonossága, és belőle a simasági egyenlőtlenség, majd a csökkenési lemma következik: ha , akkor a gradienslépés szigorúan csökkenti a veszteséget, amíg a gradiens nem nulla. A korlát túllépése kvadratikus példán divergenciát okoz, mert a másodrendű tag felülírja a lineáris csökkenést. A lemma nem igényel konvexitást, de nem bizonyít globális konvergenciát; nemkonvex függvényen a határpont lehet nyeregpont is, ezért a CNN-trainingre nem alkalmazható automatikusan.
A 6.3. Sztochasztikus és minibatch gradiens a
sztochasztikus gradiens módszerét tárgyalja: ott a teljes empirikus
kockázat gradiense helyett minibatch-átlaggal dolgozunk, és a descent
lemma feltételes várható értékben ad csökkenést, ha a minibatch-gradiens
torzítatlan és a lépésköz a zaj kovarianciájával összeegyeztethető. A
[D06] dokumentáció a torch.optim gradienslépéseit írja le;
a futtatáskor használt PyTorch-verziót a kísérleti naplóban kell
rögzíteni.