A 6.2. Konvexitás és sima optimalizálási határ egységben a teljes empirikus kockázat gradiensére épülő lépés csökkenési feltételét vizsgáltuk. A gyakorlatban nagy lehet, és minden lépésben darab mintánkénti gradiens kiszámítása drága. Ehelyett egy kisebb, véletlenül választott minibatch átlagával lépünk: ez a sztochasztikus gradiens módszer (SGD). Ehhez a gradiensbecslés fogalmára van szükség, amelyet az 5.3. Mintavételi bizonytalanság és intervallum egységből ismerünk: a becslő maga is véletlen változó, ezért torzításról és varianciáról beszélünk. A 2.3. Izolált környezet, notebook és verzió reprodukálhatósági elvei szerint a véletlen batchválasztás seedjét is rögzítenünk kell.
Induló kérdés. Egy mintás hálótanításnál méretű batch gradiensátlagát számoljuk. Vajon ez a részátlag várható értékben egyenlő a teljes gradienssel? És mekkora lehet egyetlen realizáció eltérése? Írjon le egy számpéldát, ahol a várható érték egyezik, de a konkrét batchérték távol van a céljától.
Legyen a paramétervektor, és legyen az -edik megfigyelés veszteségtagja . A teljes empirikus kockázat az átlagos veszteség:
A differenciálhatóság lineáris, ezért a teljes gradiens a mintánkénti gradiensek átlaga:
A vektor a paraméter-tenzorral azonos alakú: skalár paraméternél , egy -dimenziós súlyvektornál -dimenziós.
Minibatch-gradiens. Legyen egy elemű indexhalmaz, amelyet az összes részhalmaz közül egyenletesen, visszatevés nélkül választunk. A minibatch-gradiens
Az határeset a teljes batch gradiens (determinisztikus, adott mellett), az eset pedig a „tiszta” sztochasztikus lépés.
SGD-lépés. Az tanulási ráta mellett
A „sztochasztikus” jelző a választásának véletlenjére utal, nem a gradiensminták belső zajára. Az irányvektor a gradienszajjal is felírható:
ahol az hibatag eloszlása a mintavételi eljárásból származik.
Torzítatlanság. A becslő torzítatlan -ra, ha a batchválasztás szerinti várható értéke megegyezik a céllal:
Torzítatlanság esetén a gradienszaj feltételes várható értéke nulla: . A feltételes megfogalmazás azért hasznos, mert a tanítás során maga is véletlen; a batchválasztás azonban -től független.
Tétel 1 (egyenletes, visszatevés nélküli minibatch torzítatlansága). Legyenek egészek, olyan pont, ahol minden differenciálható, és . Ha az halmaz egyenletes eloszlású elemű részhalmaza visszatevés nélkül, akkor
Bizonyítás. Minden indexhez vezessük be az indikátort: , ha , különben . Ekkor
Mivel egyenletes eloszlású, az elem határvalószínűsége a kedvező részhalmaz és az összes részhalmaz aránya:
A várható érték linearitása (véges összeg, ezért a sorrendcsere jogos) és az indikátor várható értéke alapján
Ezzel a tételt beláttuk. A bizonyítás saját levezetés; a várható érték és a kovariancia alapfogalmai a [B01] hátterét követik. A tétel és esetén is érvényes.
A torzítatlanság csak az átlagos viselkedést írja le. A gyakorlati lépésben a zaj nagysága döntő, ezért a kovarianciát is megvizsgáljuk.
Állítás 2 (visszatevés nélküli batchzaj kovarianciája, ). Legyen és . Az egyenletes, visszatevés nélküli választás mellett
Levezetés. A vektorok oszlopvektorok, ezért -s mátrix. Az előző indikátoros alakból
Az indikátorok marginálisai és páronkénti valószínűségei:
és esetén
A azonosságot behelyettesítve, és a jelölést használva
A zárójel utolsó lépése a centrált négyzetösszeg szokásos kifejtése. Ezzel az állítás adódik.
A mátrix nyomára áttérve megkapjuk a gradienszaj skalár mértékét. Legyen
Ekkor
A tényező a véges sokasági korrekció (finite population correction). Visszatevéses mintavételnél ez a korrekció hiányzik, és a nyom lenne, mert a húzott pozíciók függetlenek. Visszatevés nélkül a kisebb miatt ritkábban fordul elő ismétlődő index, ezért a variancia kisebb.
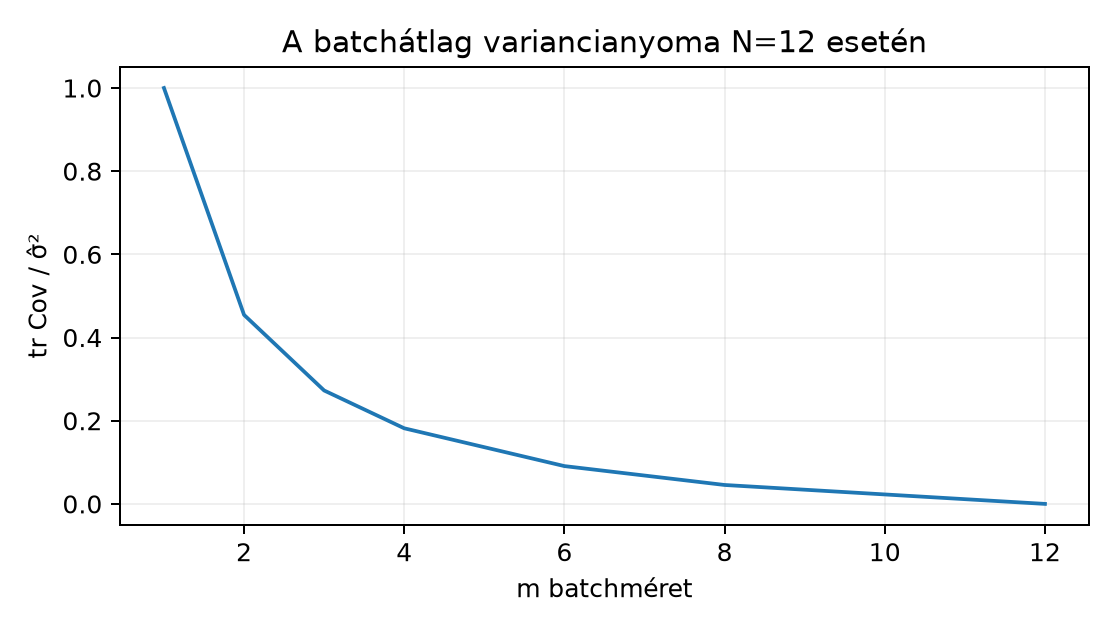
A variancia nullára csökken, ha , hiszen ekkor determinisztikusan a teljes gradiens. Az szélső esetben a képlet a populáció szerinti varianciát adja: . Ha , akkor nincs választási bizonytalanság, ezért a variancia nulla; a fenti képlet az nevező miatt ezt az esetet nem fedi le, külön kell kezelni.
A diagram a fenti képletből számolt elméleti görbe. A variancia nem lineárisan, hanem közelítőleg -szerűen csökken, de a véges korrekció miatt -nél pontosan nullát ér el.
A 6.2. Konvexitás és sima optimalizálási határ simasági egyenlőtlensége szerint -sima függvényre és tetszőleges irányra
Válasszuk a minibatch-gradienst, és vegyük a batchválasztás feltételes várható értékét. A torzítatlanság és a második momentum dekompozíciója szerint
A második azonosság az 5.3. Mintavételi bizonytalanság és intervallum négyzetes hibafelbontás vektoros alakja: a második momentum a várható érték normanégyzete plusz a variancianyom. Ezzel
Ez a levezetett egyenlőtlenség mutatja, hogy a zaj a jobb oldalon additív, -szeres tagot ad. Ha , a gradiensnormos tag csökkentő; ám ha a zaj varianciája ehhez képest nagy, a zárójelben lévő csökkenés eltűnhet, és a várható veszteség nőhet. Ez nem konvergenciabizonyítás: nem állítjuk, hogy a sorozat egy lokális minimumhoz tart; csupán egy lépés feltételes várható változását korlátozzuk. A minibatch-zaj varianciája a batchméret növelésével csökkenthető, de eközben a lépés számítási költsége nő.
Legyen , , és egy rögzített pontban a mintánkénti gradiensek
A teljes gradiens
Visszatevés nélkül, esetén a három lehetséges batchgradiens , és , átlaguk . esetén a három lehetséges pár átlaga:
Ezek átlaga . A becslő tehát mindkét batchméretnél torzítatlan. Ugyanakkor a konkrét realizációk szóródnak: például -nél a érték 3 egységgel tér el a teljes gradiensétől.
A variancia -nél
-nél pedig
A képlet ellenőrzése -re: , így . A batchméret duplázása tehát a varianciát a negyedére csökkentette.
Kérdés. Hogyan csökken a gradienszaj varianciája a batchméret növelésével, és egyezik-e a mért variancianyom a levezetett képlettel?
Protokoll. A labor nem tanít neurális hálót, csak a batchválasztás statisztikáját méri. Ezért darab szintetikus, dimenziós minta-gradienst generálunk egy rögzített reprezentációjaként; ezekre a becslő varianciáját számítjuk. Minden batchméretre húzást végzünk visszatevés nélkül. A mért kovariancianyom torzítatlan becslője
A kód float64 pontosságú, CPU-n fut, a seed a 2.3. Izolált környezet, notebook és verzió szerinti
reprodukálhatósághoz rögzített. A következő kimeneti váz
képletből számított ellenőrző célt mutat; a mért oszlopokat a
laborfuttatás tölti ki.
"""n023 labor: batchgradiens varianciája.

Futtatás: python n023_sgd_variance.py
"""
import numpy as np

rng = np.random.default_rng(20261020)
N, d, R = 12, 4, 20_000

# Szintetikus minta-gradiensek egy rögzített theta pontban.
# A labor csak a batchválasztás eloszlását méri.
G = rng.normal(size=(N, d)).astype(np.float64)
full = G.mean(axis=0)                      # teljes gradiens, (d,)
sigma2 = ((G - full) ** 2).sum() / N       # populációs variancianyom

def sample_trace(m):
    if m == N:
        # A teljes adathalmazt használó batchátlag nem véletlen.
        # A lebegőpontos átlagolás apró kerekítési eltérését ne mérjük zajnak.
        return 0.0, 0.0, 0.0
    draws = np.empty((R, d), dtype=np.float64)
    for r in range(R):
        idx = rng.choice(N, size=m, replace=False)
        draws[r] = G[idx].mean(axis=0)
    emp_mean = draws.mean(axis=0)
    emp = ((draws - emp_mean) ** 2).sum() / (R - 1)
    theo = (N - m) / (m * (N - 1)) * sigma2
    if theo > 0:
        rel = abs(emp - theo) / theo
    else:
        rel = 0.0 if emp == 0.0 else float("inf")
    return emp, theo, rel

for m in (1, 2, 4, 6, 12):
    emp, theo, rel = sample_trace(m)
    print(f"m={m:2d}  emp={emp:.6f}  theo={theo:.6f}  rel={rel:.4f}")
    assert rel < 0.05 or (theo == 0.0 and emp == 0.0), \
        "mintavételi vagy képlethiba jelölt értéknél"
A várt tulajdonság: -nél a legnagyobb a variancianyom, -nél matematikailag pontosan nulla a variancia; ezt a kód külön határesetként kezeli, hogy a lebegőpontos kerekítést ne tekintse véletlen zajnak, és a közbülső értékek a tényezőt követik. Ha a relatív eltérés tartósan fölé kerül, akkor többnyire visszatevéses húzást használunk, vagy a variancia becslőjében hibás a normalizálás. A megfigyelt csökkenés a gradienszaj mérnöki szabályozásának alapja: nagyobb batch kisebb zajt, de több számítást jelent lépésenként.
F1 (fogalmi, nehézség 1). Magyarázza el egy mondatban, mi a különbség egy torzítatlan gradiensbecslő eloszlása és egyetlen realizációja között. Adjon példát a fenti kézi példából arra, hogy egy realizáció messze van a teljes gradiensétől, miközben a becslő torzítatlan. Elvárt eredmény: a két fogalom definíciója és egy konkrét számpár.
F2 (levezetési, nehézség 2). Vezesse le a visszatevéses egyenletes mintavétel batchgradiensének kovarianciáját: mutassa meg, hogy , ahol . Számítsa ki , mellett a variancianyom szorzóját mindkét mintavételi módra, és indokolja a különbséget. Elvárt eredmény: teljes levezetés és a két numerikus tényező.
F3 (implementációs, nehézség 2). Írjon NumPy-függvényt, amely adott gradiensmátrixhoz, batchmérethez és ismétléshez visszaadja a mért variancianyomot és a Tétel 2 képletéből számolt elméleti értéket. Tesztelje a kézi példa , esetén , mellett; a mért érték -höz -nál közelebb legyen. Elvárt eredmény: kód, futtatási parancs és a megadott tolerancia teljesülése.
F4 (hibakeresési, nehézség 2). Valaki a következő PyTorch-kóddal húz batchindexeket, és közben azt hiszi, hogy visszatevés nélkül mintavételez:
idx = torch.randint(0, N, (m,))
g_batch = G[idx].mean(dim=0)
Mi a hiba, mi a következménye a varianciára, és hogyan javítható? Ellenőrizze a javítást az , határesettel. Elvárt eredmény: a hiba oka, következménye, javított kód és a határeset indoklása.
F5 (kísérlettervezési/transzfer, nehézség 3). Tervezzen protokollt annak eldöntésére, hogy egy dimenziós nemkonvex veszteség minimalizálásánál a batchméret növelése csökkenti-e a különböző seedekből származó végparaméterek szórását. Adja meg az adatot, a splitet, a baseline-t, a vizsgált batchméreteket, a lépésköltségvetést, a metrikát és legalább egy érvényességi korlátot. Elvárt eredmény: egy szöveges protokoll és indokolt alternatíva; a tényleges futtatás nem kötelező.
F1. A torzítatlanság a becslő eloszlásának várható értékére tett állítás: . Egyetlen realizáció ettől tetszőlegesen messze lehet. A kézi példában , realizáció: , a teljes gradiens , az eltérés . Ugyanez a becslő a három lehetséges felett átlagolva -t ad, tehát torzítatlan.
F2. Visszatevéses húzásnál a batch darab független és azonos eloszlású pozícióból áll. Egyetlen indexre várható értéke , kovarianciája , mert . Az átlag kovarianciája ezért
A nyom szorzója visszatevéssel ; visszatevés nélkül . Visszatevés nélkül ugyanazt az indexet nem húzhatjuk kétszer, ezért kevésbé „pazaroljuk” a batchpozíciókat ismétlésre; a variancia kisebb.
F3. Egy lehetséges megoldás:
import numpy as np

def variance_check(G, m, R, seed=20261020):
    N = G.shape[0]
    rng = np.random.default_rng(seed)
    full = G.mean(axis=0)
    sigma2 = ((G - full) ** 2).sum() / N
    draws = np.empty((R, full.shape[0]))
    for r in range(R):
        idx = rng.choice(N, size=m, replace=False)
        draws[r] = G[idx].mean(axis=0)
    emp = ((draws - draws.mean(axis=0)) ** 2).sum() / (R - 1)
    theo = (N - m) / (m * (N - 1)) * sigma2
    return emp, theo

G = np.array([[2.0], [5.0], [-1.0]])
emp, theo = variance_check(G, m=2, R=100_000)
print(emp, theo)
assert abs(emp - theo) < 0.02 * theo
A becslő torzítatlan, a húzás mellett a relatív szórás körülbelül , így a -os tűrés nagyvonalú. A normálás -gyel történik, mert ez a populációvariancianyom torzítatlan becslője.
F4. A torch.randint minden pozícióban
függetlenül húz, ezért ugyanaz az index többször is szerepelhet:
visszatevéses mintavétel. Következmény: a becsült gradiens torzítatlan
marad, de a variancia a nagyobb
képletet követi, és
esetén sem lesz determinisztikusan a teljes gradiens. A javítás:
idx = torch.randperm(N)[:m]
g_batch = G[idx].mean(dim=0)
A randperm garantáltan különböző indexeket ad. A
határeset
-nál:
a hibás kód akár az
indexhármast is húzhatja, így
,
ami általában nem a teljes gradiens; a javított változat mindig a három
különböző indexet adja, ezért
determinisztikusan teljesül.
F5. Lehetséges terv. Cél: a batchméret hatása a
végparaméter szórására. Adat: rögzített
szintetikus pont, nemkonvex
,
ahol
kétdimenziós kétgödrös veszteség. Split: nincs külön validációs
modellválasztás; a végső paramétert 400 lépés után rögzítjük. Baseline:
batchméret
.
Vizsgált értékek:
.
Mindegyikre
független seed. Metrika: a
végparaméter empirikus kovariancianyoma. Erőforrás: CPU,
float64, a seedet és a könyvtárverziót rögzítjük. Korlát: a
becsült szóródás a minimalizálási pálya tulajdonsága; a gradienszaj
varianciaképletéből nem következik, hogy a végső paraméterek szórása
pontosan
-szeres,
mert a nemkonvex pálya nemlineárisan torzíthat. Alternatíva: rögzített
epoch-költségvetés helyett rögzített gradiensevalutáció-szám is
választható, de az eltérő kérdésre ad választ.
Gyakori hiba azt hinni, hogy minden véletlen vagy adaptív batchválasztás automatikusan torzítatlan gradienst ad. A fenti tétel feltétele az egyenletes mintavétel. Súlyozott célfüggvénynél a korrekció nélküli átlag torzított.
Példa: legyen , a veszteségértékek , , , és a kívánt súlyozott cél . Ha egyenletesen húz, az átlag várható értéke . A helyes eljárás vagy a súlyokkal arányos mintavétel, vagy húzás utáni korrekciós súlyozás. A tanítási könyvtárak osztálysúlyozásánál ugyanez a korrekció szükséges, ha a cél a súlyozott empirikus kockázat gradiense.
Ellenőrző kérdések a szakasz után: (1) A tétel bizonyításában melyik lépés használja az egyenletes választást? (2) Mit ad a varianciaképlet -re, és miért nulla? (3) Miért kell a csökkenési egyenlőtlenségben feltételes várható értéket venni? Válaszok vázlata: (1) a határvalószínűség; (2) a véges korrekció tényezőt ad, mivel nincs választási véletlen; (3) mert maga is véletlen, és a zaj csak a batchválasztásból származik.
Visszahívás az 5.3. Mintavételi bizonytalanság és intervallum egységből: a becslő a minta függvénye, a becslés pedig egy konkrét realizáció; a torzítás és variancia a becslő eloszlásának tulajdonsága. A 6.2. Konvexitás és sima optimalizálási határ simasági egyenlőtlensége itt a zaj additív büntetőtagját adta, de a globális konvergencia továbbra sem következik belőle.
A minibatch-gradiens darab, egyenletesen választott minta gradiensének átlaga. A torzítatlansági tétel szerint várható értéke a teljes gradiens, feltéve, hogy a választás egyenletes és a paramétertől független. A bizonyítás indikátorokkal mutatja meg, hogy , majd a várható érték linearitását használja. A batchzaj varianciája a véges sokasági korrekcióval ; ez -nél nulla. A labor a mért variancianyomot hasonlítja a képlethez, a batchméret növelése tehát mérhetően csökkenti a lépés zaját. A torzítatlanság csak átlagos tulajdonság, ezért egy kis batch realizációja önmagában nem helyettesíti a teljes gradienst.
A 6.4. Momentum és adaptív optimizálók egységben a momentum és az adaptív optimizálók következnek. Ott az SGD-lépés zaját mozgóátlaggal simítjuk, illetve a második momentummal normáljuk a koordinátánkénti skálát. A most levezetett torzítatlansági és varianciaképlet lesz az alapja annak az elemzésnek, hogy a momentum miért csökkenti a pálya fluktuációját; a gyakorlati Adam/AdamW viselkedés azonban nem vezethető le pusztán ebből a zajmodellből.