A Northstar prediktív projektben a Modellcsalád
választása tudományos jegyzőkönyvvel modellválasztási jegyzőkönyv
logisztikus regressziót is vizsgált a késő szállítás előrejelzésére. A
lineáris modell viselkedése akkor értelmezhető jól, ha a numerikus
bemenetek összehasonlítható skálán vannak. Mielőtt azonban a skálázást
vakon elvégeznénk, szeretnénk látni, hogy a rendelésenkénti numerikus
jellemzők – distance_km, basket_minor,
quantity_sum – hány tényleges szóródási irányt hordoznak,
és melyik változó uralja az egyes irányokat. Ez az alfejezet a Sajátérték, SVD és dimenziócsökkentés előképe
szinguláris felbontás előképét alakítja konkrét
tanítótranszformációvá.
Bemenet: egy
numerikus mátrix; megfigyelési egység itt a rendelés,
a sorok száma,
a jellemzők száma. A labor tiszta orders.csv fájljában
sor érhető el, a példában a három közvetlenül rendelkezésre álló
numerikus oszlopot használjuk. Kimenet:
főkomponens (principal component, PC) iránya, a pontok
komponens-koordinátái (score-ok) és a komponensenkénti megmagyarázott
varianciahányad. Ellenőrzés: a komponens-score oszlopok
páronként korrelálatlanok, a varianciahányadok összege
komponens esetén
,
és a csökkentett térből visszaállított adat hibája a kihagyott
varianciával egyezik.
Előzetes becslés. A basket_minor
EUR-cent egységben mért kosárérték varianciája több nagyságrenddel
nagyobb, mint a kilométerben mért távolságé vagy a darabszámé. Ezért
nyers skálán az első főkomponenst várhatóan a basket_minor
egyedül uralja. Standardizálás után minden változó egységnyi
varianciával indul, így a komponensek a változók közötti korrelációs
szerkezetet mutatják, nem a mértékegységből fakadó
szóródáskülönbséget.
A centering (centrálás) azt jelenti, hogy minden oszlopból kivonjuk az oszlopátlagot. A -edik oszlop átlaga
a centrált mátrix eleme pedig . A centrált adat minden oszlopának átlaga .
A scaling (skálázás) legegyszerűbb változata a standardizálás vagy z-score transzformáció. A -edik oszlop korrigált mintaszórása
a standardizált elem pedig
.
Ekkor minden oszlop átlaga
,
szórása
;
a mértékegység eltűnik, a változók összehasonlíthatóvá válnak. A
StandardScaler a scikit-learnben pontosan ezt a két lépést
végzi.
A Sajátérték, SVD és dimenziócsökkentés előképe alfejezetben megismert SVD szerint a centrált mátrix felbontható
ahol bal szingulárvektorok mátrixa, diagonális, a főátlón a szinguláris értékekkel, pedig a jobb szingulárvektorok mátrixa; az adatmátrix rangja. A oszlopai a pontfelhő fő irányai, vagyis a főkomponens-irányok. A komponens-koordináták mátrixa
amelynek oszlopai a score-ok. A -edik irányra vetített adat varianciája
Ez a mennyiség az úgynevezett explained variance (megmagyarázott variancia): azt mutatja, mennyi szóródást visz a -edik komponens. A teljes variancia a centrált adat oszlopvarianciáinak összege, és egyenlő -vel, ha minden pozitív szinguláris értéket megtartunk. A explained variance ratio (megmagyarázott varianciahányad) a
érték; azt mondja meg, a teljes szóródás hányad részét fedi le az
adott komponens. A scikit-learn PCA objektuma a
components_ attribútumban a
mátrixot tárolja, tehát annak
-edik
sora a
-edik
PC irány terhelése (loading); az explained_variance_ a
-ket,
az explained_variance_ratio_ a fenti hányadokat adja
vissza.
Kézi kontroll. Legyen a nyers adat három pontja
Az oszlopátlag , ezért
A mintakovariancia-mátrix
A sajátértékek és ; a hozzájuk tartozó normalizált sajátvektorok
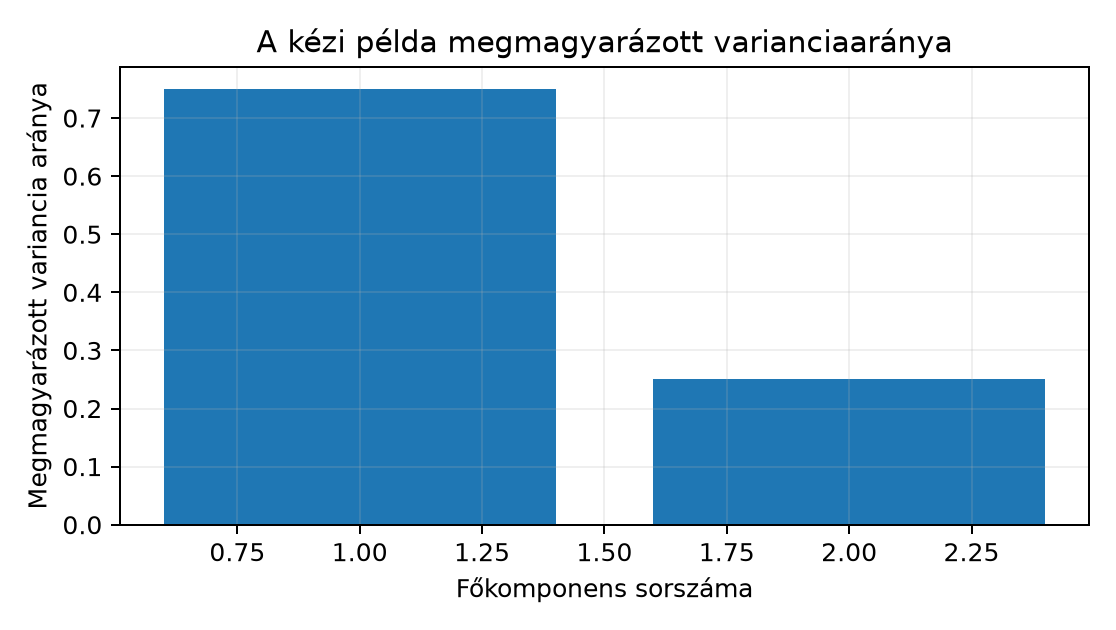
A varianciahányadok: és . A score-ok: az első pont első score-ja , a második ponté , a harmadiké ; a második komponensen rendre , és . Ez a kis példa a későbbi kódos ellenőrzés aranyalapja.
A levezetésből látszik a kulcsgondolat: a PCA a centrált adat kovarianciaszerkezetének sajátirányait keresi. Ha az elemek mértékegysége nagyon eltérő, a kovarianciamátrixot a nagy abszolút értékű változó uralja. A standardizálás után viszont a kovarianciamátrix éppen a korrelációs mátrixszá válik, mert minden -re.
Az alábbi kód két PCA-t futtat ugyanazon a mesterségesen generált, Northstar-stílusú adaton: először nyers skálán, majd standardizálás után. A generálás determinisztikus, így az összehasonlítás megismételhető. A kimenet itt szemléltető, mert a szöveget író modell nem futtatta a kódot; a várt tartományokat a generáló képletből vezetjük le.
import numpy as np
import pandas as pd
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

# Determinisztikus, Northstar-stílusú rendelésadatok.
# Mértékegységek: distance_km [km], basket_minor [EUR-cent],
# quantity_sum [darab]; a kosárérték erősen összefügg a távolsággal.
rng = np.random.default_rng(42)
n = 300
distance_km = rng.normal(40, 15, n)
basket_minor = 2500 + 40 * distance_km + rng.normal(0, 100, n)
quantity_sum = rng.poisson(4, n) + 1
X = pd.DataFrame({
    "distance_km": distance_km,
    "basket_minor": basket_minor,
    "quantity_sum": quantity_sum.astype(float),
})

# Nyers PCA. A sklearn itt is centrál, de nem standardizál.
pca_raw = PCA(n_components=3)
T_raw = pca_raw.fit_transform(X)
print("Nyers loadings (soronként egy PC irány):")
print(pca_raw.components_)
print("Nyers arány:", pca_raw.explained_variance_ratio_)

# Standardizált PCA.
scaler = StandardScaler()
Z = scaler.fit_transform(X)
pca_std = PCA(n_components=3)
T_std = pca_std.fit_transform(Z)
print("Standardizált loadings:")
print(pca_std.components_)
print("Standardizált arány:", pca_std.explained_variance_ratio_)

# Invariáns ellenőrzés: a score-ok off-diagonális kovarianciája nulla.
score_cov = np.cov(T_std.T)
print("Score kovariancia off-diag maximuma:",
      np.max(np.abs(score_cov - np.diag(np.diag(score_cov)))))

# Rekonstrukció egy komponenssel a standardizált térben.
pca_1 = PCA(n_components=1)
Z_score_1 = pca_1.fit_transform(Z)
Z_reconstructed = pca_1.inverse_transform(Z_score_1)
reconstruction_var = np.var(Z - Z_reconstructed, axis=0).sum()
print("Rekonstrukciós hiba teljes varianciája 1 komponens után:",
      reconstruction_var)
print("Kihagyott variancia a modell szerint:",
      pca_1.explained_variance_.sum() if False else
      pca_std.explained_variance_[1:].sum())
A kódban a PCA automatikusan elvégzi a centrálást az
X-en, tehát kézzel nem kell az oszlopátlagot levonni. A
várható eredmény: a nyers skálán a basket_minor szórása
cent körüli, a distance_km szórása
km, a quantity_sum szórása
darab körüli, így a nyers első komponens terhelése gyakorlatilag a
basket_minor oszlopra koncentrálódik, és az első
varianciahányad
fölött van. Standardizálás után a korrelációs mátrix első két változója
közötti korreláció elméletileg
körüli, ezért az első PC terhelése a distance_km és a
basket_minor irányában egyaránt
körüli, az első varianciahányad
,
a második
,
a harmadik
.
Az utolsó ellenőrzés arra mutat rá, hogy a standardizált térbeli
rekonstrukciós hiba varianciája éppen a kihagyott komponensek
magyarázott varianciája:
változó esetén a teljes variancia
,
ebből
komponenssel
-et
tartjuk meg, így a hiba
.
A laborban ugyanez a gondolatmenet a tiszta orders.csv
három numerikus oszlopán futtatható: distance_km,
basket_minor, quantity_sum. A
segment, region és
acquisition_channel kategorikus oszlopok nem kerülnek
közvetlenül a PCA-ba; a priority_flag bináris, ezért csak
külön megfontolással szerepelhet. Ha az account_age_days
jellemzőt is be akarjuk vonni, azt előbb a customers.csv
signup_date oszlopából kell időhelyesen kiszámítani,
ahogyan azt a CTE, window és előzményből számolt
feature előzményaggregátumai mutatják. A laborfuttatás várt
tendenciája ugyanaz: a nyers PCA-t a kosárérték uralja, a standardizált
PCA a korrelációs szerkezetet emeli ki.
A PCA felügyelet nélküli, de a belőle épített transzformáció betanított paramétereket tartalmaz: az oszlopátlagokat, a szórásokat és a komponensirányokat. Ha ezeket a teljes adaton, a tesztet is beleértve tanuljuk meg, akkor a tesztből származó eloszlásinformáció szivárog a pipeline-ba. Ez ugyanaz a hibaosztály, amelyet a Predikciós szerződés és hibateszt predikciós szerződés és a Küszöb, kalibráció és ritka esemény foldon belüli resampling kizár. A train-only fit (csak tanítón illesztés) lépései a Northstar időbeli splitjénél a következők:
cutoff = pd.Timestamp("2025-05-01T00:00:00+00:00")
# Feltéve, hogy a s084 label-availability szűrés már megtörtént:
train_mask = (df["order_ts"] < cutoff) & (df["label_available_at"] < cutoff)
test_mask = df["order_ts"] >= cutoff
X_train = df.loc[train_mask, numeric_cols]
X_test = df.loc[test_mask, numeric_cols]

scaler = StandardScaler().fit(X_train)        # csak tanítón tanul
pca = PCA(n_components=2).fit(scaler.transform(X_train))

X_train_score = pca.transform(scaler.transform(X_train))
X_test_score = pca.transform(scaler.transform(X_test))   # tesztre csak transform
A fit hívás a tanító statisztikákat rögzíti; a tesztre
már csak a transform vonatkozik. Így a teszt score-jai is a
tanító átlagával és szórásával számítódnak, pontosan ahogyan a
betanított modell élesben is viselkedne. Ugyanezt a szerződést érdemes
egy Pipeline-ba zárni, hogy a keresztvalidáció foldjaiban
se férhessen a teszt a tanításhoz.
Értelmezés, kézi számítás. A szövegbeli hárompontos példán ellenőrizd, hogy a centrált mátrix oszlopainak empirikus varianciája és , a két főkomponens score-oszlopainak kovarianciája , és a score-ok varianciája rendre és . Számold ki kézzel a score-oszlopok értékeit a megadott és irányokkal.
Megvalósítás. Futtasd le a fenti minimális
példát. Ellenőrizd, hogy a nyers első komponensben a
basket_minor terhelés abszolút értéke legalább
,
a standardizált első komponensben pedig a distance_km és a
basket_minor terhelése egyaránt
és
közé esik. Ellenőrizd azt is, hogy az
explained_variance_ratio_.sum() értéke
legyen
tűréssel.
Hibadiagnózis. Egy kolléga az időbeli split
előtt a teljes orders.csv-re illeszti a
StandardScaler-t, mondván: „a PCA felügyelet nélküli, itt
nincs szivárgás.” Miért téves ez az érvelés akkor, ha a skálázott
jellemzőket később logisztikus regresszióba adjuk? Milyen irányba
torzíthat a jövőbeli eloszlásból származó átlag és szórás? Add meg a
javítást Pipeline-nal.
Megváltozott feltétel. Hagyd el a
basket_minor oszlopot a generált adatból, és illeszd újra a
PCA-t a maradék két oszlopra standardizálás után. Milyen komponensirányt
és varianciahányadot vársz? Röviden indokold. Mi változik, ha a
quantity_sum helyett a bináris priority_flag
oszlopot teszed be változatlan problémakezeléssel?
1. feladat megoldása. A centrált mátrix oszlopai és ; mindkettő átlaga , négyzetösszege , így a korrigált variancia . A score-ok:
, tehát az első komponensen a fent kiszámított , , ; a másodikon , , . Az első score-oszlop átlaga , varianciája ; a másodiké . A két oszlop kovarianciája . Az oszlopok tehát korrelálatlanok, a varianciák a sajátértékek.
2. feladat megoldása. A nyers PCA-nál a generálásból
cent²,
km²,
darab². A kovarianciamátrix diagonális dominanciája miatt az első
sajátvektor a basket_minor tengelyhez simul, így a terhelés
abszolút értéke
fölött várható. Standardizálás után a korreláció
;
a korrelációs mátrix első
-es
blokkjának domináns sajátvektora közel
,
ezért mindkét terhelés
–
közé esik. Az arányok összege a definícióból adódóan
;
numerikusan
tűrésen belül kell maradnia. A tényleges futtatás során a mintavételezés
miatt a terhelések
-ön
belüli eltérése elfogadható.
3. feladat megoldása. A standardizálás paramétereit a tanuló pipeline részének kell tekinteni, mert az átlag és a szórás a modell bemenetét alakítja. Ha a teszt jövőbeli eloszlásából is tanulunk, a teszt adatai már a tanulási folyamatban részt vesznek; ez ugyanaz a leakeage, mint a Predikciós szerződés és hibateszt alfejezetben tárgyalt szerződésszegés. A torzítás iránya jellemzően optimista kiértékelés: a modell olyan jövőbeli eloszlási információkhoz fér hozzá, amelyek éles használatkor nem állnának rendelkezésre. A javítás:
from sklearn.pipeline import Pipeline

pipeline = Pipeline([
    ("scaler", StandardScaler()),
    ("pca", PCA(n_components=2)),
])
pipeline.fit(X_train)          # mindkét lépés paramétere csak tanítón tanul
X_test_score = pipeline.transform(X_test)
4. feladat megoldása. A basket_minor
elhagyása után a standardizált térben a két megmaradt változó
korrelációja gyenge (a generálásban a quantity_sum
független a distance_km-től), ezért a korrelációs mátrix
körülbelül egységmátrix. A két sajátérték közel
és
,
a komponensirányok bizonytalanok, a varianciahányadok közel
–.
A PCA itt nem ad értelmes dimenziócsökkentést, mert nincs domináns
korrelációs tengely. A bináris priority_flag beillesztése
hasonló óvatosságot igényel: a z-score alapú PCA a
változót is standardizálja, de az eredményül kapott komponens nehezen
értelmezhető folytonos látens tengelyként, és a bináris változó
marginális varianciája a ritka eseményeknél torzíthatja a súlyozást.
Jobb ilyenkor előbb megfontolni, hogy a bináris változót külön kezeljük,
vagy kevert típusú reprezentációt válasszunk.
A leggyakoribb félreértés úgy szól: „a PCA kiválasztja a legfontosabb jellemzőket a predikcióhoz.” Ez téves. A PCA célváltozó nélkül, kizárólag a bemeneti variancia alapján rangsorol; egy alacsony varianciájú változó lehet determinisztikus, erős prediktor. Ellenpélda: legyen nagy szórású zaj, pedig olyan bináris jel, amely valószínűséggel , egyébként ; legyen a cél . A PCA első komponense -et tartja meg, pedig tökéletesen prediktálja -t. A variancia tehát nem helyettesíti a felügyelt feature-szelekciót. Hasonlóképpen a komponensek nem feltétlenül oksági tényezők: a standardizált első PC például a távolság és a kosárérték lineáris kombinációja, nem egy beavatkozható fizikai mennyiség. Az oksági értelmezéshez az Oksági cél és megfigyelési torzítás kísérleti kerete kell.
A PCA komponenseinek előjele tetszőleges, ezért futások között azonos főkomponens ellentétes előjellel is megjelenhet. A komponensek korrelálatlansága a tanítási adatokra és a szokásos centrált PCA-definícióra vonatkozik.
A PCA a centrált adatmátrix SVD-jéből nyeri a fő irányokat; a szinguláris értékekből számolt mennyiség az adott komponens megmagyarázott varianciája, hányada pedig a teljes szóródásból való részesedés. Különböző mértékegységű oszlopoknál a nyers PCA-t a legnagyobb varianciájú változó uralja, ezért standardizálni kell – de a skálázó és a PCA paramétereit kizárólag a tanítórészen szabad illeszteni. Az inverz transzformáció rekonstrukciós hibája a kihagyott komponensek varianciája. A PCA varianciaalapú, nem célfüggő feature-szelekció. Következő alkalmazás: a Klaszterezés és stabilitás klaszterezés, ahol ugyanezt a komponens-teret használjuk a távolságalapú stabilitás vizsgálatához.