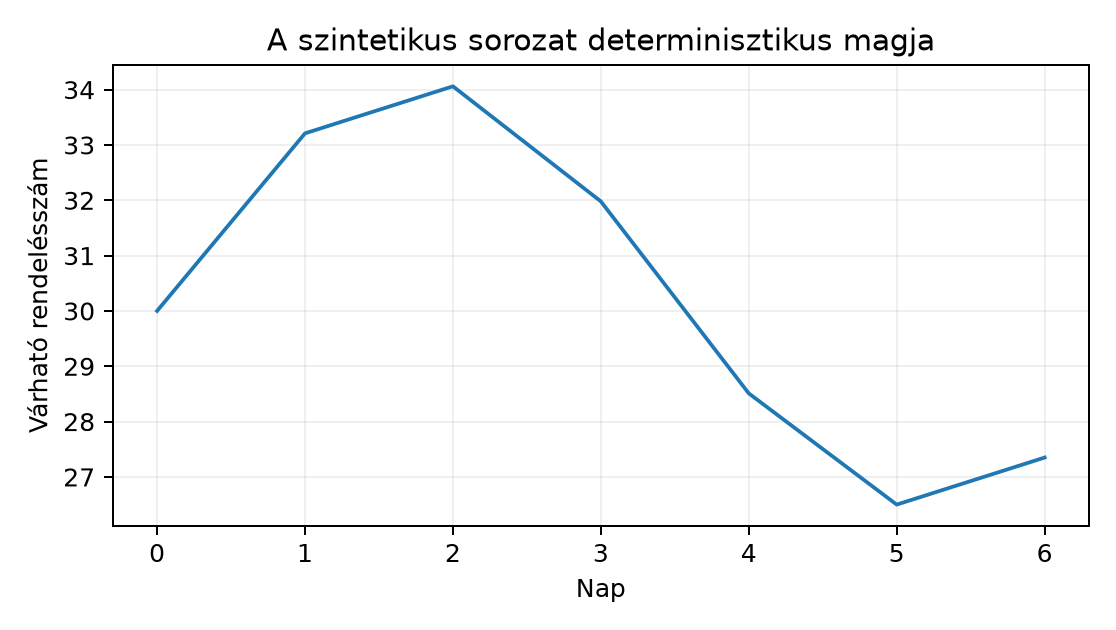
A Northstar-projekt orders.csv fájlját napi
rendelésszámmá aggregálva rövid távú napi előrejelzési feladatot kapunk.
Ebben az alfejezetben nem a 7 napot meghaladó kézbesítés bináris célját,
hanem egy idősoros döntési kérdést vizsgálunk: a következő 7 nap
mindegyikére hány rendelés várható, ha csak a mai napig ismert adatot
használhatjuk. A megfigyelési egység egy nap; a célváltozó az aznapi
rendelésszám, mértékegysége darab. Az időbélyeg UTC, a gyakoriság
nap. A predikció pillanata az utolsó teljesen megfigyelt nap végén, a
következő nap 00:00 UTC időpontja, a horizont pedig
nap.
A labor egy ismert szerkezetű, determinisztikus seedű szintetikus napi sort használ, hogy a várható hiba nagyságrendjét is ellenőrizhessük. A feladat: építsük meg a naiv (persistence) és szezonális naiv baseline-t, illesszünk egy kis exponenciális simítási modellt, majd több időablakon, mindig csak a múltból számolva hasonlítsuk össze őket korrekt hibamértékkel. Az ARIMA-modellt áttekintés szintjén ismerjük meg; a teljes azonosítás és elmélet nem előfeltétel.
Az idősoros modellek alapötlete, hogy a mai érték hasonlíthat a tegnapihoz. Az autokorreláció (autocorrelation) a sorozat önmagával vett, nappal eltolt lineáris kapcsolata. Az sorozat rendű autokorrelációja:
ahol a napi érték, a mintaátlag, a megfigyelések száma, a késleltetés (lag), napokban. A nevező a teljes varianciaarányos skálázás, a számláló pedig a nappal eltolt párok együttes ingadozása. Ha a szomszédos napok együtt mozognak, közel ; ha váltakoznak, közel .
Kézi kontroll a sorozaton: , az eltérések . A számláló , a nevező , így . A pozitív érték azt mutatja, hogy a monoton növekvő sorban a tegnapi érték információt hordoz a mairól; ez indokolja a naiv baseline-t.
Naiv modell (persistence). A legjobb tipp a holnapi értékre a mai érték. Ha a predikció origója , akkor minden horizontra:
Itt a -ig ismert adatokból készült lépéses előrejelzés; mértékegysége megegyezik -nal. A modellnek nincs illesztendő paramétere, ezért kiváló baseline.
Szezonális naiv. Heti ciklusnál nap; a holnapi értéket a múlt heti azonos napra adjuk. Általánosan, ha a periódus hossza napokban:
ahol felfelé kerekítés. Például , , esetén , esetén , esetén ismét . Gyakorlatban ez az utolsó megfigyelés ciklikus ismétlése.
Exponenciális simítás. Az egyszerű exponenciális simítás (simple exponential smoothing, SES) egy szintet tart karban:
A szint
mértékegysége megegyezik a célváltozóéval;
simítási paraméter, dimenziótlan,
.
Kis
simít, nagy
gyorsan követi a friss megfigyelést; az optimális
az illesztés során becsülhető. Szezonális adatra a Holt–Winters-változat
trendet és periódusonkénti szezonális tagokat is becsül; a statsmodels
ExponentialSmoothing osztálya ezt a
seasonal="add" és seasonal_periods=7
argumentumokkal adja.
ARIMA áttekintés. Az ARIMA család általános keret: autoregresszív tag a saját múltat használja, mozgóátlag tag a múltbeli hibákat, pedig az egyszerű differenciát a trend eltávolítására. AR(1):
MA(1):
ahol konstans, és becsült együtthatók, véletlen hibatag, naponként azonos szórású, nem autokorrelált. A teljes ARIMA-azonosítás meghaladja ezt az alfejezetet; a laborban az exponenciális simítás a választott kis statisztikai modell, az ARIMA pedig opcionális összehasonlítás.
Reziduális. Az illesztett modell in-sample hibája
vagyis a tényleges érték és az egylépéses modell-előrejelzés különbsége. Jó modellnél a reziduális közelítőleg fehér zaj: nulla körüli átlag, közel konstans szórás és nincs jelentős autokorreláció. Autokorrelált maradék arra utal, hogy a modell kihagyott struktúrát; ilyenkor trend- vagy AR/MA-taggal érdemes bővíteni.
A következő kód szintetikus napi sort készít, majd négy darab 7 napos tesztablakon, mindig csak az origó előtti adatra illesztve értékeli a naiv, a szezonális naiv és a Holt–Winters-modellt. A kimenet szemléltető; a tényleges futási számok a helyi környezettől és a seedtől függenek.
import numpy as np
import pandas as pd
from statsmodels.tsa.holtwinters import ExponentialSmoothing
from sklearn.metrics import mean_absolute_error

rng = np.random.default_rng(20261020)
n = 168
t = np.arange(n)
trend = 0.08 * t
season = 4.0 * np.sin(2 * np.pi * t / 7)
noise = rng.normal(0, 1.8, size=n)
y = 30.0 + trend + season + noise
series = pd.Series(
    y, index=pd.date_range("2025-01-01", periods=n, freq="D")
)

def evaluate_origin(series, origin, horizon=7):
    train = series.iloc[:origin]
    test = series.iloc[origin:origin + horizon]

    # Naiv baseline: az utolsó tanítóérték ismétlése
    naive_pred = np.full(horizon, train.iloc[-1])

    # Szezonális naiv: az utolsó 7 nap ciklikus ismétlése
    seasonal_pred = np.tile(train.iloc[-7:].to_numpy(), (horizon // 7) + 1)[:horizon]

    # Kis statisztikai modell: additív Holt-Winters
    hw_model = ExponentialSmoothing(train, seasonal="add", seasonal_periods=7)
    hw_fit = hw_model.fit(optimized=True)
    hw_pred = hw_fit.forecast(horizon).to_numpy()

    naive_scale = np.mean(np.abs(np.diff(train.to_numpy())))
    result = {
        "naive_mae": mean_absolute_error(test, naive_pred),
        "seasonal_naive_mae": mean_absolute_error(test, seasonal_pred),
        "hw_mae": mean_absolute_error(test, hw_pred),
        "naive_mase": mean_absolute_error(test, naive_pred) / naive_scale,
        "hw_mase": mean_absolute_error(test, hw_pred) / naive_scale,
        "resid": train.to_numpy() - hw_fit.fittedvalues.to_numpy(),
    }
    return result

train_size = 140
horizon = 7
windows = []
for origin in range(train_size, n, horizon):
    windows.append((origin, evaluate_origin(series, origin, horizon)))

rows = []
for origin, r in windows:
    rows.append({
        "window_origin": origin,
        "naive_mae": r["naive_mae"],
        "seasonal_naive_mae": r["seasonal_naive_mae"],
        "hw_mae": r["hw_mae"],
        "naive_mase": r["naive_mase"],
        "hw_mase": r["hw_mase"],
    })
results = pd.DataFrame(rows)
print(results.round(2))
A reziduális diagnosztikát az utolsó ablak tanítórészére így kérhetjük le:
from statsmodels.stats.diagnostic import acorr_ljungbox

ljung = acorr_ljungbox(windows[-1][1]["resid"], lags=[7], return_df=True)
print(ljung)
A szemléltető futtatásban a 7 napos periódus a determinisztikus magban látható; az adatgeneráló képlet , ahol napokban, az amplitúdó és a szint rendelésszámban értendő, pedig független normális zaj, szórása rendelés.
A MAE (mean absolute error) abszolút hibák átlaga a tesztablakban, rendelésszámban:
ahol a horizont hossza. A MASE (mean absolute scaled error) ezt a naiv baseline in-sample hibájához viszonyítja: a nevező a tanítóablak átlagos napi változása. A MASE dimenziótlan; -nél kisebb érték azt jelenti, hogy a modell jobb, mint a naiv, -nél nagyobb, hogy rosszabb. A MASE akkor használható érdemben, ha a nevező nem nulla; állandó sorozatnál nem értelmezhető.
Az elméletileg várt mintázat: a heti szezonalitás miatt a
seasonal_naive_mae és a hw_mae kisebb, mint a
naive_mae; a hw_mase tipikusan
alatt van, míg a naiv MASE
körül mozog, de a rövid tesztablakok miatt ablakonként ingadozik. A
Holt–Winters-modell becsült simítási paraméterei az adott ablakra
illeszkednek; a modell nem használhat jövőbeli tesztnapot. A
Ljung–Box-teszt
-értéke
felett azt jelzi, hogy a reziduális autokorrelációja nem szignifikáns;
ez a modell elfogadhatóságának egyik feltétele, nem önmagában bizonyíték
a jó előrejelzésre.
Horizont és kiértékelés: a hétlépéses előrejelzésnél külön kell nevezni a direkt és a rekurzív stratégiát, valamint horizontonként összehasonlítani a baseline modelleket. A h=1 mérőszáma önmagában nem igazolja a h=7 előrejelzés használhatóságát.
Értelmezés. Legyen , a tanítóablak utolsó két értéke , a tesztablak pedig . Számítsa ki kézzel a naiv és a szezonális naiv előrejelzést mind a 4 napra, majd adja meg a MAE értékét. Melyik baseline a jobb ebben a rövid ablakban?
Megvalósítás. Futtassa a fenti kódot, majd
módosítsa a Holt–Winters-modellt seasonal="mul" értékre.
Hasonlítsa össze a két változat ablakonkénti MAE-jét, és indokolja,
miért várható az additív változat előnye a használt generáló képlet
mellett. A döntéshez ne használja a tesztablakot modellválasztásra;
rögzítse előre a kritériumot.
Hibadiagnózis. Egy társ a naiv baseline-t így
számolja: pred = pd.Series(test).shift(1). Milyen hibát
követ el a fix originű, 7 napos előrejelzésnél? Adjon invariánst,
amellyel a helyes naiv előrejelzés ellenőrizhető.
Transzfer. Növelje a zaj szórását az adatgeneráló kódban -ról -ra, és futtassa újra a négy ablakot. Hogyan változnak a MAE és a MASE értékek? Miért változik kevésbé a MASE, mint a MAE?
A naiv előrejelzés mind a 4 napra . A szezonális naiv -vel az utolsó két értéket ismétli: . A naiv hibái: , MAE . A szezonális naiv hibái: , MAE . Ebben a rövid ablakban a naiv jobb; ez arra figyelmeztet, hogy a szezonális naiv nem automatikus nyertes.
A multiplikatív változat akkor indokolt, ha a szezonális amplitúdó a szinttel arányosan nő. A generáló képletben a szezonális tag additív konstans amplitúdójú, ezért az additív specifikáció közelebb van az igaz folyamathoz; a multiplikatív változat a kis szintingadozást is arányosítja, és rövid ablakon túlilleszthet. A helyes döntési eljárás előre rögzített, például az utolsó ablak kivételével az összes ablak átlagos MAE-je alapján választunk, a félretett ablak csak jelentésre szolgál.
A shift(1) minden tesztnapra az előző tényleges
tesztértéket adja, ami egy rögzített
origóból nem áll rendelkezésre; ez jövőinformáció, és optimista hibát
okozhat. A helyes naiv prediktor konstans:
np.full(horizon, train.iloc[-1]). Invariáns:
assert (pred == train.iloc[-1]).all() és
assert len(pred) == horizon.
Nagyobb zajnál a tényleges értékek ingadozása nő, ezért a MAE minden modellnél nő. A MASE nevezője, a training átlagos napi változása is nő, mert a zaj dominál; így a hányados kevésbé változik. A zaj elnyomja a heti struktúrát, ezért a Holt–Winters és a naiv közötti MASE-különbség csökkenhet; a modell előnye kevésbé lesz megbízható.
A leggyakoribb hiba, hogy a bonyolultabb modellt automatikusan
jobbnak tekintjük a naiv baseline-nál. Ellenpélda: ha a generáló
képletből elhagyjuk a szezonális tagot, tehát season = 0.0,
akkor a heti ciklus megszűnik, és a szezonális naiv az utolsó hét zajos
értékeit ismétli; a 7 napos teszt MAE-je várhatóan meghaladja a naiv
modellét, a Holt–Winters pedig a becsült szezonális tagokkal ugyancsak
túlilleszthet. Emlékeztető a korábbi fejezetekből: ahogyan Időhelyes feature és gördülő visszateszt
alfejezetben a jövőinformáció kizárása volt a feltétel, itt is minden
ablakban csak az origó előtti adat használható; a többszöri
modellválasztás pedig a Power, mintanagyság és
többszörös próbák alfejezetben tárgyalt peekinghez hasonló torzítást
vihet az értékelésbe, ha nincs előre rögzített döntési szabály.
Önellenőrzés: a naiv prediktor minden eleme egyenlő; a forecast hossza egyenlő a horizonttal; a MASE nevező pozitív; a modellillesztés soha nem kapja meg a tesztablakot.
A naiv modell a mai értéket ismétli, a szezonális naiv a múlt heti mintát, az exponenciális simítás pedig simított szintből és szezonális tagokból készít napos előrejelzést. A több tesztablakos értékelésben a MAE rendelésszámban méri az abszolút hibát, a MASE a naiv baseline-hoz viszonyít: alatt javulás, felett romlás. A reziduális autokorreláció diagnosztika; ha jelentős, a modell struktúrát hagyott ki. Az ARIMA keretrendszer AR, MA és differencia tagokkal általánosít, de a bonyolultabb modell nem garantál javulást. A következő alkalmazás az V. ellenőrző pont, ahol ezt a baseline- és hibakeretet teljes modellértékelési állításrendszerré kell összekötni.