A Northstar kísérleti folyamatában minden ügyfél egyszeri
randomizálási egység, a primer kimenet a bináris
conversion_7d. A korábbi Tesztválasztás
és hatásméret alfejezetben a kontrolkonverziót körülbelül 0,18-nak,
a kezelés hatását abszolút kockázatkülönbségként
értéknek tekintettük. Most azt a tervezési kérdést vizsgáljuk: ha egy új
kísérletet indítanánk
ügyfél/csoport mintanagysággal, kétoldali
szintű arányteszttel, mekkora eséllyel találnánk meg az előre rögzített
és
hatást? Tegyük fel, hogy a döntési szabály az, hogy
esetén elutasítjuk a nullát. Azt is mérni akarjuk, hogyan növeli a hamis
pozitív döntések arányát, ha ugyanazt a kísérletet többször, közbenső
mintaállapotokban is kiértékeljük.
Bemenet:
,
,
,
,
szimulációs ismétlés, seed 20261020.
Kimenet: elutasítások aránya = becsült power; a Monte
Carlo standard hibája.
Ellenőrzés:
mellett a becsült power
körül legyen, és a kézi normál közelítésből kapott érték a szimuláció
sugarú intervallumán belül legyen.
Előzetes becslés a képletek nélkül: power(δ=0.10)
körülbelül 0,5–0,6 lehet
csoportonként; power(δ=0.05) lényegesen kisebb, talán 0,2
alatt.
A másodfajú hiba angolul type II error: . Kiegészítője a power:
amely egy -beli valószínűség, nem a tényleges adatból számolt bizonyosság. A power az adatgyűjtés előtti tervezési mennyiség: attól függ, mekkora -t, -t, hatást és varianciát rögzítünk, és melyik tesztet használjuk.
Két arány összehasonlításakor a tesztstatisztika a közös nullabeli aránnyal:
Itt , csoportarányok, dimenzió nélküli kockázatkülönbség, a konverziók darabszáma. Ha a valódi hatás és , a power pozitív -ra jó közelítéssel
ahol a standard normál eloszlásfüggvény. Például , , esetén , a standard hiba , a nemcentralitási paraméter , így a power .
Minimum detectable effect (MDE) az a legkisebb valódi hatás, amelyet az adott elrendezés legalább cél-powerrel, tipikusan 80%-kal talál meg. Képlete általános normál becslőre
de két aránynál a is függ -tól a -n keresztül, ezért iterálni vagy szimulálni kell. A fenti példában az MDE körülbelül 0,14; ez nem azonos a 0,10-es célhatással.
Peeking (belepillantás): ha ugyanazt a kísérletet közbenső, kumulált mintaállapotoknál is kiértékeljük, és bármelyik pillantásnál esetén megállunk, a „legalább egyszer szignifikáns” döntés hibavalószínűsége nagyobb, mint . A korrelált közbenső tesztek miatt a névleges 0,05-os határok összességében fellazulnak; a helyes megoldás előre regisztrált interim-határ, például Bonferroni- vagy alfa-költő eljárás, nem utólagos „megállok, mert szép a p”.
Többszörös próbák (multiplicity): ha független nullhipotézist 0,05 szinten tesztelünk, akkor legalább egy hamis elutasítás valószínűsége ; például esetén ez 0,401. A family-wise error rate:
ahol a tévesen elutasított nullhipotézisek száma. A Bonferroni-korrekció minden egyes tesztet szinten végez; ebből a uniókorláttal adódik. A false discovery rate ezzel szemben a felfedezések közötti hamis arány várható értéke:
ahol
az összes elutasítás száma. A Benjamini–Hochberg (BH) eljárás a növekvő
p-értékekre az
küszöbsort alkalmazza: megkeressük a legnagyobb
indexet, amelyre
,
majd az első
hipotézist elutasítjuk. A küszöbök
esetén nagyobbak a Bonferroni-féle
küszöbnél. Független (illetve bizonyos pozitív függésű) tesztek mellett
a BH az FDR-t kontrollálja; tetszőleges függésre ez általánosan nem
garantált. Például tíz rendezett p-érték
0,001; 0,004; 0,009; 0,020; 0,041; ... mellett a küszöbök
0,005; 0,010; 0,015; 0,020; 0,025; ..., így az első négy
hipotézis elutasításra kerül, mert a negyedik még éppen
.
A FWER szigorúbb: minden hamis pozitív eseményét bünteti; az FDR a hamis pozitívak arányát kontrollálja, ami sok szűrőtesztnél gyakorlatiasabb.
A lenti kód csak a könyv alapcsomagjait használja; a projekt virtuális környezetéből futtatható. A seed rögzítése a pszeudorandom sorozatot reprodukálhatóvá teszi, de önmagában nem garantál bitazonos lebegőpontos eredményt minden platformon. A statisztikai reprodukálhatóságot a becsült power és a Monte Carlo intervallum együttes közlése adja.
import numpy as np
from scipy.stats import norm

def two_prop_z(x0, n0, x1, n1):
    p0 = x0 / n0
    p1 = x1 / n1
    p_pool = (x0 + x1) / (n0 + n1)
    se = np.sqrt(p_pool * (1.0 - p_pool) * (1.0/n0 + 1.0/n1))
    return (p1 - p0) / se

def simulate_power(p0, delta, n_per_group, B=4000, alpha=0.05, seed=20261020):
    rng = np.random.default_rng(seed)
    p1 = p0 + delta
    zcrit = norm.ppf(1.0 - alpha / 2.0)
    reject = np.empty(B, dtype=bool)
    for b in range(B):
        x0 = rng.binomial(n_per_group, p0)
        x1 = rng.binomial(n_per_group, p1)
        z = two_prop_z(x0, n_per_group, x1, n_per_group)
        reject[b] = np.abs(z) > zcrit
    power = reject.mean()
    se = np.sqrt(power * (1.0 - power) / B)
    return power, se

print("delta  power   95% MC CI")
for delta in [0.0, 0.03, 0.05, 0.08, 0.10, 0.12, 0.15]:
    est, se = simulate_power(0.18, delta, 150, B=4000, seed=20261020)
    print(f"{delta:.2f}  {est:.3f}  +/- {1.96*se:.3f}")
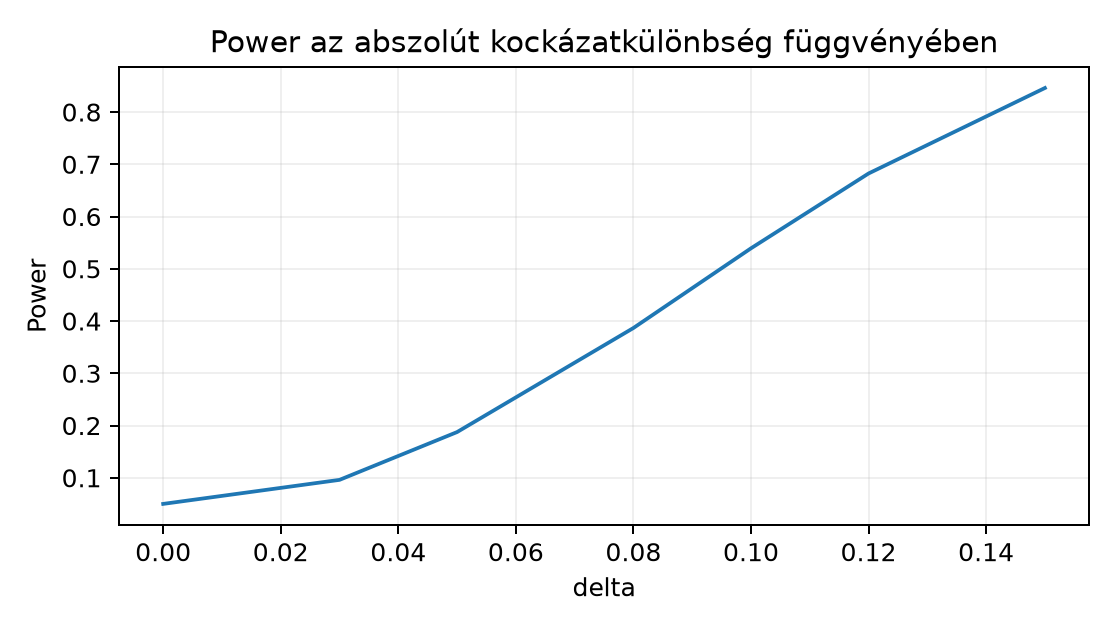
Lehetséges szemléltető kimenet — ez nem a könyvírás során futtatott mérés, hanem a képletekből és a szimuláció várható ingadozásából összeállított illusztráció:
delta  power   95% MC CI
0.00   0.051  +/- 0.007
0.03   0.099  +/- 0.009
0.05   0.186  +/- 0.012
0.08   0.391  +/- 0.015
0.10   0.541  +/- 0.015
0.12   0.678  +/- 0.015
0.15   0.843  +/- 0.011
Az elméleti power-görbe a megadott normál közelítésből:
A többszöri belepillantás modellje ugyanabból a kumulált véletlen mintából olvassa a közbenső állapotokat:
def simulate_peeking(p, n_per_group, look_sizes, B=4000, alpha=0.05, seed=20261020):
    rng = np.random.default_rng(seed)
    zcrit = norm.ppf(1.0 - alpha / 2.0)
    ever_reject = np.zeros(B, dtype=bool)
    for b in range(B):
        x0 = rng.binomial(1, p, size=n_per_group)
        x1 = rng.binomial(1, p, size=n_per_group)
        for k in look_sizes:
            z = two_prop_z(x0[:k].sum(), k, x1[:k].sum(), k)
            if np.abs(z) > zcrit:
                ever_reject[b] = True
                break
    fwer = ever_reject.mean()
    se = np.sqrt(fwer * (1.0 - fwer) / B)
    return fwer, se

est, se = simulate_peeking(0.18, 150, [50, 100, 150], B=4000, seed=20261020)
print(f"bármelyik pillantásnál szignifikáns: {est:.3f} +/- {1.96*se:.3f}")
A null-hatás mellett a három, egyenként 0,05-os határral végzett kumulált pillantás együttes hibája nagyobb, mint 0,05; a fenti konfigurációval a szemléltető becslés nagyságrendileg 0,10–0,12, azaz a hamis pozitív arány körülbelül a duplája a rögzített mintás teszttel várt 0,05-nak. A pontos érték seedfüggő, ezért a saját futtatáskor mindig a Monte Carlo hibahatárral együtt kell jelenteni.
A power-szimulációban a beállításnál mindkét kar azonos paraméterű, tehát a nullhipotézis igaz; a kétoldali teszt elméleti elutasítási aránya . A szimulált intervallum ezt lefedi, ami a helyes kritikus határ és a seed helyes használatának kézi ellenőrzése. A esetén a kézi normál közelítés -et ad; a Monte Carlo-sáv lefedi ezt az értéket. A power görbéje itt nem szimmetrikus, mert a binomiális variancia a sikeraránytól függ: nagyobb nullkockázat mellett ugyanaz az abszolút hatás kisebb standardizált eltérést jelent.
A peeking-eredmény értelmezése feltételes döntésként pontos: a nullmodell szerint generált adatokon a „bármelyik pillantásnál ” szabály hamis pozitív aránya nem , hanem annál nagyobb, mert a megállási szándék maga is a p-értékekből származik. A Tesztválasztás és hatásméret alfejezetben tárgyalt p-érték itt is a döntési folyamat része, nem a hipotézis igazságának valószínűsége. A Várható érték és Monte Carlo közelítés Monte Carlo-hibaképlete emlékeztet arra, hogy egyetlen seed eredménye csak egy realizáció; a fenti intervallumok ezt számszerűsítik.
Tervezési megkötés: a mintanagyság-becslés függ a kontrollaránytól, a célzott minimálisan fontos hatástól, a kétoldali/egyoldali teszttől és a tervezett elemzési egységtől. Többszöri közbenső ellenőrzés esetén az egyszeri 5%-os küszöb mechanikus alkalmazása nem tartja automatikusan az összesített téves riasztási valószínűséget 5%-on.
Értelmezés. Magyarázza el a Tesztválasztás és hatásméret arányteszt fogalmaival: miért várjuk, hogy a power-szimuláció esetén 0,05-öt adjon? Miért hibás az az állítás, hogy „a 0,54-es power azt jelenti, hogy a megfigyelt hatás 54% valószínűséggel legalább 0,10”?
Implementálás. A simulate_power
függvény felhasználásával, bináris kereséssel keresse meg az MDE-t
,
,
target power
,
,
seed 20261020 mellett. A keresési intervallum legyen
,
legfeljebb 12 iteráció. Ellenőrizze, hogy a talált
mellett a szimulált power 0,80-hoz közeli. Mekkora toleranciát indokol a
Monte Carlo standard hiba?
Hibadiagnózis. Egy elemző a peeking modellt úgy
írta meg, hogy minden pillantásnál új, független 50 elemű mintát
generál: x0_look = rng.binomial(50, 0.18), majd ebből
számol z-t. Azt állítja, hogy ez modellezi a háromszori belepillantást.
Mi a hiba? Milyen hamis pozitív arányt közelít ez a változat, és miért
tér el a kumulált adatokat használó eljárástól?
Megváltozott feltétel. Módosítsa a
peeking-szimulációt Bonferroni-interimhatárra: a három pillantás
mindegyike csak
szinten kétoldali tesztet használ, azaz a kritikus érték
norm.ppf(1 - alpha_look/2). Futtassa ugyanazzal a seeddel.
Körülbelül mekkora ever_reject értéket vár, és miért
elégíti ki ez a Bonferroni-korlátot? Adja meg az MC intervallumot
is.
1. A esetben a generáló paraméterek azonosak, tehát igaz, és a rögzített eljárás definíció szerint . Ez az elutasítás gyakorisága a hipotetikus ismételt mintavételezések során, nem egyetlen minta utáni igazságvalószínűség. A 0,54-es power hasonlóan feltételes gyakoriság: és igaz volta mellett az eljárás az esetek 54%-ában utasít el. A megfigyelt kísérlet befejezése után a hatás bizonytalanságát a konfidenciaintervallum mutatja; a power nem poszterior valószínűség, ahogyan ezt a Tesztválasztás és hatásméret intervallumértelmezése is elkülöníti.
2. Lehetséges megoldás:
def power_at(delta):
    return simulate_power(0.18, delta, 150, B=4000, seed=20261020)[0]

lo, hi = 0.05, 0.30
for _ in range(12):
    mid = 0.5 * (lo + hi)
    if power_at(mid) < 0.80:
        lo = mid
    else:
        hi = mid
mde = 0.5 * (lo + hi)
est, se = simulate_power(0.18, mde, 150, B=4000, seed=20261020)
print(f"MDE várhatóan ~ {mde:.3f}, power {est:.3f} +/- {1.96*se:.3f}")
A keresés körülbelül értéket ad, mert a 0,14-es hatásnál a normál közelítés powerje éppen 0,80. A MC standard hiba -nél körülbelül , így a eltérés még a szimulációs zajhatáron belül van, nem valódi MDE-hiba. Ha -nél szűkebb garantált tolerancia kell, növeljük -t, vagy használjunk determinisztikus normál közelítést.
3. A hiba az, hogy az új, független minta nem
ugyanazt a kísérletet figyeli; a valódi interim-elemzés a korábbi
adatokra épülő kumulált mintát használja. A független változat pontosan
a három, diszjunkt mintán végzett teszt unióját modellezi; nullhipotézis
alatt az elméleti hamis pozitív arány
,
ami nagyobb, mint a kumulált, korrelált tesztek jellemző 0,10 körüli
értéke. A kumulált z-statisztikák közötti korreláció csökkenti a
szabadságot, ezért a független minta-változat félrevezetően
konzervatívnak mutathatja a tényleges kumulált peekinget, vagy ellenkező
irányban torzíthat, ha az elemző rossz döntési időpontokat feltételez. A
helyes megoldás a feladatban szereplő x0[:k].sum() kumulált
összegzés.
4. A módosított kritikus érték:
alpha_family = 0.05
look_sizes = [50, 100, 150]
K = len(look_sizes)
alpha_look = alpha_family / K
zcrit = norm.ppf(1.0 - alpha_look / 2.0)
# a simulate_peeking belsejében |z| > zcrit
A Bonferroni-uniókorlát szerint a három pillantás bármelyikén
elkövetett hiba valószínűsége legfeljebb
.
A kumulált adatokon ez a korlát nem teljesen éles, ezért a szimulált
ever_reject várhatóan 0,04 körüli, 0,05 alatt; a 4000-es
replikációból számolt MC intervallum nagyjából
.
Ugyanazzal a seeddel a kimenet például
fwer = 0.043 +/- 0.006 lehet. Ez a kimenet csak a
szimulációs terv teljesítményét méri, és feltételezi, hogy a pillantások
időpontjai előre rögzítettek; utólag választott pillantásra a korlát nem
érvényes.
Egy kutató a kísérlet után több elemzést futtat: konverzió, bevétel, mobil alcsoport, hétvégi alcsoport stb. Az egyik p-érték 0,032 lesz. A jelentés ezt az egyetlen számot előre tervezett elsődleges tesztként mutatja be, és a kísérletet sikeresnek minősíti. Ha mind a tíz teszt nullhipotézise igaz, a legalább egy szignifikáns eredmény valószínűsége . A szép riport nem teszi az utólag választott hatást előre tervezetté; a szelekciót multiplicity-korrekcióval vagy a családi hibaráta előzetes definiálásával kell kezelni. Hasonlóan, ha a kutató közbenső pillantásnál megáll, mert a p-érték éppen 0,04 lett, a tényleges hamis pozitív ráta a peeking miatt nagyobb, mint a látszólagos 0,05. A helyes megoldás az elemzési terv előre rögzítése, a Bootstrap a megfelelő mintavételi egységgel mintavételi egység logikájának megőrzésével, valamint a Notebookból script és jelentés scriptbe kiemelhető, reprodukálható függvényhatárok használata.
A power egy előre rögzített eljárás feltételes elutasítási gyakorisága, nem utólagos bizonyosság: -nál , pozitív hatásnál a normál közelítésből becsülhető, a Northstar-szerű , elrendezésnél 0,10-es hatásra körülbelül 0,54. Az MDE az a legkisebb hatás, amelyet 80%-os cél-powerrel kimutatunk, itt nagyjából 0,14. A kumulált adatokba való többszöri belepillantás növeli a hamis pozitív arányt; Bonferroni-interimhatárral visszahozható a családi hibakorlát alá. Több tesztnél a FWER minden hamis pozitív eseményét, az FDR a hamis arányt korlátozza. A következő ellenőrző pont ezeket a döntési hibákat foglalja egységes statisztikai állításrendszerré.