A Predikciós, paraméter- és Monte Carlo
intervallum alfejezetben megismert intervallumok azt mutatták, hogy
egy becslés mekkora tartományban mozoghat. Most azt vizsgáljuk, hogy az
adatok mennyire egyeztethetők össze azzal a nullmodellel, hogy a
kezelésnek nincs hatása. A nullhipotézist a nem szignifikáns eredmény
alapján nem „fogadjuk el”. A Northstar kísérleti projektben a bemenet a
lab/assignments.csv és a lab/outcomes.csv. A
megfigyelési egység egy randomizált ügyfél; a primer célváltozó a
conversion_7d, értéke 0 vagy 1. A variant
oszlop control vagy treatment.
Az estimand a hétnapos konverziós arányok különbsége:
Ennek pontbecslése
ahol a treatment csoport konvertálóinak száma, a treatment csoport mérete; és ugyanez a kontrollra. A különbség mértékegysége aránypont, például azt jelenti, hogy a kezelt csoportban 10 százalékponttal nagyobb a becsült konverziós arány. A tanulókérdés: ez a különbség elég nagy-e ahhoz, hogy a „nincs hatás” modellt elvessük mellett? Az előzetes várakozás szerint a generáló hatás 0,10, de a p-értéket a tényleges minta és a permutációs nullmodell adja.
A nullhipotézis (null hypothesis, ) az a kimondottan egyszerű állapot, amelyből a meglepő adatot mérjük. Itt:
tehát a két csoport konverziós valószínűsége azonos. A kétoldali alternatíva (two-sided alternative) szerint
A tesztstatisztika (test statistic) a minta egy előre rögzített függvénye. A mi statisztikánk skalár, mértékegysége aránypont. A p-érték megbízhatósága megköveteli, hogy a statisztikát az adat megnézése előtt rögzítsük; ha utólag választunk statisztikát, a küszöb valódi hibavédelme elromlik.
A farok (tail) azt rögzíti, hogy mely irányban számít szélsőségesnek egy nullmodell alatti érték. Felső egyoldali tesztnél a nagy pozitív , alsó egyoldalinál a nagy negatív szélsőséges. Kétoldali tesztnél az abszolút értékben nagy eltérés szélsőséges.
A feladat megfigyelési egysége fontos: a permutációt ügyfélszinten
végezzük. A conversion_7d csak egy érték ügyfelenként; ha
rendelési tételeket kevernénk, az összefüggő megfigyeléseket kezelnénk
függetlenként, és a p-érték megtévesztően kicsi lehet.
Legyen egy tanító méretű, szintetikus kísérlet: a kontroll kimenetei , a treatment kimenetei . Ekkor , és a megfigyelt statisztika
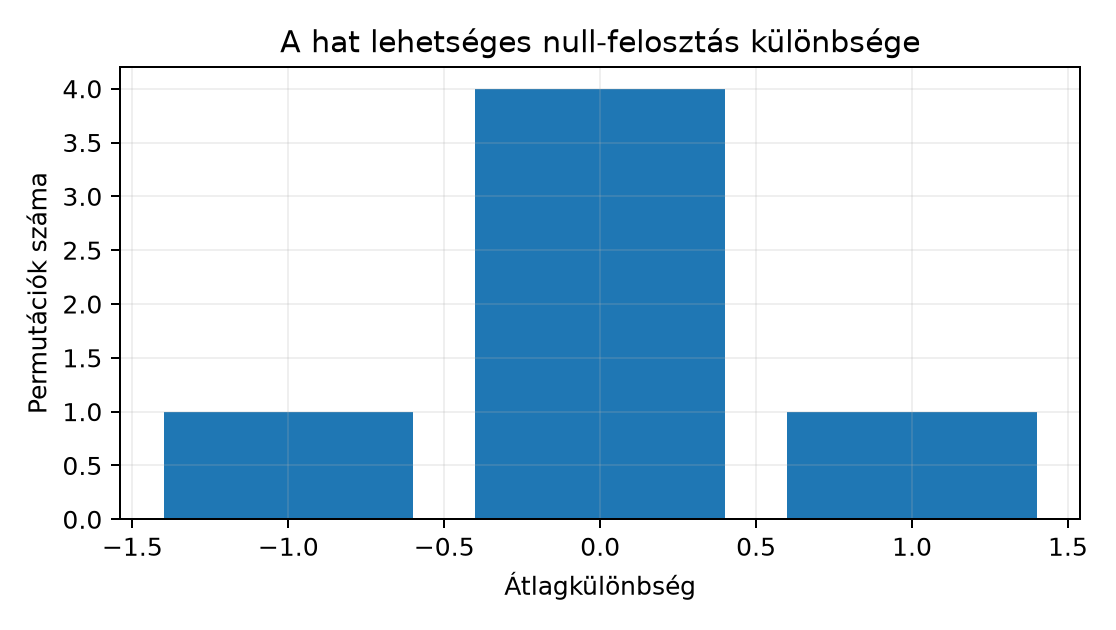
A nullmodell szerint a négy kimenet a hozzárendeléstől független, tehát az összes lehetséges „két elem a treatment csoportba, két elem a kontrollba” felosztás egyformán elképzelhető. A négy megfigyelt érték rögzített halmaza . A hat lehetőség:
| treatment értékei | |
|---|---|
| négy esetben | |
A nullmodell alatt a statisztika eloszlása:
Az egyoldali felső p-érték a megfigyelt -hez:
A kétoldali p-érték az abszolút értékben legalább ekkora eltérés valószínűsége:
Ez a kézi példa azért tanulságos, mert a megfigyelt hatás nagynak látszik, de a minta olyan kicsi, hogy a nullmodell szerint is könnyen létrejön.
A kis példa egzakt permutációs eloszlását a Python
itertools.combinations függvényével állítjuk elő. A kód a
projekt gyökeréből futtatható.
from itertools import combinations
import numpy as np

# Szintetikus tanulóadat: n_t = 2, n_c = 2.
y = np.array([0, 0, 1, 1])
n_t = 2

observed_diff = y[:n_t].mean() - y[n_t:].mean()

null_diffs = []
for idx in combinations(range(y.size), n_t):
    treatment = np.zeros(y.size, dtype=bool)
    treatment[list(idx)] = True
    control = ~treatment
    null_diffs.append(y[treatment].mean() - y[control].mean())

null_diffs = np.array(null_diffs)
p_one_sided = np.mean(null_diffs >= observed_diff)
p_two_sided = np.mean(np.abs(null_diffs) >= abs(observed_diff))

print(observed_diff, null_diffs, p_one_sided, p_two_sided)
A kód elméletileg várt kimenete a fenti kézi számításnak felel meg:
1.0 [-1. 0. 0. 0. 0. 1.] 0.16666666666666666 0.3333333333333333A laboradatra a permutációs tesztet Monte Carlo közelítéssel
futtatjuk. A kód a lab/assignments.csv és a
lab/outcomes.csv fájlokat olvassa, ügyfélszinten kapcsolja,
és 10 000 permutációt használ. A seed rögzíti a pszeudovéletlen
sorrendet.
import numpy as np
import pandas as pd

# Futtatás a projekt gyökeréből: python s061_permutation_test.py
assign = pd.read_csv("lab/assignments.csv")
outcomes = pd.read_csv("lab/outcomes.csv")

df = assign.merge(outcomes, on="customer_id", how="inner", validate="one_to_one")
y = df["conversion_7d"].to_numpy()
is_treatment = (df["variant"] == "treatment").to_numpy()

observed_diff = y[is_treatment].mean() - y[~is_treatment].mean()

rng = np.random.default_rng(20261020)
n_permutations = 10_000
extreme_count = 0

for _ in range(n_permutations):
    shuffled = rng.permutation(y)
    null_diff = shuffled[is_treatment].mean() - shuffled[~is_treatment].mean()
    if abs(null_diff) >= abs(observed_diff):
        extreme_count += 1

# +1 korrekció: a megfigyelt felosztást is a null-eloszlás mintájába számítjuk.
p_two_sided = (extreme_count + 1) / (n_permutations + 1)

print(observed_diff, p_two_sided)
A laborfájlokból kapott pontos szám automatikusan még nem ellenőrzött
kimenet, ezért csak a számítási utat ellenőriztük. A
validate="one_to_one" egyúttal adatminőségi kapu: ha egy
ügyfélhez több kimenet tartozna, a kapcsolás hibát adna, és a p-érték
helyett a séma-eltérést kellene először javítani.
A p-érték formális definíciója itt:
Szavakban: ha a nullhipotézis igaz, mekkora valószínűséggel kapnánk a megfigyelttel legalább egyezően szélsőséges statisztikát? A kis példában nem azt mondja, hogy a nullhipotézis igazságának valószínűsége , hanem azt, hogy a nullmodell alatt a lehetséges újrafelosztások harmada ilyen szélsőséges.
Az szignifikanciaszint (significance level) egy előre rögzített döntési küszöb. Ha , a nullhipotézist elutasítjuk; ha , nem utasítjuk el. Az tehát nem a p-értékből utólag képzett érték, hanem a hibavédelem specifikációja.
A kétféle döntési hiba:
| Döntés | igaz | igaz |
|---|---|---|
| Elutasít | I. típusú hiba, valószínűsége legfeljebb | helyes döntés |
| Nem utasít el | helyes döntés | II. típusú hiba, valószínűsége |
A Monte Carlo p-értéknek saját közelítési hibája van. Ha a p nagyságrendje , akkor a standard hiba közelítőleg , tehát a harmadik tizedesjegy már bizonytalan. A statisztikai bizonytalanság és a szimulációs bizonytalanság tehát külön jelentésre kerül, ahogyan Predikciós, paraméter- és Monte Carlo intervallum alfejezetben is szétválasztottuk. A jelen példa döntését a p-érték tartománya, nem a tizedesjegyek finomsága befolyásolja.
Feltétel: a csoportcímkék újrakeverése a randomizáció kiosztási mechanizmusát utánozza. A Fisher-féle egzakt randomizációs teszt szigorú, minden egyedre nulla kezelési hatást megfogalmazó sharp null mellett egzakt. Az átlagos hatás nulla önmagában nem ugyanaz a hipotézis; heterogén hatásoknál a naiv permutáció érvényessége külön indoklást igényel.
Értelmezés. Egy elemző ezt írja: „A p-érték 0,03, tehát 3% annak a valószínűsége, hogy a kezelésnek nincs hatása.” Melyik állítás igaz?
Megvalósítás. Írjon függvényt, amely a kis példa adatán a teljes permutációs eloszlásból felső egyoldali p-értéket ad, ha a megfigyelt treatment-kontroll különbség . Ellenőrizze az invariánsokat: , és a p-érték összege a felső farok valószínűségeivel konzisztens.
Hibadiagnózis. Az alábbi kód a laboros kétoldali tesztet próbálja megvalósítani. Mi a hiba, ha a megfigyelt különbség pozitív?
p_wrong = 1 - np.mean(null_diffs >= observed_diff)A null_diffs a permutációs statisztikák tömbje. Adjon
ellenpéldát a kis példa null_diffs = [-1, 0, 0, 0, 0, 1]
tömbjével és observed_diff = 1 értékkel, majd adja meg a
helyes egyoldali p-értéket.
Transzfer megváltozott feltételre. Tegyük fel, hogy a kis példa minden megfigyelését megduplázzuk: a kontroll kimenetei , a treatment kimenetei lesznek. A megfigyelt különbség továbbra is . Hány lehetséges felosztás van, és mennyi a kétoldali p-érték? Vesse össze az eredeti p-értékkel. Mit mutat ez a p-érték és a hatásméret viszonyáról?
Szimulációs ellenőrzés. Tiszta nullmodellben, és Bernoulli-kimenettel, szimuláljon 1000 kísérletet. Minden kísérletben számítsa ki a statisztikát, és döntsön egy szabályos kétoldali z-próbával mellett. Az I. típusú hibák aránya milyen érték körül várható? Adja meg a várható arány Monte Carlo standard hibáját is: .
A helyes válasz b. A p-érték feltételes valószínűség: feltétele a nullmodell, nem pedig a nullhipotézis igazságának valószínűségét méri. A p-érték nem hatásnagyság és nem is annak alsó korlátja.
Egy lehetséges függvény:
def exact_upper_p(y, n_t, observed_diff):
    from itertools import combinations
    import numpy as np
    null_diffs = []
    for idx in combinations(range(len(y)), n_t):
        mask = np.zeros(len(y), dtype=bool)
        mask[list(idx)] = True
        null_diffs.append(y[mask].mean() - y[~mask].mean())
    null_diffs = np.array(null_diffs)
    return np.mean(null_diffs >= observed_diff)

print(exact_upper_p(np.array([0, 0, 1, 1]), 2, 1.0))  # 0.166666...
Ellenőrzés: a p-érték nemnegatív és legfeljebb 1, mert gyakorisági arány. A felső farok a háromféle null-érték közül csak az -eket foglalja magába: .
A hiba az, hogy
1 - np.mean(null_diffs >= observed_diff) a
valószínűséget becsli, nem a felső farok valószínűségét. A kis példában
np.mean(null_diffs >= 1) = 1/6, ezért
p_wrong = 5/6 ≈ 0,8333, ami azt sugallná, hogy az extrém
megfigyelés a nullmodell alatt nagyon gyakori; valójában a helyes felső
p
.
A kód a farok komplementerét számolja.
A nyolc megfigyelt érték közül a treatment csoport négy elemet kap; ez felosztás. A treatment csoport maximális átlaga akkor jön létre, ha mind a négy 1-es a treatmentbe kerül; ez egyetlen felosztás. A minimális átlag ugyanilyen, amikor minden 1-es a kontrollba kerül. A megfigyelt abszolút eltérés , ezért a kétoldali p-érték
Az eredeti p volt. A hatásméret ugyanaz, a p mégis jelentősen csökkent, mert a nagyobb minta ugyanakkora eltérést már kevésbé tart valószínűnek a nullmodell alatt. A p-érték tehát a minta nagyságát és a hatást együtt tükrözi, nem önmagában a hatás nagyságát.
Az 1000 szimulációból mellett körülbelül 50 elutasítás várható; a tapasztalt arány szórása közelítőleg , ezért egy 0,04 és 0,06 közötti arány még konzisztens a névleges 0,05 szinttel. Előre rögzített magvet használva a tapasztalt arány ismételhető. Ellenőrző invariáns, hogy a z-statisztika a nullmodell alatt közelítőleg standard normális, ahol a közös becsült aránnyal. A becsült I. típusú arány például 0,052, 0,048 vagy 0,055 közeli érték lehet; a pontos érték a szimulátor megvalósításától függ.
A leggyakoribb tévedés: a p-érték nem a nullhipotézis igazságának valószínűsége. A gyakorisági keretben a nullhipotézis nem kap valószínűséget; a p-érték feltétele az, hogy a nullmodell igaz. Ha , nem mondható, hogy „4% eséllyel nincs hatás”. Helyesen: a nullmodell és az alkalmazott mintavételi/hozzárendelési eljárás feltételezése mellett a megfigyelttel legalább ennyire szélsőséges tesztstatisztika valószínűsége 4%.
Ehhez kapcsolódik a második csapda: a nem szignifikáns eredmény nem automatikus egyenértékűség. A kis példában nagy hatásnak látszik, mégis , mert a minta kicsi. A „nem találtunk különbséget” állítás itt téves lenne; csak annyi igaz, hogy ez a minta nem adott elég erős bizonyítékot a nullmodell ellen. A hatásméretet és a bizonytalanságot a p-érték mellett mindig jelenteni kell.
Visszautalás Paraméter, becslő és likelihood alfejezetre: a likelihood a paraméter függvényében nézte az adatot; itt ezzel szemben egy rögzített nullparaméter alatt nézzük a statisztika feltételes eloszlását. Mindkettő feltételes gondolkodás, csak az irány más. Visszautalás Predikciós, paraméter- és Monte Carlo intervallum alfejezetre: a Monte Carlo p-érték kvantilis-bizonytalansága külön becslési bizonytalanság, nem szabad a nullhipotézis bizonytalanságaként kezelni.
Önellenőrző kérdések:
Ha mindhárom kérdésre a feltételes valószínűség nyelvén tud válaszolni, akkor a nullmodell és a p-érték viszonya stabil. A következő alfejezet a tesztválasztást és a hatásméretet kapcsolja a p-értékhez, hogy a döntés ne csak szignifikanciáról, hanem gyakorlati jelentőségről is szóljon.
A nullhipotézis a vizsgált állítás; lehet egyszerű vagy összetett, és a randomizációs teszt külön feltételeket igényel. a tesztstatisztika a minta előre definiált függvénye. A p-érték annak feltételes valószínűsége, hogy a nullmodell alatt legalább ilyen szélsőséges statisztikát kapunk. Az küszöb előre rögzíti a maximális I. típusú hibát, míg a II. típusú hiba az erővel függ össze. A p-érték nem a nullhipotézis igazságának valószínűsége, a nem szignifikáns eredmény pedig nem egyenértékűség. A permutációs teszt a randomizált hozzárendelést használja nullmodellként, ügyfélszintű újracímkézéssel. A laboron ez a primer konverziós különbség kétoldali p-értékét adja, amelyet hatásmérettel és a Monte Carlo hiba nagyságrendjével együtt kell jelenteni.