A Northstar orders.csv minden sora egy rendelés, de
ugyanahhoz a customer_id-hoz több sor is tartozhat. Ha egy
elemzésben a 2400 rendeléssort úgy kezeljük, mintha 2400 független
ügyfélmegfigyelés lenne, alábecsülhetjük a becsléseink bizonytalanságát.
Ebben az alfejezetben két dolgot választunk szét: mit jelent két
számszerű változó kovarianciája és
korrelációja, és mit jelent az, hogy a sorok nem
függetlenek, mert ismételt mérések vannak ugyanazon az ügyfélen.
Bemenetnek tekintjük a rendelésenkénti quantity_sum és
egy másik numerikus jellemző, például basket_minor
vektorát. Megfigyelési egység a sor: egy rendelés. A következtetés
szempontjából viszont a független mintavételi egység
gyakran az ügyfél, nem a rendelési sor. Előzetes becslés: a
rendelésszintű korreláció lehet részben ügyfélen belüli hasonlóságból
származó, ezért a korreláció értékét is feltételesen kell értelmeznünk.
A cél az, hogy egy későbbi bootstraphez vagy teszthez helyesen jelöljük
meg, mit szabad újramintavételezni.
Legyen és két azonos hosszúságú megfigyelésvektor, mindkettő alakja . Jelölje és a két átlagot. A kovariancia (covariance) a centrált vektorok skalárszorzatának átskálázott alakja:
ahol
az átlaggal centrált vektor,
hasonlóan. A mértékegység az
és
mértékegységének szorzata: például darab
EUR-cent. A pandas Series.cov alapértelmezése
osztóval számol, a NumPy np.cov alapértelmezése
osztóval; mindig ellenőrizni kell a ddof paramétert, mert a
két érték nem ugyanaz.
A skalárszorzatos alak mutatja, miért beszélünk lineáris együttmozgásról: ha az és centrált vektorok „ugyanabba az irányba mutatnak”, a kovariancia pozitív nagy; ha merőlegesek, nulla. Ez a legkisebb négyzetek fejezetéből ismert merőlegességfogalom közvetlen felhasználása.
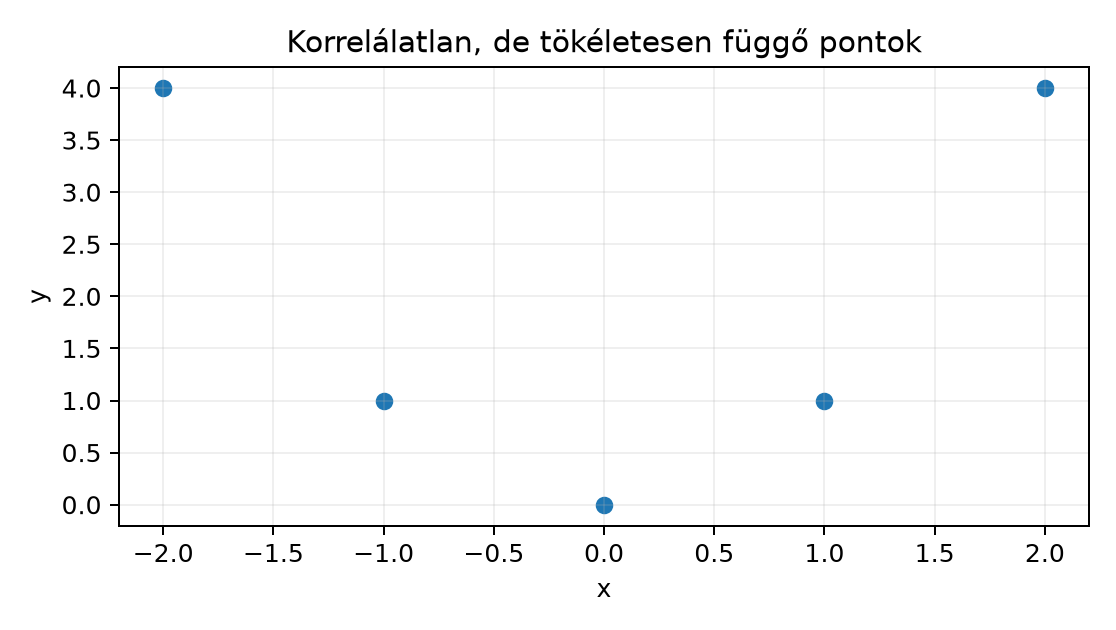
Kis kézi kontroll: ha és a három lehetséges érték, akkor és . A centrált szorzatok:
Tehát a kovariancia nulla, pedig teljesen determinisztikusan függ -től.
A kovariancia skálafüggő, ezért önmagában nem alkalmas kapcsolatok összehasonlítására. A Pearson-féle korreláció (correlation) a centrált vektorok koszinusz hasonlósága:
hasonlóan -nal. A mértékegység dimenziómentes, mert a számláló és a nevező azonos mértékegységű. A Cauchy–Schwarz-egyenlőtlenség miatt . A tökéletes pozitív lineáris kapcsolatot, a tökéletes negatív lineáris kapcsolatot jelent, a pedig azt, hogy a legjobb lineáris irányú együttmozgás sincs jelen.
Két véletlen változó független (independent), ha az egyik értékének ismerete nem ad információt a másik eloszlásáról. Diszkrét esetben és közelítő értelemben: tetszőleges és értéktartományra
A függetlenségből következik , ezért és . A megfordítás nem igaz: az , példa korrelálatlan, de függő. Más szóval a korrelálatlanság csak a lineáris kapcsolat hiányát jelenti, nem a kapcsolat hiányát.
A gyakorlatban ezért egy kis
mellé nem írhatjuk azt, hogy „a változók függetlenek”. A kódban a
scipy.stats.pearsonr által adott p-érték is csak a lineáris
korreláció nullmodelljére vonatkozik, nem az általános
függetlenségre.
A kapcsolat mindig egy adott csoportra vagy feltételre vonatkozik. Két változó lehet korrelálatlan a teljes táblán, de régióra bontva erősen korrelált, és fordítva: lehet régiókon belül korrelálatlan, de a teljes táblán erős korrelációt mutat, ha a régió mindkét változó átlagát eltolja. Ez utóbbi a Simpson-jelenség közeli rokona.
Példaként tételezzük fel, hogy az A régióban
és
egymástól független standard normális, a B régióban szintén
függetlenek, de mindkettő átlaga
-zel
nagyobb. A teljes táblán a régiók közötti átlagkülönbség erős pozitív
kovarianciát hoz létre, miközben régióra bontva a korreláció nulla körül
marad. Ezt feltételes függés (conditional dependence)
akkor mondjuk, ha a csoportváltozó rögzítése után is megmarad a
kapcsolat; a fenti példában éppen a feltételes függetlenség és a
marginális függés esete áll fenn.
Ha ugyanazt az ügyfelet többször mérjük, a hozzá tartozó sorok egy csoportot (group/cluster) alkotnak. A csoporton belüli sorok nem cserélhetők fel más ügyfelek soraival, mert egy közös, ügyfélszintű hatást hordozhatnak. Egyszerű modellben:
ahol az -edik ügyfél közös hatása, a rendelés szintű zaj. Az azonos ügyfélhez tartozó két sor kovarianciája , ha a zajok függetlenek. Az intra-class correlation (ICC) ezt a hasonlóságot méri:
ahol az ügyfélszintű variancia, a rendelésszintű zaj varianciája, mindkettő mértékegységben. Ha , a csoportok nem adnak redundáns információt; ha , az ismételt sorok fele-fele arányban tudhatók be közös ügyfélhatásnak és egyedi zajnak.
A független mintavételi egység ezért ilyenkor a
customer_id, nem az order-sor. Ha minden sort függetlennek
tekintünk, az effektív mintanagyságot felülbecsüljük, és a standard
hibát alulbecsüljük. Egyenlő csoportméret esetén a tervezési
effektus:
ahol az ügyfelenkénti rendelések száma, pedig az intra-class correlation. Ha például és , akkor , vagyis a független soros standard hibát -mal kell megszorozni ahhoz, hogy a csoportszerkezetet figyelembe vegyük.
Az alábbi kód a NumPy Generator segítségével állítja elő
a két tanulságos adatsort. A kimenet szemléltető jellegű: a szövegben
levezetett várható értékek a megadott generáló modellből következnek, a
tényleges futás seedtől függően kissé eltérhet.
import numpy as np
import pandas as pd
from scipy.stats import pearsonr

rng = np.random.default_rng(20261020)

# 1) Korrelálatlan, de függő pár: y determinisztikus függvénye x-nek
n = 20000
x = rng.normal(size=n)      # alak: (n,)
y = x**2 - 1
r_nonlinear, _ = pearsonr(x, y)

# Pontos kis kézi kontroll, ahol a kovariancia elméletileg nulla
x_small = np.array([-1.0, 0.0, 1.0])
y_small = x_small**2        # [1, 0, 1]
cov_pop = np.mean((x_small - x_small.mean()) * (y_small - y_small.mean()))

# 2) Ügyfélenként ismételt rendelések szimulációja
n_customers = 100
orders_per = 5
z = rng.normal(0, 1, size=n_customers)              # ügyfeleffektus, (100,)
eps = rng.normal(0, 1, size=(n_customers, orders_per))
y_group = z[:, None] + eps                          # broadcasting: (100,1)+(100,5)
df = pd.DataFrame({
    "customer_id": np.repeat(np.arange(n_customers), orders_per),
    "y": y_group.ravel()
})

# Naiv soronkénti standard error és ügyfélszintű standard error
naive_se = df["y"].std(ddof=1) / np.sqrt(len(df))
customer_means = df.groupby("customer_id")["y"].mean()
cluster_se = customer_means.std(ddof=1) / np.sqrt(n_customers)

# A resampling egység: customer_id, nem a rendeléssor
groups = [g["y"].to_numpy() for _, g in df.groupby("customer_id", sort=True)]
n_groups = len(groups)

def cluster_bootstrap_mean(n_boot=1000, seed=42):
    rng_boot = np.random.default_rng(seed)
    estimates = np.empty(n_boot)
    for b in range(n_boot):
        chosen = rng_boot.integers(0, n_groups, size=n_groups)
        sample = np.concatenate([groups[i] for i in chosen])
        estimates[b] = sample.mean()
    return estimates

boot = cluster_bootstrap_mean()
boot_cluster_se = boot.std(ddof=1)

print("r(x, x**2-1):", r_nonlinear)
print("pontos kis kovariancia:", cov_pop)
print("naive SE:", naive_se)
print("ügyfélszintű SE:", cluster_se)
print("ügyfélszintű bootstrap SE:", boot_cluster_se)Az első részben az várhatóan nulla közelében van, mert a standard normális eloszlás harmadik momentuma , és a centrált szorzat átlaga éppen ezt becsli. A pontfelhő eközben tökéletes parabolát rajzol ki, tehát a kapcsolat determinisztikus. A korreláció csak a lineáris kapcsolat hiányát mutatja, a függetlenség hiányát nem.
A második részben a generáló paraméterek , , ezért . A naiv standard error várhatóan
míg az ügyfélenkénti átlagok standard hibája
A két érték hányadosa
.
Az ügyfélszintű bootstrap ugyanezt a csoportszerkezetet veszi
figyelembe, ezért annak standard hibája is a nagyobb érték körül
ingadozik. Ha valaki a rendeléssorokat tekintené mintavételi egységnek,
a naive_se a helyes ügyfélszintű bizonytalanság mintegy
-szerese
lenne.
A korrelálatlanság nem általában jelent függetlenséget. Az intraklaszter-korrelációra írt tervezési hatás az egyforma klaszterméretet és az egyszerű cserélhető korrelációs modellt feltételezi.
A orders.csv 2400 rendeléssort és 300 egyedi ügyfelet
tartalmaz. Magyarázd el, miért nem érvényes az az állítás, hogy „2400
független megfigyelésünk van”, ha egy ügyfél több rendelést is leadott.
Mi a resampling egység, és miért?
Számítsd ki kézzel a minta kovarianciáját osztóval és a Pearson-korrelációt az alábbi párokra:
Ellenőrizd NumPy-val is (np.cov ddof=1
választással és np.corrcoef). Mit mond az eredmény a
függetlenségről?
Egy elemző a fenti df adaton a y oszlop
átlagának standard hibáját az alábbi módon becsli:
rng_boot = np.random.default_rng(42)
row_boot = rng_boot.choice(df["y"].to_numpy(), size=(1000, len(df)), replace=True)
se_wrong = row_boot.mean(axis=1).std(ddof=1)
Az eredmény körülbelül 0.063, míg az ügyfélenkénti
bootstrap körülbelül 0.110. Melyik becslés hitelesebb ebben
a szimulációban, és milyen feltevést sért a soronkénti bootstrap?
Fogalmazd meg a javítást a mintavételi egység szintjén.
Generálj adatot az alábbi módon:
rng = np.random.default_rng(8)
n = 500
x = np.concatenate([rng.normal(0, 1, n), rng.normal(10, 1, n)])
y = np.concatenate([rng.normal(0, 1, n), rng.normal(10, 1, n)])
region = np.array(["A"] * n + ["B"] * n)
Számítsd ki a teljes Pearson-korrelációt, valamint külön az
A és B régióra. Miért tér el a teljes
korreláció a régiókon belülitől? Nevezd meg, milyen kapcsolat van a
csoportosító változó és a két elemzett változó között.
Az orders.csv sorai rendelések, de ugyanazon ügyfélhez
tartozó rendelések nem függetlenek: közös ügyféléletciklus, szokás vagy
viselkedés hat rájuk. A 2400 sor legfeljebb 300, de a csoporton belüli
korreláció miatt jellemzően ennél is kevesebb független információs
egységet jelent. A resampling egység a customer_id: ha új
mintát húzunk, az egész ügyfelet húzzuk a hozzá tartozó összes
rendeléssel együtt.
, ; a centrált vektor , . A szorzatösszeg:
Ezért
és
.
Ugyanakkor
determinisztikus, tehát a két változó erősen függő lehet, csak nem
lineárisan. A NumPy np.cov(x,y,ddof=1)[0,1] és
np.corrcoef(x,y)[0,1] ugyanezt adja nullának; tolerancia
itt csak numerikus kerekítés, a közelítő érték 1e-16
nagyságrendben nulla.
A soronkénti bootstrap azt feltételezi, hogy az 500 rendeléssor
egymástól függetlenül cserélhető. Valójában egy ügyfélen belül a sorok
közös
hatást hordoznak, ezért a soronkénti újrahúzás mesterségesen sok
független egységet imitál, és alábecsüli az átlag bizonytalanságát. A
helyes eljárás az ügyfélazonosítók újrahúzása, és a kiválasztott
ügyfelek összes sorának beemelése, ahogy a
cluster_bootstrap_mean teszi. Az ügyfélenkénti eljárás
0.110 körüli standard hibája figyelembe veszi a
csoporthatást.
A teljes adaton a korreláció elméletileg
körüli lesz, mert a régiók közötti
egységnyi átlageltolódás mindkét változót egyszerre növeli. A régiókon
belül
és
független generálású, ezért a két régióra számított korrelációk 0
körüli, seedtől függően véletlenszerűen ingadozó értékek. A
region csoportosító változó mindkét változó közös oka:
régióra bontva eltűnik a kapcsolat, a teljes táblán viszont megjelenik.
Ez feltételes függetlenség, nem okozati kapcsolat.
Sok rendelés egy ügyféltől nem ugyanannyi független ügyfélmegfigyelés. Tegyük fel, hogy három ügyfelünk van, és az egyik, mondjuk egy nagykereskedő, 200 szinte azonos rendelést adott le, míg a másik kettő 5-5 rendelést. A táblán 210 sor lenne, de az ügyfélszintű bizonyíték továbbra is 3 egység. Ha valaki a 210 sorra számol standard hibát, az ügyfél szintű bizonytalanságot drámaian alábecsülheti, noha a sorok redundáns ismétlések.
Hasonlóan, ha egy régió mind a kosárértéket, mind a szállítási
távolságot eltolja, a teljes táblán látszó korreláció nem jelenti azt,
hogy az egyik rendelési jellemző közvetlenül növeli a másikat. Ellenőrző
kérdések: használtam-e ddof-ban következetes osztót?
Régióra vagy ügyfélre bontva is hasonló a kapcsolat? A mintavételi
egység a sor vagy a csoport? Ha a rétegzett és a teljes korreláció
eltér, nem szabad a teljes értéket automatikusan általános érvényű
állításként közölni.
A kovariancia a centrált vektorok skalárszorzatának átskálázott
alakja, a korreláció pedig a koszinusz hasonlóság, ezért csak lineáris
kapcsolatot mér. A függetlenségből következik a korrelálatlanság, de a
korrelálatlanságból nem következik a függetlenség; az
és
pár erre a legvilágosabb ellenpélda. Ismételt méréseknél a sorok nem
függetlenek, mert az ügyfél közös hatást visz be. A helyes mintavételi
egység ilyenkor a customer_id, nem az order-sor; az ICC és
a tervezési effektus mutatja, hányszorosára nőhet a standard hiba. A
következő bootstrap alfejezetben ugyanezt a
csoportszerkezetet kell majd tiszteletben tartani.