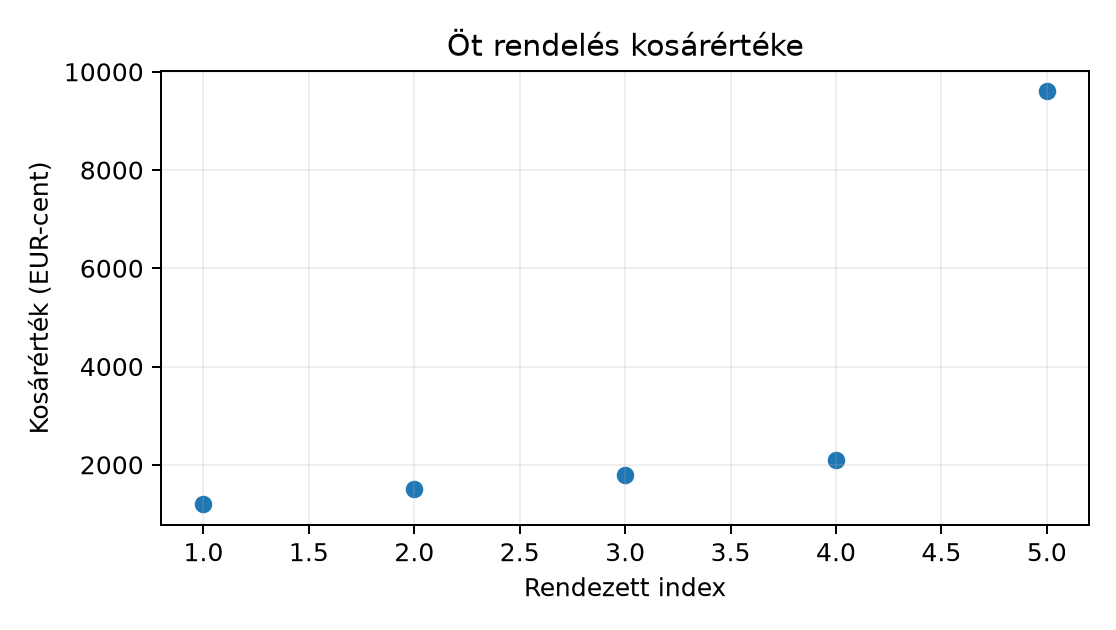
A Northstar orders tábla minden sora egy leadott
rendelés, a megfigyelési egység tehát a rendelés. Az
üzleti kérdés így szól: mekkora egy tipikus kosár értéke, és mennyire
szóródnak a kosarak? Ehhez a rendeléskor ismert
basket_minor mezőt használjuk, amely egész szám,
mértékegysége EUR-cent. Pénzösszegnél mindig a minor
unitban számolunk, és csak a megjelenítéskor váltunk euróra; így nem
kerül be felesleges lebegőpontos kerekítési hiba.
Az összegzés előtt becslést végzünk: a kereskedelmi kosarakra jellemző, hogy sok a kisebb rendelés, és kevés a nagy értékű. Ezért jobbra ferde eloszlásra számítunk, ahol az átlag nagyobb lehet a mediánnál, mert a nagy értékek húzzák. Az alfejezet végére azt is meg tudjuk mondani, hogy egy kiugró kosár mennyire változtatja meg a következtetést, és mikor érdemes robusztus mutatót választani.
Induló feladat a fogalmak ismerete nélkül: öt rendelés kosárértéke centben
Számold ki papíron az átlagot és a mediánt, és fogalmazd meg, melyik jellemzi jobban a „tipikus” rendelést, ha a 9600-as érték egy ritka nagy kosár.
A számtani átlag (mean) az értékek egyenlő súlyozású összege osztva az elemszámmal:
ahol az -edik rendelés kosárértéke centben, pedig a rendelések száma. A mértékegység ugyanaz, mint a bemeneté, tehát itt cent. Az átlag fontos tulajdonsága, hogy a teljes összeggel konzisztens: az öt rendelés összértéke pontosan . A hátránya is ebből fakad: minden értékre érzékeny, egyetlen nagy kosár is eltolja.
A medián (median) a nagyság szerint rendezett minta középső értéke. Jelölje a rendezett mintát . Ha páratlan, a medián a középső elem, ; ha páros, a két középső átlaga. Az ötelemű példában a rendezett minta , tehát a medián cent, azaz 18,00 EUR. A medián a szélső érték konkrét nagyságára érzéketlen: ha 9600 helyett 96 000 szerepelne, a medián akkor is 1800 maradna, az átlag viszont 20 340-re ugrana.
A döntés tehát nem az, hogy az átlag vagy a medián „pontosabb”, hanem az, hogy mire válaszolunk. A medián a tipikus egyedi rendelést, az átlag a darabszámmal szorozva a teljes bevételt írja le. A ferde kosáreloszlásnál mindkettőt jelentjük, és kimondjuk az eltérés okát.
A kvantilis (quantile) azt az értéket keresi, amely alá a rendezett minta meghatározott hányada esik. A kvantilist -val jelöljük, ahol . Ez a Sűrűség és eloszlásfüggvény eloszlásfüggvény-fogalom mintabeli inverze: ott a CDF megadta, hogy egy érték alá mekkora valószínűség esik, itt a mintából becsüljük azt az értéket, amely alá a minta hányada esik. A medián tehát a kvantilis.
Kis mintán az érték attól is függ, hogyan interpolálunk. A pandas
Series.quantile(q) alapértelmezése
interpolation="linear"; ennek képlete az
elemű rendezett mintára a
pozíciót használja, majd a szomszédos elemek között lineárisan
interpolál. Az ötelemű példában
pozíciója
,
tehát
cent;
pozíciója
,
tehát
cent. Az R alapértelmezett type=7 kvantilise ugyanezt a
lineáris szabályt adja, de más szoftver ettől kissé eltérhet; ezért a
reprodukálható jelentésben a interpolation paramétert is
rögzíteni kell.
Az interkvartilis terjedelem (interquartile range, IQR) a középső 50% terjedelme:
A példában cent. Az IQR robusztus szóródási mutató: a mediánhoz hasonlóan nem változik, ha a legnagyobb értéket a helyéről messzire toljuk, amíg a sorrendi pozíciók változatlanok maradnak. Az IQR-ből szokás az egyezményes kiugrószabályt képezni: az sávon kívüli pontokat kiugrónak nevezik. Ez detektálási heurisztika, nem bizonyíték arra, hogy a pont hibás; a kizárás vagy kezelés mindig modellezési döntés marad.
A variancia (variance) az átlagtól vett eltérések négyzetének átlaga. Itt két képletet kell elkülöníteni. Ha a rendelkezésre álló értékek maguk a teljes sokaság, a sokasági variancia
ahol a sokasági átlag, a nevező . Ha azonban az értékek egy nagyobb sokaságból vett mintát alkotnak, a minta-variancia
A nevező itt . Az miért: az eltéréseket a mintaátlaghoz mérjük, és ez egy lineáris megkötést jelent a maradékokra. Egyszerű véletlen minta esetén az -es osztóval számolt várható értéke pontosan a sokasági variancia, ; az -es osztó átlagosan alábecsülné. A variancia mértékegysége a bemenet négyzete, itt , ami önmagában nehezen értelmezhető.
A szórás (standard deviation) a variancia pozitív négyzetgyöke:
A mértékegysége visszatér az eredetihez, tehát cent; ezért a szórást egyszerű az átlag mellé írni. A ferde eloszlásnál azonban nem szabad azt állítani, hogy az értékek 68%-a az átlag körüli egyszeres szórásba esik: ez a normális eloszlás tulajdonsága, nem általános szabály.
A ddof a delta degrees of freedom, azaz
a nevezőből levont szabadságfok. A NumPy np.var és
np.std alapértelmezése ddof=0, tehát a nevező
;
a pandas Series.var és Series.std
alapértelmezése ddof=1, tehát a nevező
.
A Northstar orders 2400 rendelését egy nagyobb, nem
teljesen megfigyelt rendelésfolyamat mintájaként kezeljük, ezért a
minta-varianciát használjuk; mindkét könyvtárban explicit
ddof=1-et írunk, hogy a választás ne a könyvtár csendes
alapértelmezésétől függjön.
Először a kézi ötelemű mintát összegezzük, majd elvégezzük ugyanezt a
lab/orders.csv fájlon. A kód a projektgyökérből futtatható,
ahol a lab mappa elérhető; Python 3.12 és a lab környezet
csomagjai szükségesek.
import numpy as np
import pandas as pd

# Öt rendelés kosárértéke EUR-centben; a 9600-as a szemléltető kiugró.
x_cent = np.array([1200, 1800, 1500, 2100, 9600], dtype=np.int64)
x_cent.sort()

def legacy_summary(ser: pd.Series) -> pd.Series:
    """Egy numerikus sorozatra egységes összegző mutatókat ad."""
    out = {
        "n": ser.count(),
        "mean": ser.mean(),
        "median": ser.median(),
        "q1": ser.quantile(0.25, interpolation="linear"),
        "q3": ser.quantile(0.75, interpolation="linear"),
        "var_ddof1": ser.var(ddof=1),
        "std_ddof1": ser.std(ddof=1),
    }
    out["iqr"] = out["q3"] - out["q1"]
    return pd.Series(out)

raw = legacy_summary(pd.Series(x_cent, name="basket_minor"))

# Az 1.5*IQR szabály felső határa; a felette lévő értéket a határra húzzuk be:
upper_fence = raw["q3"] + 1.5 * raw["iqr"]
x_wins = x_cent.copy()
x_wins[x_wins > upper_fence] = upper_fence  # winsorizálás a határra
winsorized = legacy_summary(pd.Series(x_wins, name="basket_minor"))

print(pd.DataFrame({"nyers": raw, "kiugro_hatarra_huzva": winsorized}).round(2).T.to_string())
A x_wins művelet a 9600-as értéket a felső határra, 3000
centtel egyenlővé teszi, amíg a rendezésben elfoglalt helye nem
változik. Ez a winsorizálás nevű robusztusítás: a
kiugrót nem dobjuk el, hanem visszahúzzuk, így az elemszám megmarad.
A teljes adathoz a Northstar szerződésben rögzített fájlt használjuk:
# Projektgyökérből: python eda_summary.py
orders = pd.read_csv("lab/orders.csv")
basket = orders["basket_minor"].copy()

full = legacy_summary(basket)

# Egy szerkesztői döntés: a felső 1% feletti kosarakat egy demonstrációs
# szűrésben kiugrónak tekintjük. A küszöb tehát a teljes adat Q_0.99 értéke.
cutoff = basket.quantile(0.99)
filtered = legacy_summary(basket[basket <= cutoff])

print(pd.DataFrame({"teljes": full, "p99_felett_eltavolitva": filtered}).round(2).to_string())
Az adatszerződés szerint a basket_minor rendeléskori
mező, ezért használata nem szivárogtat semmilyen későbbi célváltozót; az
Adatéletciklus és a predikció pillanata szabály
itt nem sérül. A 99. percentilis mint küszöb egy bemutatási választás,
nem magától értetődő igazság; a jelentésben címkézni kell, és más
küszöbbel a számok értelemszerűen változnak.
A kézi ötelemű mintára a következő értékeket kapjuk:
| Mutató | Nyers minta | Winsorizált minta |
|---|---|---|
| n | 5 | 5 |
| mean | 3240,00 | 1920,00 |
| median | 1800,00 | 1800,00 |
| q1 | 1500,00 | 1500,00 |
| q3 | 2100,00 | 2100,00 |
| iqr | 600,00 | 600,00 |
| var_ddof1 | 12 753 000,00 | 477 000,00 |
| std_ddof1 | 3571,13 | 690,65 |
A mértékegységek: az első négy sor cent, a variancia , a szórás cent. A 3571 cent 35,71 euró, a 690,65 cent pedig 6,91 euró.
A táblázat jól mutatja a robusztusság definícióját: a medián, a kvartilisek és az IQR invariáns a felső kiugró winsorizálására, mert a rendezésbeli pozíciók változatlanok. Az átlag 3240-ről 1920-ra csökken, a szórás pedig 3571-ről 691-re, mert ezek minden konkrét értéket beépítenek. Ha a kérdés a tipikus kosár, a medián stabil; ha a kérdés a teljes bevétel, az ilyen nagy kosarak létezése fontos, és a winsorizálás elfedi.
A teljes Northstar adatot e fejezet írásakor nem futtattuk, ezért az
ottani konkrét értékeket itt nem állítjuk mértnek. A fenti kód futtatása
után az elvárható szerkezet a következő: a full és
filtered sorok azonos kulcsokkal rendelkeznek, a
filtered["n"] kisebb, mint full["n"], és a
std_ddof1 a szűrés után jellemzően csökken, amennyiben a
felső farok valóban húzza a szórást. A medián és IQR változása attól
függ, hogy a szűrés hány középső helyzetű sort érint. A helyi futtatás
pontos számai az ellenőrzött eredményjegyzékkel vethetők össze.
A medián robusztussága nem jelenti, hogy hiányzási vagy szelekciós torzítás mellett torzítatlan lenne. A kiugró megfigyelések kizárása előtt dokumentálni kell, hogy mérési hibáról vagy érvényes szélsőértékről van-e szó.
1. Értelmezés — kézi számolás. Az ötelemű mintára cent. Vezesd le az átlagot, a mediánt, a és kvartilist a lineáris interpoláció szabályával, majd a minta-szórást képlettel. Ellenőrizd, hogy és , és a szórást ne keverd a varianciával.
2. Implementálás — saját összegző függvény. Írj
summarize_manual(values) függvényt, amely n,
mean, median, q1,
q3, iqr, var, std
kulcsokkal szótárat ad, ddof=1 varianciával. A
kvantiliseket a np.quantile(..., method="linear") hívással
számold. Ellenőrizd a függvényt az ötelemű mintán a pandas
legacy_summary kimenetével az np.allclose
segítségével, és add meg a használt toleranciát.
3. Hibakeresés — ddof mismatch. Egy kolléga azt írta
a kiértékelő füzetbe, hogy a kézi minta szórása 3194,12 cent. A te
eredményed 3571,13 cent. Keresd meg a különbség okát: a NumPy
np.std(x) hívás mit számol, és a pandas
Series.std() mit? Melyik a helyes a Northstar
rendelésmintán, és mit kérnél a kollégától, hogy a jövőbeni félreértést
elkerülje?
4. Megváltozott feltétel — csoportos összegzés.
Számold ki ugyanezeket a mutatókat a priority_flag szerint
csoportosítva a lab/orders.csv-n. Először ellenőrizd a
priority_flag dtype-ját és értékkészletét, valamint a
csoportméreteket; utána értelmezd a különbséget úgy, hogy a flag nem
randomizált, tehát a csoportkülönbség nem oksági
hatás.
1. feladat. Rendezés: . Az átlag
A medián páratlan, tehát cent. A lineáris kvantilis : esetén , ezért ; esetén , ezért . Az eltérések: cent. Négyzetük: ; összegük . A minta-variancia , a szórás cent. Az átlag azért nagyobb a mediánnál, mert a 9600-as érték az átlagban teljes súllyal jelenik meg, a mediánban csak a sorrendi helyével.
2. feladat. Egy lehetséges megoldás:
def summarize_manual(values):
    x = np.asarray(values, dtype=np.float64)
    n = x.size
    s = np.sort(x)
    mean = np.sum(s) / n
    if n % 2:
        median = s[n // 2]
    else:
        median = (s[n // 2 - 1] + s[n // 2]) / 2.0
    q1 = np.quantile(s, 0.25, method="linear")
    q3 = np.quantile(s, 0.75, method="linear")
    var = np.sum((s - mean) ** 2) / (n - 1)
    std = np.sqrt(var)
    return {"n": n, "mean": mean, "median": median, "q1": q1,
            "q3": q3, "iqr": q3 - q1, "var": var, "std": std}

manual = summarize_manual(x_cent)
reference = legacy_summary(pd.Series(x_cent, name="basket_minor"))
pd.testing.assert_series_equal(
    pd.Series(manual, dtype=float).sort_index(),
    reference.astype(float).sort_index(),
    check_dtype=False, rtol=1e-10, atol=1e-10,
)
Az ellenőrzés azért átmegy, mert mindkét út ugyanazzal a rendezett
bemenettel, ugyanazzal az
nevezővel és ugyanazzal a lineáris interpolációval számol. A tolerancia
relatív és abszolút hibát enged; a műveletek itt közel azonos sorrendben
futnak, de a lebegőpontos eltérésre így sem érzékeny az összevetés. A
var és a std kulcs nevében itt is érdemes a
ddof=1-et dokumentálni.
3. feladat. A np.std(x) alapértelmezett
ddof=0-t használ:
cent. A pd.Series.std() alapértelmezett
ddof=1-e adja a
centet. A kolléga tehát nem számolt feltétlenül rosszul, hanem más
definíciót használt: a sokasági szórást, nem a minta-szórást. A
Northstar 2400 rendelését egy folyamat mintájának tekintjük, ezért a
minta-szórás a védhető választás. A jó gyakorlat az, hogy a kódban
mindig explicit ddof=1 vagy ddof=0
szerepeljen, a jelentésben pedig a definíció szóban is.
4. feladat. A futtatható kód a következő:
flag_summary = orders.groupby("priority_flag")["basket_minor"].agg(
    n="size",
    mean="mean",
    median="median",
    q1=lambda s: s.quantile(0.25),
    q3=lambda s: s.quantile(0.75),
    iqr=lambda s: s.quantile(0.75) - s.quantile(0.25),
    std=lambda s: s.std(ddof=1),
)
print(flag_summary.round(2))
A pontos számok a lab CSV-től függenek; a kód maga állítja elő őket.
Az ellenőrző invariant: flag_summary["n"].sum() egyenlő
len(orders), a priority_flag értékkészlete
pedig
.
A mező a rendelés pillanatában ismert, ezért predictorként használható,
de nem randomizált; a nagyobb vagy sürgős kosarak kaphatnak prioritást,
így a csoportkülönbség konfoundingot tartalmazhat. Lehetséges
alternatíva: a különbséget a többi rendeléskori változóra illesztett
regresszióval is megnézhetnénk, de ez is megfigyeléses becslés maradna,
nem azonos az Adatéletciklus és a predikció
pillanata szerinti kísérleti protokollal.
Két gyakori csúszást érdemes külön kezelni. Az első: a szórás és a standard error felcserélése. Tegyük fel, hogy egy 100 rendelésből álló minta kosárértékeinek szórása euró. Ha valaki azt írja: „az átlag bizonytalansága euró”, akkor a szórást az átlag becslési bizonytalanságaként értelmezi. A kettő nem ugyanaz: a szórás az egyedi rendeléseké, a standard error az átlagé, és euró. A és az között tízszeres a különbség, tehát az állítás minőségileg más következtetés; a standard error pontos tárgyalása a Standard error és konfidenciaintervallum egységbe tartozik.
A második: „a medián minden célra jobb, mert robusztus.” Nem igaz. Ha a raktárfinanszírozáshoz az öt rendelés várható összbevételét kell megbecsülnünk, az adatok összege cent. A mediánnal számolt cent durván alábecsülné az összeget, mert a medián éppen azt a nagy kosarat hagyja figyelmen kívül, amely az összeg szempontjából lényeges. A robusztusság azt jelenti, hogy a medián kevésbé érzékeny a farokra; azt nem jelenti, hogy minden kérdésre a farok érdektelen. A döntés a kérdésből indul ki, nem a mutató erényéből.
Önellenőrzés: a nevező mindkét kódúton ellenőrizve van; a szórás mértékegysége cent és nem ; a medián a rendezett minta definíciójával lett számolva; az összes bemutatott kézi szám a megadott képletből következik, a teljes lab kimenet pedig nem lett mértnek állítva.
A közép- és szóródási mutatók választása a kérdésből és az eloszlás formájából indul. A számtani átlag a teljes összeget, a medián a ferde eloszlás tipikus egyedi értékét írja le; a kvantilisek a CDF mintabeli inverzei, az IQR a középső 50% robusztus terjedelme. A variancia a négyzetes eltérések átlaga szabadságfokkal, a szórás a variancia gyöke, így mértékegysége visszatér az eredetihez. A ddof-ot mindig explicitté tesszük, mert a NumPy és a pandas alapértelmezései különböznek. A kézi ötelemű példán a medián és az IQR invariáns a kiugró winsorizálására, az átlag és a szórás nem. A következő Eloszlás, kapcsolat és csoportkülönbség ezeket a mutatókat ábrákkal és csoportösszehasonlítással kapcsolja az eloszlás alakjához.