A 38.1. Adat, split és előzetes protokoll
egység befagyasztotta a GlyphLab protokollját: a megfigyelési egység a
scene_id, a train/val/test felosztás scene-szintű, a
tesztet és a corrupted_test.npy változatot csak a végső,
választott modellen szabad kiértékelni. Ebben az egységben a
tanítási szakaszt építjük fel. A cél egy kis CPU-s CNN
tanítása, minden tréning- és validációs adat útjának naplózása, valamint
egy valódi best snapshot mentése. A modellválasztás a
validációs loss alapján történik egy előre rögzített, véges
jelöltkészletből: a tanítás során keletkező epoch-snapshotok közül.
Előismeret. A 37.2. Backward és
ellenőrzési lefedettség egységben a konvolúciós forward és backward
levezetése, valamint véges differenciás ellenőrzése megtörtént; a jelen
fejezetben az autograd által kiszámolt gradienseket már ellenőrzött
operátorként kezeljük. A 34.2. Kvantálás és
hibatovábbterjedés egység rögzítette, hogy a főút
float32 CPU-számítás; itt nem kvantálunk. A 26.2. Egy- és kétlépcsős detektor detektorfejezete
emlékeztetett arra, hogy egy osztályozó fej és egy lokalizáló/detektor
fej felelőssége különbözik: a mostani modell kimenete csak három
osztálylogit, nem doboz vagy maszk.
Induló kérdés. Egy -es, egycsatornás képet az alábbi lánc dolgoz fel: -as konvolúció 8 csatornára, ReLU, -es max-pooling, -as konvolúció 16 csatornára, ReLU, -es max-pooling, majd egy 32 egységes rejtett réteg és egy 3 logitot adó kimeneti réteg. Hány tanulható skalár paramétert tartalmaz a háló? Mielőtt tovább olvas, adjon becslést; a pontos levezetés a 3. szakaszban következik.
A laborban használt modell a GlyphCNN:
features: Conv2d(1, 8, 3, padding=1) →
ReLU → MaxPool2d(2) →
Conv2d(8, 16, 3, padding=1) → ReLU →
MaxPool2d(2);classifier: Flatten →
Linear(16·6·6, 32) → ReLU →
Linear(32, 3).A bemenet alakja
,
elemei a
intenzitástartományban vannak, dtype float32, NCHW
elrendezésben. A kimenet
aktiváció előtti logit. A célvektor
,
dtype int64, ahol
vertical,
horizontal,
diagonal.
A CE-szerződés. A modell logitot ad; a
cross_entropy hívás előtt nem alkalmazunk külön softmaxot.
A veszteség az
megfigyelés átlaga:
ahol . A sum-redukciós változatot külön jelölnénk; a főút az átlag.
A 38.1. Adat, split és előzetes protokoll alfejezetben rögzített baseline a lineáris osztályozó: a pixelt egyetlen vektorba lapítja, és logitot ad ( paraméter). Ugyanazzal a recepttel, ugyanazon a három seeden és ugyanazzal a választási szabállyal tanítjuk, mint a CNN-t; az egyetlen szándékosan változtatott tényező az architektúra. Emellett külön minimum-referenciaként megadjuk a képfüggetlen prior-osztályozót: minden képre a train-osztálygyakoriságból becsült eloszlást adja. A GlyphLab train halmaza osztályonként képet tartalmaz, tehát , a várható pontosság , és a várható cross-entropy
Egy tanított modell akkor hordoz tanult jelet, ha a validációs lossa ettől számottevően kisebb; a lineáris baseline-nak és a CNN-nek is ehhez kell viszonyulnia, ugyanazon a befagyasztott validációs halmazon.
A tanulható súlyokat explicit Kaiming-uniform inicializálással állítjuk be ReLU-hoz, a biasokat nullára. A motivációt a 21.1. Inicializálás és varianciaterjedés varianciaterjedési érvelése adja: a ReLU előtti affin kimenet varianciáját rétegről rétegre meg kell őrizni. Az utolsó lineáris rétegre ugyanezt a kis skálájú inicializálást használjuk, mert a három logit kezdeti nagyságrendje így stabil a softmax számára. Ez heurisztika, nem bizonyított optimum; a labor az explicit receptet naplózza, hogy a kísérlet reprodukálható legyen.
Az kezdő tanulási rátát koszinuszos ütemezéssel csökkentjük epoch alatt:
A laborban
,
.
Az optimizáló AdamW,
decoupled weight decay-jel; a 6.4. Momentum és
adaptív optimizálók egység rögzítette, hogy az AdamW-féle
súlycsökkentés nem azonos a lossba írt L2-tag Adam alatti hatásával. Az
ütemezést az epoch ciklusban kézzel írjuk az optimizáló
paramétercsoportjaiba, így a labor nem függ egy adott scheduler API
belső T_cur-definíciójától.
Definíció (snapshot). A
.
epoch befejezése utáni modellállapot
:
a state_dict, vagyis a tanulható tensorok rendezett
név–érték leképezése. A snapshot nem tartalmazza az optimizáló
állapotát; a jelen kísérletben a kiválasztás után nincs folytatás.
Definíció (validation-alapú snapshot-választás, best-snapshot selection). Legyen az epochonként mentett, véges jelöltkészlet. Jelölje a . snapshoton a teljes validációs halmazra számolt átlagos cross-entropyt. A választott snapshot indexe
Az early choice elnevezés arra utal, hogy nem feltétlenül az utolsó epoch: a legjobb validációs állapot gyakran korábban következik be. A tesztet egyetlenegyszer, a befagyasztott snapshoton értékeljük.
A egy véges mintán számolt becslés, ezért a választott snapshot validációs értéke optimista lehet a valódi validációs kockázatra nézve. Ezt a jelenséget a jelen egységben nem bizonyítjuk koncentrációs tétellel; a végső teszt intervallumos értelmezéséhez a 38.4. Mentett modellből független inference egység a [S02] feltételes, ismételt mintavételi keretét használja.
1. Lemma (rétegparaméterszám). Legyen egy konvolúciós réteg súlytenzora és biasvektora . A tanulható paraméterek száma
Affin rétegnél , , tehát .
Bizonyítás. A súlytenzor elemszáma a dimenziók szorzata: . A bias minden kimeneti csatornához egy-egy skalárt ad, ami további elem. Az affin esetben elemszáma , a bias . Az állítás a tenzoralak definíciójából következik; nincs szükség közelítésre.
Alkalmazás a GlyphCNN-re.
2. Lemma (alakzártság a rétegláncon). A fenti GlyphCNN -es bemenetre az 1. táblázat alakjait állítja elő.
| Művelet | Kimeneti alak | Paraméterszám |
|---|---|---|
| Conv1, , | 80 | |
| MaxPool2d(2) | 0 | |
| Conv2, , | 1168 | |
| MaxPool2d(2) | 0 | |
| Flatten | 0 | |
| Linear1 | 18464 | |
| Linear2 | 99 |
Bizonyítás. Használjuk a 14.1. Stride, padding, dilation és outputméret szimmetrikus padding képletét , mellett, egy térbeli dimenzióra:
(Itt a térbeli magasság; a szélességi jelölést a súlymátrixszal való ütközés miatt külön mondjuk ki: a betű ebben a bekezdésben térbeli méret, a súlyokat jelöli.) Conv1: . A MaxPool : . Conv2: . A második pool: . A flatten méret . A lineáris rétegek a megadott be- és kimeneti dimenziókat valósítják meg. A paraméterszám az 1. lemma alkalmazása.
A kis modell számításigénye is ellenőrizhető: Conv1 forwardja MAC, Conv2-é MAC, a két lineáris réteg MAC. A domináns költség a második konvolúció, nem a teljesen kapcsolt rész.
3. Lemma (mean-redukált CE-gradiens). Legyen logitmátrix és . Definiáljuk
Ekkor minden párra
A PyTorch F.cross_entropy(Z, y) a fenti
értéket számolja, stabil log-sum-exp implementációval; a modell
kimenetének tehát logitnak kell lennie, és a cél int64
osztályindex.
Bizonyítás. Rögzítsünk egy sort, és röviden írjunk -t helyett, -t helyett. Legyen . Ekkor , tehát
A negatív előjel és az átlagolás bevitelével
Az eredmény alakja , megegyezik alakjával, ahogy a skalár loss tenzorgradiensétől elvárjuk.
A lemma egyben megmagyarázza, miért szokták a hibajelet „softmax mínusz one-hot” alakban emlegetni: a batch-átlag osztója , nem a osztályszám.
CE-számolás. Legyen , , és . Az exponenciális értékek , , , az összeg . A softmax:
A loss . A 3. lemma szerint a gradiens
Ellenőrzés a szerződésen. A loss skalár, a gradiens
alakja
,
és a gradiens elemeinek összege
,
ami a softmax-kimenet és a one-hot közötti különbség elvárt nulla
összegű tulajdonsága. Ha valaki a modell végére tett volna softmaxot,
akkor a F.cross_entropy még egy log-softmaxot alkalmazna,
és a fenti gradiens helyett másodrendű tagok jelennének meg: ez a
leggyakoribb CE-szerződéssértés.
Ugyanez PyTorchban numerikusan ellenőrizhető; a cella a lab-profilban
(PyTorch 2.14.1+cpu) futtatva L = 0.4644-et és
[-0.3715, 0.2312, 0.1402] gradienst adott, négy tizedesre
kerekítve:
import torch
from torch.nn import functional as F
Z = torch.tensor([[2.0, 1.0, 0.5]], dtype=torch.float32, requires_grad=True)
y = torch.tensor([0], dtype=torch.int64)
L = F.cross_entropy(Z, y)
L.backward()
# várt: L ~ 0.4644, Z.grad ~ [[-0.3715, 0.2312, 0.1402]]Munkakönyvtár: a laborcsomag lab/
könyvtára, benne a data/ a GlyphLab fájljaival. A labor
három fájlból áll. A lab/glyph_models.py a projekt egyetlen
modellforrása: ezt importálja a tanítás (38.2.
Modell, training és best checkpoint), a végső teszt (38.3. Végső teszt és páros korrupció) és a
csomagolás (38.4. Mentett modellből független
inference), így a modellosztály neve és rétegszerkezete nem térhet
el a lépések között. A lab/train_small_cnn.py egy
(architektúra, seed) futást végez; csak a train és val splitet tölti be,
a teszt és a korrupt teszt nem szerepel benne. A
lab/run_project2.py a 38.1. Adat, split
és előzetes protokoll protokollját hajtja végre egyetlen
paranccsal.
# lab/glyph_models.py — a Projekt II egyetlen modellforrása (n150, n151, n152)
import torch
from torch import nn

# Egyszálas CPU-számítás: a lebegőpontos összegzési sorrend így nem függ a gép
# magszámától, és azonos könyvtárverziók mellett a futás bitazonosan ismételhető.
torch.set_num_threads(1)

# A n149 protokollban előre rögzített paraméterszámok és a közös keret.
ARCH_PARAMS = {"cnn": 19811, "linear": 1731}
PARAM_BUDGET = 20000


def _kaiming(module):
    for m in module.modules():
        if isinstance(m, (nn.Conv2d, nn.Linear)):
            nn.init.kaiming_uniform_(m.weight, a=0.0)
            if m.bias is not None:
                nn.init.zeros_(m.bias)


class GlyphCNN(nn.Module):
    """Kis CNN: (N,1,24,24) float32 -> (N,3) logit."""
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 8, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(8, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
        )
        self.classifier = nn.Sequential(
            nn.Flatten(), nn.Linear(16 * 6 * 6, 32), nn.ReLU(), nn.Linear(32, 3)
        )
        _kaiming(self)

    def forward(self, x):
        return self.classifier(self.features(x))


class LinearBaseline(nn.Module):
    """Lineáris baseline: flatten 576 -> 3 logit, ugyanazzal a CE-szerződéssel."""
    def __init__(self):
        super().__init__()
        self.classifier = nn.Sequential(nn.Flatten(), nn.Linear(24 * 24, 3))
        _kaiming(self)

    def forward(self, x):
        return self.classifier(x)


def build(arch):
    return {"cnn": GlyphCNN, "linear": LinearBaseline}[arch]()


def count_parameters(model):
    return sum(p.numel() for p in model.parameters() if p.requires_grad)


def load_checkpoint(path, map_location="cpu"):
    """A n150 checkpointsémája: model_state_dict, arch, seed, epoch, val_loss, params."""
    ckpt = torch.load(path, map_location=map_location, weights_only=True)
    model = build(ckpt["arch"])
    model.load_state_dict(ckpt["model_state_dict"])     # strict: minden kulcs egyezik
    model.eval()
    return model, ckpt
A checkpoint sémája. Minden futás
runs/<arch>_s<seed>/best.pt fájlja egy szótár:
model_state_dict (a súlyok), arch
(cnn vagy linear), seed,
epoch, val_loss, params és
recipe. A betöltés mindig a load_checkpoint
függvényen át, weights_only=True módon történik, és a
load_state_dict alapértelmezett szigorú kulcsegyezését
használja; ugyanezt a sémát olvassa a 38.3. Végső
teszt és páros korrupció is, kézi átnevezés nélkül.
# lab/train_small_cnn.py — n150: egy (architektúra, seed) futás, napló, best checkpoint.
import argparse, csv, json, math, os, time
import numpy as np
import torch
from torch.nn import functional as F
from torch.utils.data import DataLoader, TensorDataset

from glyph_models import build, count_parameters, load_checkpoint


def cosine_lr(t, T, lr0, eta_min):
    return eta_min + 0.5 * (lr0 - eta_min) * (1.0 + math.cos(math.pi * t / T))


def split_ids(root, split):
    with open(os.path.join(root, "data", "metadata.csv"), newline="") as f:
        return np.array([int(r["index"]) for r in csv.DictReader(f) if r["split"] == split],
                        dtype=np.int64)


def load_split(root, split):
    """Csak train/val: a teszt és a korrupt teszt ebben a fájlban nem nyílik meg."""
    assert split in ("train", "val")
    ids = split_ids(root, split)
    X = np.load(os.path.join(root, "data", "images.npy")).astype(np.float32)[ids]
    Y = np.load(os.path.join(root, "data", "labels.npy")).astype(np.int64)[ids]
    return TensorDataset(torch.from_numpy(X), torch.from_numpy(Y))


@torch.no_grad()
def evaluate(model, loader):
    model.eval()
    total, correct, n, logits_all = 0.0, 0, 0, []
    for xb, yb in loader:
        logits = model(xb)
        total += F.cross_entropy(logits, yb).item() * xb.shape[0]
        correct += (logits.argmax(dim=1) == yb).sum().item()
        n += xb.shape[0]
        logits_all.append(logits)
    return total / n, correct / n, torch.cat(logits_all)


def train(arch="cnn", seed=20261020, epochs=24, lr=1e-3, wdecay=1e-4,
          batch_size=32, root="."):
    torch.manual_seed(seed)
    np.random.seed(seed)
    tr_loader = DataLoader(load_split(root, "train"), batch_size=batch_size, shuffle=True,
                           generator=torch.Generator().manual_seed(seed))
    va_loader = DataLoader(load_split(root, "val"), batch_size=batch_size, shuffle=False)

    model = build(arch)                    # az init a seedtől függ
    opt = torch.optim.AdamW(model.parameters(), lr=lr, weight_decay=wdecay)
    run_dir = os.path.join(root, "runs", f"{arch}_s{seed}")
    os.makedirs(run_dir, exist_ok=True)
    best = {"val_loss": float("inf")}
    with open(os.path.join(run_dir, "metrics.jsonl"), "w", encoding="utf-8") as log:
        for epoch in range(epochs):
            t0 = time.perf_counter()
            lr_t = cosine_lr(epoch, epochs, lr, 1e-5)      # az epoch elején érvényes ráta
            for pg in opt.param_groups:
                pg["lr"] = lr_t
            model.train()
            tr_total, tr_n = 0.0, 0
            for xb, yb in tr_loader:
                opt.zero_grad(set_to_none=True)
                loss = F.cross_entropy(model(xb), yb)
                loss.backward()
                opt.step()
                tr_total += loss.item() * xb.shape[0]
                tr_n += xb.shape[0]
            va_loss, va_acc, va_logits = evaluate(model, va_loader)
            is_best = va_loss < best["val_loss"]
            if is_best:
                best = {"epoch": epoch + 1, "val_loss": va_loss, "val_acc": va_acc,
                        "logits": va_logits.clone()}
                torch.save({"model_state_dict": model.state_dict(), "arch": arch,
                            "seed": seed, "epoch": epoch + 1, "val_loss": va_loss,
                            "params": count_parameters(model), "recipe": "cosine_adamw"},
                           os.path.join(run_dir, "best.pt"))
            log.write(json.dumps({"epoch": epoch + 1, "train_loss": tr_total / tr_n,
                                  "val_loss": va_loss, "val_acc": va_acc, "lr": lr_t,
                                  "best": is_best,
                                  "seconds": time.perf_counter() - t0}) + "\n")

    # Visszatöltési kontroll: a mentett best.pt ugyanazokat a val-logitokat adja.
    reloaded, ckpt = load_checkpoint(os.path.join(run_dir, "best.pt"))
    re_loss, _, re_logits = evaluate(reloaded, va_loader)
    max_diff = float((re_logits - best["logits"]).abs().max())
    assert max_diff <= 1e-6 and abs(re_loss - best["val_loss"]) <= 1e-6, (max_diff, re_loss)
    summary = {"arch": arch, "seed": seed, "best_epoch": best["epoch"],
               "best_val_loss": best["val_loss"], "best_val_acc": best["val_acc"],
               "params": count_parameters(model), "reload_max_abs_logit_diff": max_diff}
    with open(os.path.join(run_dir, "summary.json"), "w") as f:
        json.dump(summary, f, indent=2)
    return summary


if __name__ == "__main__":
    ap = argparse.ArgumentParser()
    ap.add_argument("--arch", choices=["cnn", "linear"], default="cnn")
    ap.add_argument("--seed", type=int, default=20261020)
    ap.add_argument("--epochs", type=int, default=24)
    ap.add_argument("--lr", type=float, default=1e-3)
    ap.add_argument("--wdecay", type=float, default=1e-4)
    ap.add_argument("--batch-size", type=int, default=32)
    ap.add_argument("--root", default=".")
    a = ap.parse_args()
    print(json.dumps(train(a.arch, a.seed, a.epochs, a.lr, a.wdecay, a.batch_size, a.root)))
A koszinuszos rátát minden epoch elején állítjuk be,
így az első epoch
-lal
fut, és a naplóban az az érték szerepel, amellyel az adott epoch
ténylegesen tanult. A futás végén a szkript visszatölti a mentett
best.pt-t, és összeveti a validációs logitokat a mentés
pillanatában számoltakkal; eltérés esetén
AssertionError-ral megáll.
# lab/run_project2.py — n150: a teljes tanítási szakasz egy paranccsal.
# Két architektúra × három seed, paraméterszám-ellenőrzés, validációs összevetés,
# és a protokoll választási szabálya szerinti checkpointok a n151 számára.
import json, math, os, shutil, statistics
from glyph_models import ARCH_PARAMS, PARAM_BUDGET
from train_small_cnn import train

SEEDS = (20261020, 20261021, 20261022)      # a n149 protokoll seedlistája


def main(root="."):
    runs = {arch: [train(arch, s, root=root) for s in SEEDS] for arch in ("linear", "cnn")}
    report = {"seeds": list(SEEDS), "prior_val_loss": math.log(3), "prior_val_acc": 1 / 3,
              "archs": {}}
    os.makedirs(os.path.join(root, "checkpoints"), exist_ok=True)
    for arch, rs in runs.items():
        assert all(r["params"] == ARCH_PARAMS[arch] <= PARAM_BUDGET for r in rs), arch
        chosen = min(rs, key=lambda r: r["best_val_loss"])     # választás csak val alapján
        shutil.copyfile(os.path.join(root, "runs", f"{arch}_s{chosen['seed']}", "best.pt"),
                        os.path.join(root, "checkpoints", f"best_val_{arch}.pt"))
        accs = [r["best_val_acc"] for r in rs]
        losses = [r["best_val_loss"] for r in rs]
        report["archs"][arch] = {
            "params": rs[0]["params"], "runs": rs, "chosen_seed": chosen["seed"],
            "val_acc_mean": statistics.mean(accs), "val_acc_sd": statistics.stdev(accs),
            "val_loss_mean": statistics.mean(losses), "val_loss_sd": statistics.stdev(losses)}
    with open(os.path.join(root, "runs", "project2_val_report.json"), "w") as f:
        json.dump(report, f, indent=2)
    print("arch    params  seed      best_ep  val_loss  val_acc")
    for arch, rs in runs.items():
        for r in rs:
            print(f"{arch:7s} {r['params']:6d}  {r['seed']}  {r['best_epoch']:3d}"
                  f"      {r['best_val_loss']:.4f}    {r['best_val_acc']:.3f}")
    for arch, a in report["archs"].items():
        print(f"{arch}: val_acc {a['val_acc_mean']:.3f} ± {a['val_acc_sd']:.3f}, "
              f"választott seed {a['chosen_seed']} -> checkpoints/best_val_{arch}.pt")


if __name__ == "__main__":
    main()
Futtatás egy paranccsal:
cd lab
python run_project2.py
Egyetlen futás külön is indítható, például
python train_small_cnn.py --arch cnn --seed 20261020. A
kimenet: hat futáskönyvtár (runs/linear_s<seed>,
runs/cnn_s<seed>, mindegyikben
metrics.jsonl, best.pt,
summary.json), a runs/project2_val_report.json
összevetés és a checkpoints/best_val_cnn.pt,
checkpoints/best_val_linear.pt választott checkpointok.
Minden eltérő recept (más --lr, --batch-size,
módosított modell) külön könyvtárba kerül; tilos két recept naplóját
összemásolni.
Protokoll. A seed az inicializálásra és a
train-shuffle generátorára vonatkozik. A [D02] dokumentáció szerint a
seed önmagában nem ígér platformok és verziók közötti bitazonosságot;
ezért a napló a recept neve mellett a seedet is rögzíti, és az
eredményeket csak az adott környezet reprodukciójához kötjük. A
glyph_models.py egyszálas CPU-számítást állít be
(torch.set_num_threads(1)): többszálas futásnál a
lebegőpontos összegzés sorrendje a gép magszámától függ, és az utolsó
jegyek gépenként eltérhetnek.
Futási jegyzőkönyv. A
python run_project2.py az eredeti GlyphLab-adaton, CPU-n
(Python 3.12.3, NumPy 2.3.5, PyTorch 2.14.1+cpu) körülbelül 3 másodperc
alatt lefutott, és két teljes, egymás utáni futás bitazonos eredményt
adott:
arch    params  seed      best_ep  val_loss  val_acc
linear    1731  20261020    1      1.1155    0.267
linear    1731  20261021    1      1.1031    0.300
linear    1731  20261022    1      1.1192    0.350
cnn      19811  20261020   24      0.3029    0.900
cnn      19811  20261021   15      0.3683    0.900
cnn      19811  20261022   19      0.2326    0.917
linear: val_acc 0.306 ± 0.042, választott seed 20261021 -> checkpoints/best_val_linear.pt
cnn: val_acc 0.906 ± 0.010, választott seed 20261022 -> checkpoints/best_val_cnn.pt
A paraméterszám-ellenőrzés mindkét modellre teljesült
(
és
,
mindkettő a
-es
keret alatt), és mind a hat futásban a visszatöltött
best.pt logitjai pontosan egyeztek a mentéskoriakkal
(reload_max_abs_logit_diff
).
A lineáris baseline validációs lossa mindhárom seeden a prior
értéke fölött marad, és a legjobb snapshotja az első epoch: a
pixelvektor lineáris függvénye ezen a feladaton nem tanul
általánosítható jelet, mert a vonalak helye jelenetenként változik, az
orientáció pedig nem lineáris függvénye a pixelintenzitásoknak. A CNN
mindhárom seeden
körüli validációs pontosságot ér el. Más verziójú könyvtárakkal vagy más
CPU-n az utolsó jegyek eltérhetnek; a saját
project2_val_report.json a leadandó.
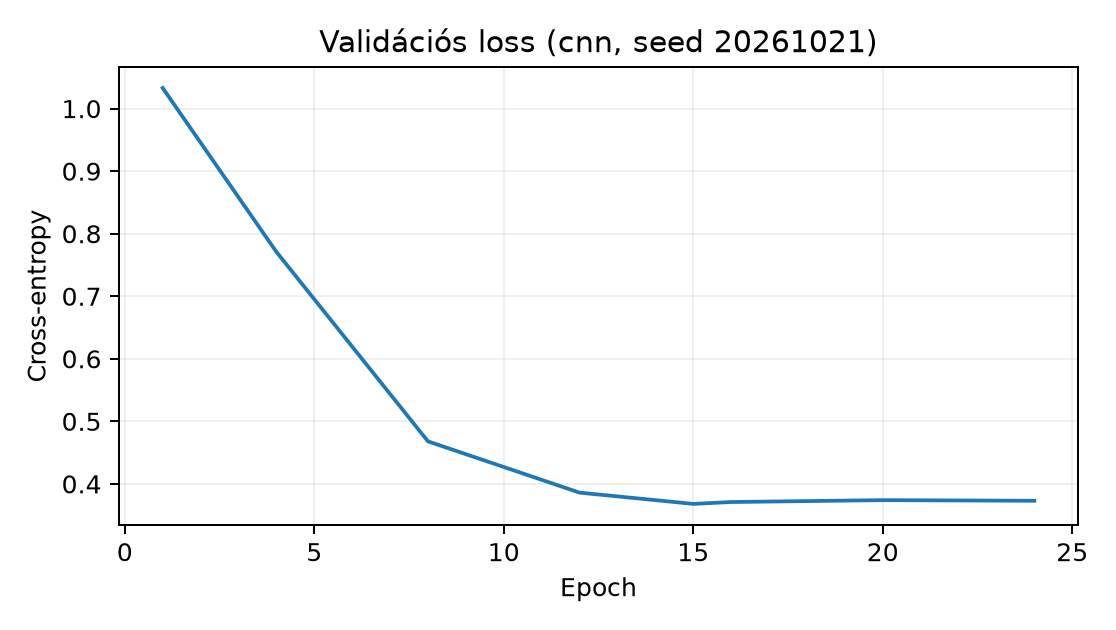
A cnn_s20261021 futás naplójának részlete mutatja a best
és a last snapshot különbségét:
epoch train_loss val_loss val_acc lr       best
1     0.990      1.033    0.567   1.00e-03 yes
4     0.475      0.771    0.767   9.62e-04 yes
8     0.121      0.468    0.900   8.06e-04 yes
12    0.043      0.386    0.900   5.70e-04 no
15    0.029      0.368    0.900   3.77e-04 yes
16    0.027      0.371    0.900   3.16e-04 no
20    0.022      0.374    0.900   1.12e-04 no
24    0.021      0.373    0.900   1.42e-05 no
best_epoch=15 best_val_loss=0.3683
A train loss tovább csökken, a validációs loss viszont a 15. epoch
után már nem javul: a best.pt a 15. epoch állapota, nem az
utolsóé. Ugyanezen a futáson a validációs pontosság a 8. epochtól
változatlan, tehát a választást a loss, nem az accuracy dönti el.
F1 (fogalmi, nehézség 1). Előfeltétel: a 2.5.
szakasz. Fogalmazza meg saját szavaival, mi a különbség a legutolsó
snapshot és a validation-alapú best snapshot között, és
adjon egy minimális, három epochra vonatkozó val_loss
sorozatot, ahol a kettő nem esik egybe. Elvárt átadandó eredmény:
definíció és a három elemű számsor.
F2 (levezetési/bizonyítási, nehézség 2). Előfeltétel: a 3. szakasz lemmái. Legyen
Számítsa ki kézzel a mean-redukált cross-entropyt és a -as gradiensmátrixot. Ellenőrizze az alakot, és azt, hogy minden sor gradiensösszege nulla. Elvárt átadandó eredmény: a loss közelítő értéke, a gradiensmátrix, valamint a 3. lemma alkalmazásának jelölése.
F3 (implementációs, nehézség 2). Előfeltétel: a
labor script lefutott. Írjon egy select_best függvényt,
amely a runs/<arch>_s<seed>/metrics.jsonl
soraiból kiválasztja a legkisebb val_loss sort, betölti a
best.pt fájlt weights_only=True módon, és a
validációs halmazon reprodukálja a loss értékét
tűréssel. Elvárt átadandó eredmény: futtatható kód,
best_epoch és a reprodukált val_loss.
F4 (hibakeresési, nehézség 1). Előfeltétel: a labor
naplója. Egy hallgató a best.pt mentését így írta:
if epoch + 1 == epochs:
    torch.save({"model_state_dict": model.state_dict(), "arch": arch, "seed": seed,
                "epoch": epoch + 1, "val_loss": va_loss},
               os.path.join(run_dir, "best.pt"))
A summary.json-ban mégis best_epoch=15 áll.
Hol a hiba, mi a következménye a zárótesztre, és hogyan ellenőrzi a
javítást? Elvárt átadandó eredmény: ok, következmény, javított feltétel
és a betöltött modell loss-ellenőrzése.
F5 (kísérleti/transzfer, nehézség 3). Előfeltétel: a 38.1. Adat, split és előzetes protokoll protokollterve. Tegyük fel, hogy egy új munkacsoport két kis architektúrát, A-t és B-t akar kiválasztani a GlyphLab validációs lossa alapján, három seeddel. Írjon előzetes protokollt: megfigyelési egység, split, baseline, változó tényező, döntési metrika, külön futásnaplók és a tesztkiértékelés időpontja. Nevezze meg azt a statisztikai korlátot, amely a validációval végzett architektúraválasztás után a tesztmetrikát terheli. Elvárt átadandó eredmény: egy bekezdésnyi protokoll és a korlát megnevezése indoklással.
A legutolsó snapshot a tanítási szerződésben rögzített . epoch utáni állapot, minden további válogatás nélkül. A best snapshot ezzel szemben a véges jelöltkészlet azon eleme, amelyre a teljes validációs halmazon számolt átlagos cross-entropy minimális. A kettő akkor és csak akkor esik egybe, ha . Példa: . Ekkor , a legutolsó snapshot a 3. epochhoz tartozik, és rosszabb validációs értéket hordoz.
Első sor: , , , összegük . A softmax , a cél , így a sor lossza . Második sor: , , , összegük . A softmax , a cél , a sor lossza . Az átlag
A gradiens a 3. lemma szerint soronként , :
Alakellenőrzés: , megegyezik alakjával. Mindkét sor összege: és , a kerekítési hibán belül.
import json, math, os
from torch.utils.data import DataLoader
from glyph_models import load_checkpoint
from train_small_cnn import evaluate, load_split

def select_best(run_dir, root=".", batch_size=32, tol=1e-4):
    with open(os.path.join(run_dir, "metrics.jsonl"), encoding="utf-8") as f:
        rows = [json.loads(line) for line in f]
    best = min(rows, key=lambda r: r["val_loss"])
    model, ckpt = load_checkpoint(os.path.join(run_dir, "best.pt"))  # weights_only=True
    assert ckpt["epoch"] == best["epoch"], (ckpt["epoch"], best["epoch"])
    va_loader = DataLoader(load_split(root, "val"), batch_size=batch_size, shuffle=False)
    val_loss, val_acc, _ = evaluate(model, va_loader)
    assert math.isclose(val_loss, best["val_loss"], abs_tol=tol), (val_loss, best["val_loss"])
    return model, best["epoch"], val_loss, val_acc

print(select_best("runs/cnn_s20261021")[1:])
A labor futása után a runs/cnn_s20261021 könyvtáron a
függvény a 15. epochot és a
-as
validációs losst adja vissza. A tűrés
:
a mentett érték ugyanabból a determinisztikus előreszámításból
származik, és a validációs halmazt ugyanazzal a batch-felosztással
építjük fel, ezért a gyakorlatban az eltérés nulla; a tűrés más verziójú
könyvtárak összegzési sorrendjére hagy helyet. A teszt lényegi része nem
az assert, hanem a reprodukált val_loss érték
és az, hogy a checkpoint epoch mezője a napló legjobb
sorára mutat.
A hiba oka: a best.pt mentési feltétele az utolsó
epochhoz kötött, nem a legjobb validációs értékhez. Következmény: a fájl
a
.
epoch állapotát tartalmazza, miközben a napló szerint a 15. epoch
vesztesége kisebb; a záróteszt a túlillesztettebb utolsó modellt kapná.
Javítás (a labor szkriptjének mintájára):
if va_loss < best["val_loss"]:
    best = {"epoch": epoch + 1, "val_loss": va_loss}
    torch.save({"model_state_dict": model.state_dict(), "arch": arch, "seed": seed,
                "epoch": epoch + 1, "val_loss": va_loss},
               os.path.join(run_dir, "best.pt"))
Ellenőrzés: a javított futás summary.json
best_epoch értéke megegyezik a metrics.jsonl
legkisebb val_loss sorával és a checkpoint
epoch mezőjével, és a betöltött best.pt
validációs lossát a best_val_loss értékkel
tűrésen belül reprodukáljuk. Ha a tűrés nem teljesül, akkor a mentés nem
a kiértékelt állapothoz tartozik.
A protokoll a jelen egységben nem hajtja végre a receptkeresést, mert
a 38.1. Adat, split és előzetes protokoll a
befagyasztott receptet rögzíti; a következő terv tehát transzferfeladat.
Megfigyelési egység: scene_id; a train/val/test felosztás
változatlan. A két architektúra (A: a fenti 8–16 csatornás lánc, B:
16–32 csatornás változat) mindegyikét három seeddel, külön
runs/<arch>_s<seed> naplóban tanítjuk. Döntési
metrika: az utolsó tíz epoch snapshotjainak validációs lossa seedenként,
azaz összesen
snapshot architektúránként; a kiválasztott modell az az
architektúra–seed–snapshot hármas, amelynek a legkisebb a validációs
lossa. A baseline az uniform prior-osztályozó. A tesztet csak a
választás után, egyetlen alkalommal értékeljük. Korlát: mivel a
validációt modellválasztásra is használtuk, a nyertes modell
tesztmetrikája optimista lehet a valódi kockázathoz képest; a [S02]
szerint az intervallumok feltételes, ismételt mintavételi értelmezésűek,
és a választási lépést mint az eljárás részét kell kezelni, nem mint
előre ismert modellt.
Tipikus tévedés. „Az utolsó epoch a legjobban tanult
modell.” Ellenpélda a fenti mért cnn_s20261021 futás: az
utolsó epoch val_loss=0.373, a legjobb 15. epoch
val_loss=0.368. Ha a train loss az epochok végén
,
az csak a train halmazhoz való illeszkedést mutatja; a validációs görbe
emelkedése éppen a túlillesztés jele. A zárótesztet ezért a best
snapshoton kell futtatni, nem az utolsó epoch állapotán. A tévedés
következménye a clean testen is mérhető romlás, a corrupt teszten pedig
jellemzően nagyobb érzékenységnövekedés lehet, mert a túlillesztett
döntési határ a zajra és a fényességgradiensre is érzékenyebb.
Önellenőrzés.
best.pt betöltéséhez miért kell újraépíteni az
architektúrát, és melyik modul adja az egyetlen modelldefiníciót?Visszahívás. A 37.2. Backward és
ellenőrzési lefedettség gradiensellenőrzése biztosítja, hogy a
Conv2d tanulási jele a levezetett backwarddal egyezik; a jelen egység
ezt az operátort már nem ellenőrzi újra, hanem feltételezi. A 34.2. Kvantálás és hibatovábbterjedés
figyelmeztetett, hogy a kisebb bitszélességű reprezentáció további hibát
vinne be; a mostani labor ezért float32 marad. A 26.2. Egy- és kétlépcsős detektor
detektor-felelősségmegosztása azt hangsúlyozta, hogy az osztályozó logit
nem dobozregresszió: a GlyphLab xmin, ymin, xmax, ymax
oszlopait ebben a kísérletben nem használjuk, azok a
szegmentálós/lokalizációs projekt annotációi.
A 38.2. Modell, training és best checkpoint
egység a befagyasztott GlyphLab-protokoll tanítási szakaszát valósította
meg. Definiáltuk a kis CNN-t, a lineáris baseline-t és a prior
minimum-referenciát, a Kaiming-inicializálást, a koszinuszos
tanulásiráta-ütemezést, a snapshotot és a validation-alapú best-snapshot
választást. Levezettük a paraméterszámot és a rétegenkénti alakokat,
valamint a mean-redukált cross-entropy gradiensét, amely softmax mínusz
one-hot alakú. A labor egyetlen paranccsal mindkét modellt mindhárom
seeddel tanítja, ellenőrzi a paraméterszámot, futásonként JSON-naplót és
visszatöltéssel ellenőrzött best.pt checkpointot ír, majd a
protokoll választási szabálya szerint előállítja a 38.3. Végső teszt és páros korrupció bemenetét; a
közölt napló mért futásból származik. A következő egység a befagyasztott
modell végső tesztjét és a páros corrupt kiértékelést készíti elő.
state_dict,
eval és weights_only
checkpointkezeléshez.