Ez az alfejezet a Vision Transformer (ViT) képfeldolgozási szerződését építi fel: miként lesz egy képtensorból tokensorozat, milyen induktív feltevéseket épít be a modell, és miben tér el a CNN lokális feltevésétől. Előismeret a 32.2. Scaled dot-product attention attention-definíciója (Q/K/V, softmax, skálázás, multi-head, pozíciókódolás), valamint a 13.2.–16.1. konvolúciós és ekvivariancia-fogalmai rövid visszahívással. Induló becslés: egy méretű GlyphLab-kép patchekkel hány tokent ad, és hány paramétere van egy dimenziós patch-beágyazásnak? A fejezet végére ennek pontos, alakellenőrzött válaszát és az ekvivalens konvolúciós megvalósítást is megadjuk.
Definíció (patch embedding). Legyen egy képbatch. Rögzített patch-mérethez tegyük fel, hogy és . Ekkor a térbeli rács:
Az patchvektor a
elemek rögzített sorrendű felsorolása. A teljes patch-mátrix . A beágyazás egy súlyú, torzítású affin leképezés:
ahol az és dimenziók mentén broadcastolódik. A ViT-ben ehhez a sorozathoz egy tanulható osztálytokent és egy pozícióbeágyazást adnak, így a bemenő tokensorozat .
Lemma (a patch embedding mint nem átfedő
konvolúció). Legyen
,
,
tetszőleges. A fenti affin patch-beágyazás pontosan ugyanazt a
kimenetet adja, mint egy
Conv2d(C, D, kernel_size=(P_h,P_w), stride=(P_h,P_w), padding=0)
réteg, amelynek kimenetét
alakról
-re
lapítjuk, majd
-re
permutáljuk — feltéve, hogy a konvolúciós súly
és a lineáris súly
azonos indexsorrendben tartalmazza ugyanazokat a skalárokat.
Bizonyítás. Írjuk ki a konvolúció kimenetét egy rögzített pozícióra, ahol a kimeneti csatorna, a -as térbeli rács koordinátája. Mivel , , , és , a 14.1. Stride, padding, dilation és outputméret alakképlete szerint a kimeneti rács éppen , és a bemeneti ablak az patch:
Az összeg ugyanaz a skalár szorzatösszege, mint a kifejezés, ha . Mivel az ablakok nem fednek át, más patch nem szól bele az adott tokenbe. A két kimenet elemenként egyenlő.
Költség-összehasonlítás. A lemma két fontos következményt rögzít:
Ha a stride kisebb a kernelnél, a tokenek száma és a recepciós mezők átfedése nő. Nem átfedő, esetén érdekes állandóság lép fel: , ezért a beágyazás teljes MAC-száma , független a patch-mérettől — csak a tokenek száma és az attention későbbi költsége változik. Átfedő ablaknál ( vagy ) a képnkénti MAC az ablakméret és a tokenszám szorzataként nő.
A ViT egy tiszta transzformer-encoder képklasszifikációra [P22]. Blokkonként, bemenetre a pre-norm reziduális szerkezet:
Az a 32.2. Scaled dot-product attention alfejezetben definiált többfejű scaled dot-product attention: , , mind alakú, a figyelmi mátrix , a kimenet pedig konvex kombinációja. Az MLP két lineáris vetítésből és GELU-aktivációból áll, közbülső szélességgel; a pontos az eredeti publikáció hiperparamétere. A végső osztályozás a CLS-token kimenetén egy fejjel számol logitot: .
A laborméretű példában , , egyetlen blokk paraméterszáma: QKV-vetítés , kimeneti vetítés , MLP , két LayerNorm ; összesen mintegy ezer paraméter. Ez csak a blokk; a teljes hálóhoz a beágyazás (), a CLS- és pozícióbeágyazás () is hozzáadódik.
Az inductive bias a modellcsaládba beépített, adattól független szerkezeti feltevés, amely leszűkíti a reprezentálható függvények halmazát. Két szinten érdemes elkülöníteni:
Ebből következik a szakirodalom absztraktszintű állítása [P22]: a ViT kevesebb kép-specifikus induktív feltevést épít be, ezért nagy előtanító adat és számítás mellett a tanulás jó eredményt érhet el, Kis adaton viszont a CNN beépített lokalitása gyakran előnyösebb. Fontos: ez a szerzők absztraktjában megfogalmazott empirikus állítás, nem a jelen könyvben bizonyított tétel, és konkrét benchmarkszámot itt nem idézünk.
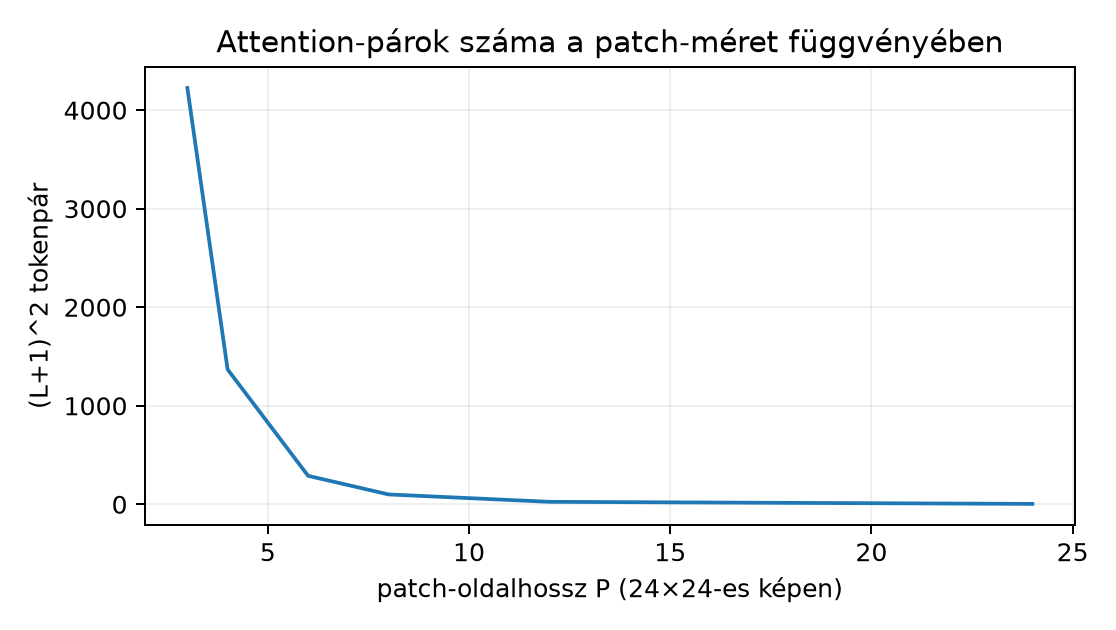
A két család számítási profilja eltérően skálázódik. Egy hagyományos konvolúciós réteg költsége a pixelek számában lineáris marad: . A ViT attention-része tokenpárokat számol, tehát művelet blokkonként, ami a patch-méret csökkenésével négyzetesen nő. A -es példán:
Az így számított skálázást szemlélteti az alábbi diagram (képletből számolt értékek, nem mért futás):
Vegyük észre a fenti lemma következményét: a beágyazás teljes költsége mellett független a patch-mérettől, tehát a patch-méret csökkentése elsősorban az attention-költséget növeli, nem a tokenizációt. A patch-méret ezért számítási döntés, nem pusztán felbontási kérdés.
A hibrid modell a két induktív feltevés kompozíciója: egy CNN gerinc először lokális jellemzőtérképet állít elő, majd ennek térbeli cellái lesznek a transzformer tokenjei. Formálisan , a tokenek darab dimenziós vektor, amelyeket egy vetítés képez dimenzióba:
A GlyphLab-példán: egy -as, stride 2, padding 1 konvolúció csatornával -es térképet ad; egy második csatornával -ot; ez token, szemben a nyers kép patchelésének tokenjével. A hibrid tehát sűrűbb, már feldolgozott tokeneket ad, és a kezdeti lokális szűrők megtartják a CNN kedvező kisadatos viselkedésének egy részét. A globális kontextus másik útját a 31.3. Diffúziós zajmodell és CNN-denoiser U-Net-mély encoderében láttuk; az attention itt ezt a globális keverést minden blokkban közvetlenül elvégzi.
Nagy előtanított ViT-ek felhasználása a 20.3. Preprocessing, domain shift és súlylicenc alfejezetben rögzített szerződést örökli: a súlycsomag enumja azonosítja a pontos változatot, a licenc a felhasználási feltételt, a preprocessing-szerződés pedig a bemeneti elvárást. Egy külső ViT általában rögzített felbontásra, RGB-csatornaszámra és normalizálásra van előtanítva; a egycsatornás GlyphLab-kép közvetlen betáplálása domain shiftet jelent, és a teljesítményre semmilyen garancia nem vonatkozik automatikusan. A 28.3. Retrieval-értékelés és adatfelosztás alfejezetből ismert globális embedding-használathoz hasonlóan a CLS-token kimenete egy globális képdeszkriptor, de ennek minősége az előtanítási eloszláshoz kötött. Ebben a laborban külső súlyt nem töltünk be; a foundation-use csak szerződésszintű előkészítés.
A labor célja nem modellverseny, hanem egy alak- és költségalapú
döntési lap: ugyanarra a determinisztikus,
-beli
float32 NCHW képre felépítjük a konvolúciós és a lineáris
patch-beágyazást, ellenőrizzük az ekvivalenciát, majd kiszámítjuk a
token-, paraméter- és attention-alakokat. A kimenet itt kézzel számított
várt referencia, nem rögzített mért futás — a kódot a
hallgató futtatja le, és a max |diff| értéket neki kell
ellenőriznie.
# munkakönyvtár: lab/n127_decision/
import torch

torch.manual_seed(20261020)          # véletlen súlyok reprodukálhatóságához
dtype = torch.float32
device = torch.device("cpu")

N, C, H, W, D, P = 1, 1, 24, 24, 32, 8
x = torch.arange(H * W, dtype=dtype, device=device).view(N, C, H, W) / (H * W - 1)

# 1) konvolúciós beágyazás: k=P, s=P, p=0
conv = torch.nn.Conv2d(C, D, kernel_size=P, stride=P, padding=0,
                       bias=True, device=device, dtype=dtype)

# 2) ekvivalens lineáris patch-beágyazás: a konvolúciós súly átrendezésével
lin = torch.nn.Linear(C * P * P, D, bias=True, device=device, dtype=dtype)
with torch.no_grad():
    lin.weight.copy_(conv.weight.reshape(D, C * P * P))
    lin.bias.copy_(conv.bias)

patches = x.unfold(2, P, P).unfold(3, P, P)      # (N, C, 3, 3, P, P)
patches = patches.permute(0, 2, 3, 1, 4, 5).reshape(N, -1, C * P * P)  # (N,9,64)

z_conv = conv(x).flatten(2).transpose(1, 2)       # (N,9,D)
z_lin = lin(patches)                               # (N,9,D)
diff = (z_conv - z_lin).abs().max().item()

print("konv súly:", tuple(conv.weight.shape), "bias:", tuple(conv.bias.shape))
print("linear súly:", tuple(lin.weight.shape), "bias:", tuple(lin.bias.shape))
print("tokenek:", z_conv.shape[-2], "D:", z_conv.shape[-1])
print("paraméterek konv/linear:",
      sum(p.numel() for p in conv.parameters()),
      "/", sum(p.numel() for p in lin.parameters()))
print("max |z_conv - z_lin|:", diff)

cls = torch.zeros((N, 1, D), dtype=dtype, device=device)
z = torch.cat([cls, z_lin], dim=1)                 # (N, 10, D)
qkv = torch.nn.Linear(D, 3 * D, bias=False, device=device, dtype=dtype)
q, k, v = qkv(z).chunk(3, dim=-1)                  # (N,10,D) mind
attn = (q @ k.transpose(1, 2)) * (D ** -0.5)       # (N,10,10)
print("attention-párok:", attn.shape[-1] * attn.shape[-2],
      "alak:", tuple(attn.shape))
Várt, képletekből számolt kimenet: konvolúciós súly
,
lineáris súly
;
tokenek száma
,
;
paraméterszám mindkét oldalon
;
a lemma szerint max |z_conv - z_lin| konstrukcióból
várható, float32 kerekítés miatt
alatt fogadjuk el. Az attention-párok száma
,
alak
.
A futtatás parancsa a lab/n127_decision/ könyvtárból:
python decision_patch_conv.py.
A döntési lap tényrögzítő táblája:
| Sor | CNN-beágyazás | ViT patch-beágyazás |
|---|---|---|
| Tokenek () | ||
| Paraméterek () | ||
| Tokenenkénti recepció | ||
| Rétegek közti interakció | lokális, mélységgel nő | attention, globális páronként |
| Beépített geometria | eltolási ekvivariancia | tanulandó pozíciókód |
A táblázat szándékosan nem tartalmaz minőségi rangsort: ilyen állításhoz adat, modellméret, tréningrecept és kiértékelési protokoll kell, amelyet itt nem tételezünk fel.
F1 — fogalmi (nehézség 1, előfeltétel: 32.2. Scaled dot-product attention, 16.1. Eltolási equivariance és invariance). Definiálja az inductive bias fogalmát, adjon egy-egy konkrét példát a CNN-re és a ViT-re, és magyarázza el, miért mondjuk, hogy a ViT kevesebb kép-specifikus induktív feltevést épít be. Átadandó: 200–400 szavas saját magyarázat, benne az eltolási ekvivariancia és a tokenpermutáció-szimmetria megkülönböztetése, valamint egy mondatban az adatmennyiségtől való várható függés.
F2 — levezetési (nehézség 2, előfeltétel: 14.1. Stride, padding, dilation és outputméret, 14.3. Paraméterszám, MAC és aktivációmemória). Egy -es, egycsatornás képre (, ) számolja ki (a) a , patch-beágyazás és (b) a , , , konvolúciós beágyazás tokenszámát, paraméterszámát és képenkénti MAC-számát. Mutassa meg, melyik paraméterválasztás mellett lenne a konvolúció pontosan ekvivalens a patch-beágyazással, és indokolja a lemma feltételeiből. Átadandó: minden közbülső számítás, a 14.1. Stride, padding, dilation és outputméret alakképletének explicit alkalmazása és alakellenőrzés.
F3 — implementációs (nehézség 2, előfeltétel: 11.1.–11.2.). Írjon teljes,
futtatható PyTorch-szkriptet, amely egy
méretű, determinisztikus arange-alapú float32 bemeneten
ellenőrzi a lemma állítását
,
mellett: a Conv2d(kernel_size=8, stride=8, padding=0) és az
ekvivalens Linear kimenetének maximális abszolút eltérését
toleranciával kontrollálja. A súlyátvitelt a laborban látott módon
végezze. Átadandó: teljes kód, seed, dtype, device, a szélsőeset
()
token- és alakeseménye, valamint a tolerancia indoklása.
F4 — hibakeresési (nehézség 2, előfeltétel: 13.1. Kép mint diszkrét többcsatornás jel, 32.3. Vision Transformer és hibrid felhasználás). Az alábbi töredék RGB-képen akar patch-tokeneket létrehozni, de a kimenet alakja lett a várt helyett. Lokalizálja a hibát, írja le a következményét az attention-bemenetre, javítsa a kódot, és adja meg a javítás utáni ellenőrző alakot:
x = torch.randn(1, 3, 24, 24)          # NCHW
pat = x.unfold(2, 8, 8).unfold(3, 8, 8) # (1,3,3,3,8,8)
tok = pat.reshape(1, -1, 8 * 8)         # (1,27,64) -- hibás
Átadandó: az ok, a szemantikai következmény (csatornák külön tokenként), a javított kód és a javítás utáni alak.
F5 — kísérleti/transzfer (nehézség 3, előfeltétel: 1.3. Adatfelosztás és a megfigyelési egység, 22.4. Augmentációs kísérlet és domainváltozás, 23.3. Páros összehasonlítás és csoportszintű intervallum). Tervezzen kis CPU-s kísérletet a GlyphLab adathalmazon egy rögzített kis CNN és egy azonos paraméterkeretű hibrid CNN–ViT összehasonlítására. A terv kötelező elemei: megfigyelési egység (scene_id), splitbetartás, baseline, egyetlen változó tényező, azonos tréningrecept, val-alapú checkpoint-választás, pontosság és jelenet-alapú bootstrap-CI, valamint a korrupt teszt csak a modellválasztás utáni használata. Tüntesse fel, mit nem állítunk a kísérletből. Átadandó: 1–2 oldalas protokollterv, keresési és erőforráskerettel, előre megjelölt nyertes nélkül.
F1. Az inductive bias a tanuló modellcsalád szerkezetébe épített feltételezés, amely adat nélkül is leszűkíti a reprezentálható függvények körét. A CNN példája: a súlymegosztott kis kernel miatt a háló már definíció szerint eltolási-ekvivariáns, tehát egy -as minta felismerését nem kell minden pozícióban külön megtanulni. A ViT példája: pozíciókód nélkül a tokenek sorrendjére nézve ekvivariáns, tehát a térbeli viszonyok ismerete nincs beépítve; abszolút pozíciókóddal a modellnek ezt adatból kell megtanulnia. Kevés adaton a CNN erős feltevése csökkenti a varianciát, míg a ViT gyengébb feltevése több adatot igényelhet, cserébe rugalmasabban tanulhat globális összefüggéseket.
F2. (a) A , kép patchre bomlik, token. A beágyazási bemenet , a kimenet ; paraméterszám ; MAC képenként. (b) A 14.1. Stride, padding, dilation és outputméret képletével , tehát token. Paraméterszám , azonos (a)-val, mert az ablakméretek is skalárt fednek. MAC képenként , ami -szorosa (a)-nak az átfedő ablakok miatt. A lemma feltétele szerint és , mellett lenne ekvivalens a két beágyazás, tehát (b) csak választással egyezne meg (a)-val.
F3. A szkript vázlata a laborkód -ra módosított változata; a kimeneti kontroll: tokenek (), a lineáris súly , a konvolúciós súly , paraméterszám mindkét oldalon. Szélsőeset : , tehát egyetlen token az egész kép, és az attention-párok száma CLS-sel . A tolerancia bőven a float32 kerekítési hibája fölött van, de kiszűri a hibás indexsorrendet; a konstrukcióból adódó eltérés vagy nagyságrendű.
F4. A hiba a reshape előtti
permute hiánya. Az unfold kimenete
sorrendű, ezért a közvetlen reshape(N,-1,P*P) a csatornákat
külön tokenként kezeli:
token jön létre
dimenzióval, és egy-egy patch csatornái szétválnak. Következmény: az
attention háromszor annyi, csatornafosztott tokenen fut, a per-token
recepciós mező egycsatornás
lesz, és a modell nem látja a színes patch teljes
skalárját együtt. Javítás:
tok = pat.permute(0, 2, 3, 1, 4, 5).reshape(1, 9, 192). Az
ellenőrző alak
.
F5. A terv gerince: adat = GlyphLab
images.npy/metadata.csv, train/val/test a
jelenetalapú split szerint, a validáció és a CI egysége mindenütt
scene_id. A vizsgált tényező kizárólag a modellcsalád: (A)
kis CNN (például két konvolúciós blokk, azonos beágyazási
paraméterszámmal), (B) hibrid CNN–ViT (a CNN utolsó térképe
tokenre lapítva, egy attention-blokk). Rögzített tényezők: seedek,
batch, epoch, optimizáló, augmentáció, célmetrika (pontosság),
input, CPU. A modellválasztás val-veszteség szerint történik, a teszt és
a korrupt teszt csak utána kerül kiértékelésre; a bizonytalanságot
jelenet-alapú bootstrap-CI-vel adjuk meg. Nem állítjuk: természetes képi
általánosítást, a modellcsaládok általános fölényét, GPU- vagy
nagyadatos viselkedést; ez egy kontrollált, kis méretű adaptációs
megfigyelés.
A leggyakoribb hiba azt állítani, hogy „a ViT jobb a CNN-nél” vagy fordítva. Az állítás helyes formája mindig feltételes: melyik adat-, méret- és receptosztályon, milyen metrikával. Ellenpélda-pár a modellcsalád-fölény ellen: (i) ha a valódi címkefüggvény tisztán lokális, például a label csak a kép -as középső sávjának átlagától függ, egy kis CNN már a beépített lokalitással ezt meg tudja tanulni, míg a ViT-nek ugyanehhez előbb ki kell tanulnia, hogy a távoli tokenpárok irrelevánsak; (ii) ha a label két távoli pixel szorzatától függ, egyetlen attention-réteg közvetlenül képes a két pozíciót összekötni, míg egy sekély, kis kernelű CNN recepciós mezője ezt nem fedi. Ez a két konstrukció heurisztikus ellenpélda, nem formális lehetetlenségi tétel: elég mély CNN vagy elegendő adat mindkét esetben változtathat a képen. A tanulság: a fölény adat-, méret- és receptfüggő, és csak rögzített protokollú méréssel állítható — mint [P22] absztraktjában is, nagy előtanítás feltételéhez kötve.
A patch embedding az képet tokensorozatra vetíti; osztható méretnél ez pontosan egy , , konvolúcióval azonos lineáris leképezés, azonos paraméter- és MAC-számmal. A ViT ehhez CLS-tokent és tanulható pozíciókódot ad, majd pre-norm attention-blokkokat alkalmaz, amelyek globális tokenpár-interakciót számolnak. A CNN lokális, eltolás-ekvivariáns feltevést épít be; a ViT kevesebb kép-specifikus feltevéssel, adatból tanulja a geometriát. Hogy melyik család vezet, az adattól, mérettől és tréningrecepttől függ; a labor ezért csak alakeseményeket és költségeket rögzítő döntési lapot ad. A hibrid CNN–ViT a két feltevést kompozícióként egyesíti.
A következő egység, 32.4. VIII. ellenőrző pont: célhoz illő neurális modell, a VIII. ellenőrző pont: a CNN, a hibrid ViT és más modellcsaládok közötti választást a feladathoz, adathoz, mérethez és szerződéshez kell kötni; a jelen alfejezet alak-, költség- és induktívfeltevés-lapja ehhez ad döntési nyelvet.
Felhasznált források: