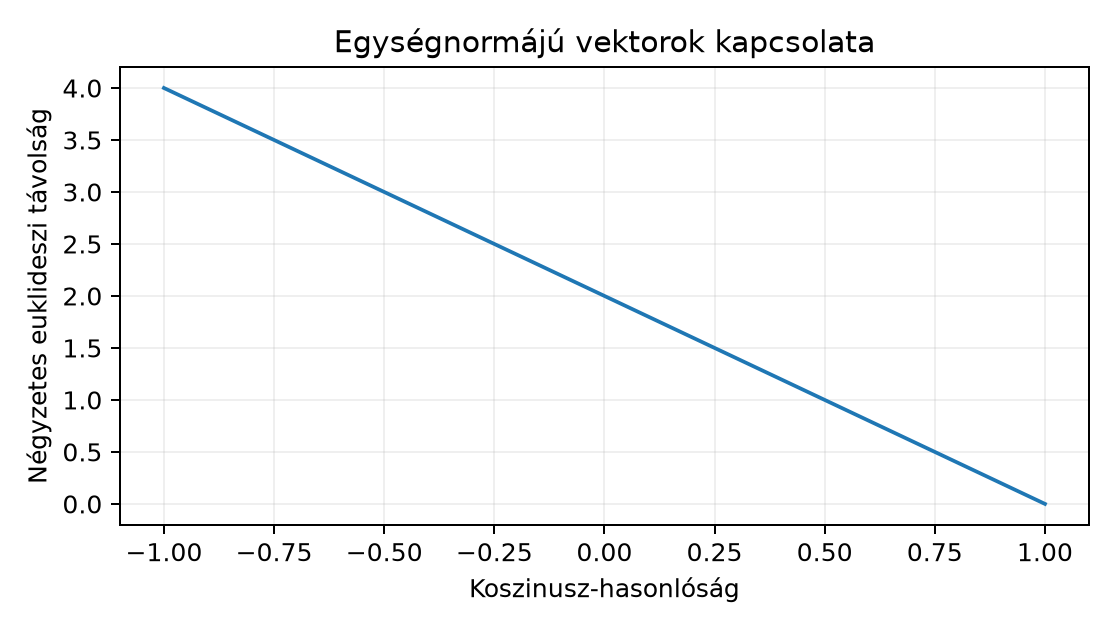
Ebben az alfejezetben az osztályozástól eltérő kimenetet építünk: a CNN egy képet rögzített méretű vektorba, embeddingbe képez, amelyben a hasonlóságot távolsággal vagy koszinusz-hasonlósággal mérjük. A 25.4. Nyílt halmaz és ismeretlen input alfejezetben láttuk, hogy a softmax-konfidencia nem hasonlósági mérték; itt a hasonlósági kereséshez tervezett reprezentáció skáláját definiáljuk. Felhasználjuk a norma és skalárszorzat alapjait, valamint a 3.4. Sajátérték, SVD és spektrális határ alfejezetben tárgyalt normakorlát gondolatát: a háló lineáris rétegei tetszőlegesen megnyújthatják a vektorokat, ezért a nyers kimenet normája önmagában nem megbízható hasonlósági jel.
Induló kérdés. A GlyphLab két nézete ugyanarról a
scene_id-ről készül, de különböző zajt kap. Pixelben mérve
két ilyen nézet távol lehet; egy tanult features kimenetben
viszont közel kellene lenniük. Milyen normalizálás mellett lesz a
koszinusz-hasonlóság és az euklideszi távolság egymásnak monoton
megfelelője, és miért nem automatikus ez a nyers hálókimenetre?
Definíció (feature extractor és embedding). Legyen a bemeneti tér (NCHW képbatch), és legyen egy paraméterezett leképezés, például az osztályozó fej előtti CNN-rész. A feature extraction folyamatának kimenete az
soronkénti embedding. Az absztrakt képletekben egy vektor
oszlopvektor; a batchelt Z mátrixban egy megfigyelés egy
sor. A d a választott reprezentációs dimenzió, nem az
osztályok száma. A logit is vektor, de a logit osztályozásra
optimalizált pontszám; az embeddinget hasonlósági célra tanítjuk, és a
kettőt nem cseréljük fel automatikusan.
Definíció (L2-normalizálás). A vektor L2-normalizáltja
A leképezés az egységgömbre, vetíti a vektort. A nulla vektorra nincs definiálva; a gyakorlatban a háló kimenete ritkán pontosan nulla, de a kódnak explicit módon kell kezelnie. A normalizálás nem lineáris: pozitív skalárszorosok ugyanarra a pontra kerülnek, ezért a kimeneti skálát tudatosan eltávolítjuk.
Definíció (koszinusz-hasonlóság). Két nemnulla vektorra
A tartomány a Cauchy–Schwarz-egyenlőtlenségből következik. Ha és egységnormájú, akkor . A koszinusz-hasonlósághoz tartozó koszinusz-distance ; ez [0,2] értékű, de nem metrika, ahogy az F1 ellenpéldában megmutatjuk.
Definíció (euklideszi távolság).
A négyzetes alakot a levezetésekben gyakran egyszerűbb használni, mert eltűnik a gyök.
Mátrixos alak. Batchelt embeddingre ; a soronkénti L2-normalizálás . Ha a mátrix már soronként egységnormájú, akkor a koszinusz-hasonlósági mátrix , ahol .
A 3.4. Sajátérték, SVD és spektrális határ spektrális normája éppen a legnagyobb iránymenti nyújtás. A nyers kimenetben két kép hasonlóságát nemcsak az irány, hanem a rétegek által megtanult, képfüggő norma is befolyásolja; a normalizálás ezt a skálát egységesíti.
A hasonlósági keresés leggyakoribb művelete két mértéket cserélget: koszinusz-hasonlóságot és euklideszi távolságot. A csere egységnormájú vektorokra levezethető azonosság, ezért fontos, hogy pontosan kimondjuk.
Tétel 1 (n109.1). Legyen , és tegyük fel, hogy . Ekkor
Ekvivalensen .
Bizonyítás (saját, közvetlen levezetés).
A skalárszorzat szimmetriája miatt , a feltétel miatt pedig és . Így
Egységnormájú vektorokra a koszinusz-hasonlóság definíció szerint , tehát , ami a bizonyítandó állítás.
A tétel geometriai jelentése: az egységgömbön a húr hosszának négyzete és az érintett szög koszinusza között a fenti lineáris kapcsolat áll. A tételből következik a gyakorlatban használt rendezési ekvivalencia:
Következmény 2. Ha minden vektor egységnormájú, akkor a koszinusz-hasonlóság szerinti csökkenő rendezés azonos a négyzetes euklideszi távolság szerinti növekvő rendezéssel, mert a leképezés szigorúan monoton csökkenő -en.
A következmény csak a normalizált esetre érvényes. Nyers vektorokon a két rendezés eltérhet, mert a normák beleszólnak a távolságba. A szakasz végén erre ellenpéldát adunk.
Legyen a lekérdezés , és két adatbázisvektor , .
Nyers vektorokon az euklideszi távolságok:
tehát közelebb van. A koszinusz-hasonlóságok:
tehát hasonlóbb. A rendezés eltér. Normalizáljuk mindkét vektort: , , . A Tétel 1 szerint a négyzetes távolságok:
így a normalizált térben a közelebbi is, és a rendezés összhangba kerül a koszinusszal. A norma eltávolítása tehát nem kozmetikai lépés: a hasonlósági keresés szerződését teszi egyértelművé.
Minimális NumPy-kód ugyanerre:
import numpy as np

q = np.array([1.0, 0.0], dtype=np.float32)
a = np.array([2.0, 0.0], dtype=np.float32)
b = np.array([1.5, 0.5], dtype=np.float32)

def cos(u, v):
    return float(np.dot(u, v) / (np.linalg.norm(u) * np.linalg.norm(v)))

for z in (a, b):
    z_hat = z / np.linalg.norm(z)
    print(cos(q, z), np.linalg.norm(q - z_hat).item() ** 2)
# Várt (számított kontroll, nem futtatott kimenet):
# 1.0 / 0.0
# 0.94868326 / 0.10263340
A második sorban a Tétel 1-ből számolt érték a normalizált négyzetes távolság.
Cél. Kis, CPU-s exact nearest-neighbor kereső, amely a hasonlósági műveletet nem rejti könyvtári metrikafüggvény mögé. Az adatbázis mérete , a dimenzió ; a naiv keresés költsége , ami a GlyphLab méretén triviális.
Input. lab/embedding_exact.py; a
CNN-úthoz a korábbi főútból származó saját checkpoint és a GlyphLab
data/images.npy. A kézi ellenőrzés checkpoint nélkül is
fut. Minden tenzorművelet float32, device CPU; seedet a
determinisztikus kézi ág nem igényel.
A teljes szkript:
# lab/embedding_exact.py
from __future__ import annotations

import argparse
from pathlib import Path
import numpy as np


def l2_normalize(Z: np.ndarray, *, eps: float = 0.0) -> np.ndarray:
    """Sor-irányú L2-normalizálás. Z: (N,d) float32."""
    Z = np.asarray(Z, dtype=np.float32)
    if Z.ndim != 2:
        raise ValueError(f"shape must be (N,d), got {Z.shape}")
    norm = np.linalg.norm(Z, axis=1, keepdims=True)
    if np.any(norm <= eps):
        bad = int(np.argwhere(norm <= eps)[0, 0])
        raise ValueError(f"zero or non-positive norm at row {bad}")
    return Z / norm


def neighbors_cosine(query: np.ndarray, database: np.ndarray, k: int = 1):
    """Pontos k-legközelebbi szomszéd koszinusz-hasonlóság szerint.

    query: (d,) vagy (1,d); database: (N,d).
    Visszaadja a legmagasabb hasonlóságú sorok indexét és pontszámát.
    """
    query = np.asarray(query, dtype=np.float32).reshape(1, -1)
    database = np.asarray(database, dtype=np.float32)
    if query.shape[1] != database.shape[1]:
        raise ValueError("dimension mismatch")
    q = l2_normalize(query)
    db = l2_normalize(database)
    if k > db.shape[0]:
        raise ValueError(f"k={k} > database size {db.shape[0]}")
    sim = (db @ q.T)[:, 0]
    order = np.argsort(-sim, kind="stable")
    idx = order[:k].astype(np.int64)
    return idx, sim[idx].astype(np.float32)


def manual_check() -> None:
    db = np.array([[3.0, 0.0], [0.0, 2.0], [2.0, 2.0]], dtype=np.float32)
    q = np.array([1.0, 0.0], dtype=np.float32)
    idx, sim = neighbors_cosine(q, db, k=3)

    # Kézi kontroll: normalizálva db = [[1,0],[0,1],[1,1]/sqrt2],
    # q = [1,0], így sim = [1, 0, 1/sqrt2].
    expected_idx = np.array([0, 2, 1], dtype=np.int64)
    expected_sim = np.array([1.0, 0.70710677, 0.0], dtype=np.float32)
    assert np.array_equal(idx, expected_idx), f"index mismatch: {idx}"
    assert expected_idx.shape == idx.shape == (3,)
    assert np.allclose(sim, expected_sim, rtol=1e-5, atol=1e-5), sim
    print("[manual] idx =", idx)
    print("[manual] sim =", sim)


def load_db(path: Path) -> np.ndarray:
    data = np.load(path)
    if "Z" not in data:
        raise KeyError("npz must contain 'Z' with shape (N,d)")
    return np.asarray(data["Z"], dtype=np.float32)


def main(argv=None) -> None:
    p = argparse.ArgumentParser(description="n109 exact cosine search")
    p.add_argument("--manual", action="store_true")
    p.add_argument("--db", type=Path, default=None)
    p.add_argument("--query", type=Path, default=None)
    p.add_argument("--query-index", type=int, default=0)
    p.add_argument("--top-k", type=int, default=5)
    args = p.parse_args(argv)

    if args.manual and args.db is None:
        manual_check()
        return
    if args.db is None or args.query is None:
        p.error("--db and --query are required, or use --manual")

    database = load_db(args.db)
    query_stack = load_db(args.query)
    q = query_stack[args.query_index]
    idx, sim = neighbors_cosine(q, database, k=args.top_k)
    print("query_index =", args.query_index)
    print("top_indices =", idx)
    print("top_sim      =", sim)
    assert np.all(sim >= -1.0 - 1e-6) and np.all(sim <= 1.0 + 1e-6)
    assert np.all(np.diff(sim) <= 0.0), "sim must be non-increasing"


if __name__ == "__main__":
    main()
A CNN-úthoz a saját checkpoint feltöltése a korábbi főút
architektúraosztályát igényli. A lényegi szerződés:
model.features(x) adjon (N,d) embeddinget,
vagy adjon (N,C,H,W) feature mapot, amelyet global average
pooling követ.
# lab/extract_embeddings.py -- a saját főút-modellhez illesztendő váz
import numpy as np
import torch
from pathlib import Path

def extract(checkpoint: Path, images: Path, out: Path, d: int = 32) -> None:
    # A GlyphCNN osztályt a saját képzési modulból importáld be!
    from cnn_project import GlyphCNN  # helyi projektimport, nem könyvtári komponens
    state = torch.load(checkpoint, map_location="cpu", weights_only=True)
    model = GlyphCNN()
    model.load_state_dict(state["model_state_dict"])
    model.eval()
    X = np.load(images)  # (N,1,24,24) float32
    X = torch.from_numpy(X.astype(np.float32))
    with torch.inference_mode():
        Z = model.features(X)
    if Z.ndim == 4:  # feature map: (N,C,H,W) -> global average pooling
        Z = Z.mean(dim=(2, 3))
    Z = Z.numpy()
    if Z.shape[1] != d:
        raise ValueError(f"feature dim mismatch: {Z.shape[1]} != {d}")
    np.savez(out, Z=Z.astype(np.float32), index=np.arange(len(Z)))

if __name__ == "__main__":
    import argparse
    ap = argparse.ArgumentParser()
    ap.add_argument("--checkpoint", type=Path, required=True)
    ap.add_argument("--images", type=Path, required=True)
    ap.add_argument("--out", type=Path, required=True)
    ap.add_argument("--dim", type=int, default=32)
    a = ap.parse_args()
    extract(a.checkpoint, a.images, a.out, a.dim)
Futtatási parancsok.
cd lab
python embedding_exact.py --manual
# A saját checkpoint esetén először:
python extract_embeddings.py --checkpoint glyph_cnn.pt \
  --images ../data/images.npy --out test_embeddings.npz --dim 32
# Ezután egy query (önkereséses indexelési kontroll):
python embedding_exact.py --db test_embeddings.npz \
  --query test_embeddings.npz --query-index 0 --top-k 5
A --manual ág számított várt kimenete,
nem e kérésben végrehajtott futás:
[manual] idx = [0 2 1]
[manual] sim = [1.         0.70710677 0.       ]
Ellenőrzés és értelmezés. Az utolsó parancsban a query is az adatbázisban van, ezért a 0. találat jó esetben maga a query; ez csak az indexelés helyességét ellenőrzi. A valódi retrieval-kiértékelésnél a queryt ki kell zárni az adatbázisból. A hasonlósági érték nem „70,7% azonosság”: a skála , és a küszöböt a feladat határozza meg.
F1 – Fogalmi (nehézség 1). Definiálja a koszinusz-hasonlóságot és a koszinusz-distance-t. A , , hármasra mutassa meg, hogy megsérti a metrika háromszög-egyenlőtlenségét. Átadandó: a két definíció, és a konkrét számítás, amely cáfolja a metrikatulajdonságot.
F2 – Levezetési (nehézség 2). A 4. szakasz , , vektoraira számítsa ki a nyers koszinusz- és euklideszi rendezést, majd a Tétel 1 alkalmazásával a normalizált rendezést. Átadandó: a lépések, a két rendezési táblázat és egy mondat arról, mely esetben cserélhető fel a két mérték.
F3 – Implementációs (nehézség 2). Írjon
row_l2_normalize(Z) függvényt, amely (N,d)
float32 mátrixot soronként normalizál, nullvektorra
explicit hibát dob, és a (3,4),(0,0),(5,12) bemenetre
ellenőrzi a helyes sorokat, alakot és egységnormákat.
Átadandó: futtatható kód és a numerikus ellenőrzés.
F4 – Hibakeresési (nehézség 2). Az alábbi kereső hibás:
def nearest_bad(query, database, k):
    s = database @ query        # (N,)
    idx = np.argsort(s)[:k]     # növekvő rendezés
    return idx
A query=[1,0], database=[[2,0],[0,1]]
bemenetre mi a kimenet, mi a várt, és mi a két hiba? Adjon javítást
normalizálással és csökkenő rendezéssel, és ellenőrizze a javított kódot
ugyanezen a példán. Átadandó: hibaelemzés, javított
kód, visszaellenőrzés.
F5 – Kísérleti/transzfer (nehézség 3). Tervezzen
GlyphLab-retrieval protokollt annak mérésére, hogy a test-adatbázisból a
query másik view-ja hányadik helyen kerül vissza. A célindex az azonos
scene_id, eltérő view_id kép.
Átadandó: a hit@k definíció, a query/adatbázis
felosztás, a véletlen baseline, a függetlenségi egység, és a lehetséges
érvényességi korlát. Tilos a test split felhasználása modell- vagy
küszöbválasztásra.
F1. A koszinusz-hasonlóság a 2. szakasz képlete. A koszinusz-distance . A három vektor normája 1. A pontszorzatok:
Ezért , , . A háromszög-egyenlőtlenség lenne, azaz ; ez hamis, tehát nem metrika. Ha szögtávolságot használunk, , az már metrika a gömbfelületen; a keresőben a rangoláshoz ez nem szükséges.
F2. A 4. szakasz számításai:
| Mérték | Nyers | Nyers | Nyers nyerő |
|---|---|---|---|
| koszinusz | |||
| euklideszi távolság |
| Mérték | Normalizált | Normalizált | Normalizált nyerő |
|---|---|---|---|
| koszinusz | |||
| négyzetes euklideszi |
A normalizált esetben a Tétel 1 miatt a rendezések azonosak. A csere tehát akkor érvényes, ha minden vektor egységnormájú; nyers vektorokra a két mérték nem felcserélhető.
F3. Az ellenőrző kód:
import numpy as np

def row_l2_normalize(Z, *, atol=1e-6):
    Z = np.asarray(Z, dtype=np.float32)
    if Z.ndim != 2:
        raise ValueError(f"shape must be (N,d), got {Z.shape}")
    n = np.linalg.norm(Z, axis=1, keepdims=True)
    if np.any(n <= atol):
        bad = int(np.argwhere(n <= atol)[0, 0])
        raise ValueError(f"zero norm at row {bad}")
    return Z / n

Z = np.array([[3.0, 4.0],
              [0.0, 0.0],
              [5.0, 12.0]], dtype=np.float32)

# A nulla sor nélkül:
Z_ok = Z[[0, 2], :]
Z_hat = row_l2_normalize(Z_ok)
assert Z_hat.dtype == np.float32
assert Z_hat.shape == (2, 2)
assert np.allclose(np.linalg.norm(Z_hat, axis=1), [1.0, 1.0],
                   rtol=1e-5, atol=1e-5)
assert np.allclose(Z_hat[0], [0.6, 0.8], rtol=1e-5, atol=1e-5)
# A nullvektor explicit hibát ad:
try:
    row_l2_normalize(Z)
except ValueError as e:
    assert "row 1" in str(e)
print("F3 ok, shape", Z_hat.shape)
A [0,0] sorra nem adunk csendes eps
nevezőt, mert az
vektort állítana elő, amelynek nincs iránya, és a koszinusz-hasonlóság
nem értelmezhető.
F4. A query=[1,0],
database=[[2,0],[0,1]] mellett
.
A legnagyobb hasonlóságú elem a 0. indexű, de az argsort(s)
növekvően a
indexsorrendet adja, így a kód a legkevésbé hasonlót adja vissza.
Második hiba: a pontszorzatot normalizálatlan vektorokon számolja, így a
normák torzítják a hasonlóságot. A javítás:
def nearest_fixed(query, database, k):
    q = query / np.linalg.norm(query)
    db = database / np.linalg.norm(database, axis=1, keepdims=True)
    s = db @ q
    return np.argsort(-s, kind="stable")[:k]
Visszaellenőrzés: s=[1,0], argsort(-s) a
[0,1]-t adja, ami a várt sorrend.
F5 megoldásminta. Jelölje
a 60 testképet, és minden queryre az adatbázis legyen a másik 59
testkép. A cél
az a kép, amelynek scene_id-je azonos,
view_id-je eltérő. Legyen
az indexelt kereső
legmagasabb találatának halmaza; ekkor
A query-k nem függetlenek, mert két nézet ugyanabból a jelenetből
származik; a bootstrap-ismétlés egysége ezért scene_id, nem
kép. Véletlen baseline, ha a queryt kizártuk:
.
A kísérlet előre rögzíti a befagyasztott CNN-checkpointot; a test
halmazon küszöböt vagy modellváltozatot nem választunk. Egyetlen nagy
hit@k jó indikáció, de nem bizonyít szemantikai azonosságot, és a
GyphLab kis mérete miatt a konfidenciaintervallum széles.
A legveszélyesebb tévedés, hogy a közeli embedding
automatikusan szemantikai vagy jogilag releváns azonosságot
jelent. A hasonlósági kereső azt adja vissza, ami a tanult
távolság szerint közel van; ez lehet ugyanolyan orientációjú, de másik
scene_id-jű GlyphLab-jelenet is. Két különböző jelenet
azonos osztálya, hasonló pozícióval, nagyon közeli embeddinget kaphat,
miközben nem ugyanaz a példány. Az arc-hasonlósági rendszerekben a
küszöb feletti hasonlóság sem jogi azonossági bizonyíték; a döntéshez
kalibrált küszöb, döntési protokoll és szükség esetén emberi kontroll
kell. Ez összhangban áll a 25.4. Nyílt halmaz és
ismeretlen input alfejezetben tárgyalt korláttal: a nagy
softmax-konfidencia sem pótolja a felhasználási szerződést.
Önellenőrzés.
Korábbi fogalmak rövid visszahívása. A 3.4. Sajátérték, SVD és spektrális határ spektrális normája megmutatta, hogy egy lineáris réteg maximális nyújtása ; ezért a nyers hálókimenet normája rétegenkénti skálától függ. A 16.1. Eltolási equivariance és invariance alfejezetben bizonyítottuk, hogy a CNN belső tartományon eltolási ekvivariáns, de az L2-normalizálás utáni hasonlósági térben ezt a tulajdonságot újra kell mérni. A 24.1. Tanulási görbe és hibadiagnózis diagnosztikai elve ide is átvihető: ha a retrieval rossz, a hibát külön kell keresni a normalizálásban, a query-kizárásban, a feature extractorban és a célindexelésben, nem egyetlen feltételezett okban.
Az embedding olyan tanult -dimenziós vektor, amelyet hasonlósági keresésre tervezünk; a logittól fogalmilag különbözik. Az L2-normalizálás az egységgömbre vetít, és eltávolítja a háló kimeneti skáláját. Egységnormájú vektorokra levezettük a azonosságot, ezért a koszinusz-hasonlóság és a négyzetes euklideszi távolság rendezése ekvivalens. Nyers vektorokra ez az ekvivalencia nem áll fenn. A labor egy kis exact koszinusz-keresőt és a saját CNN checkpointból nyert embeddingek használatát adja. A közeli embedding azonban nem automatikus azonosság; a felhasználási döntéshez küszöböt, protokollt és korlátot kell rögzíteni.
A 28.2. Sziámi és triplet cél ezt a reprezentációt tanítja be közvetlenül hasonlósági céllal: ott a triplet loss azt fogalmazza meg, hogy az azonos entitás két nézete közelebb legyen, mint egy idegen nézet.