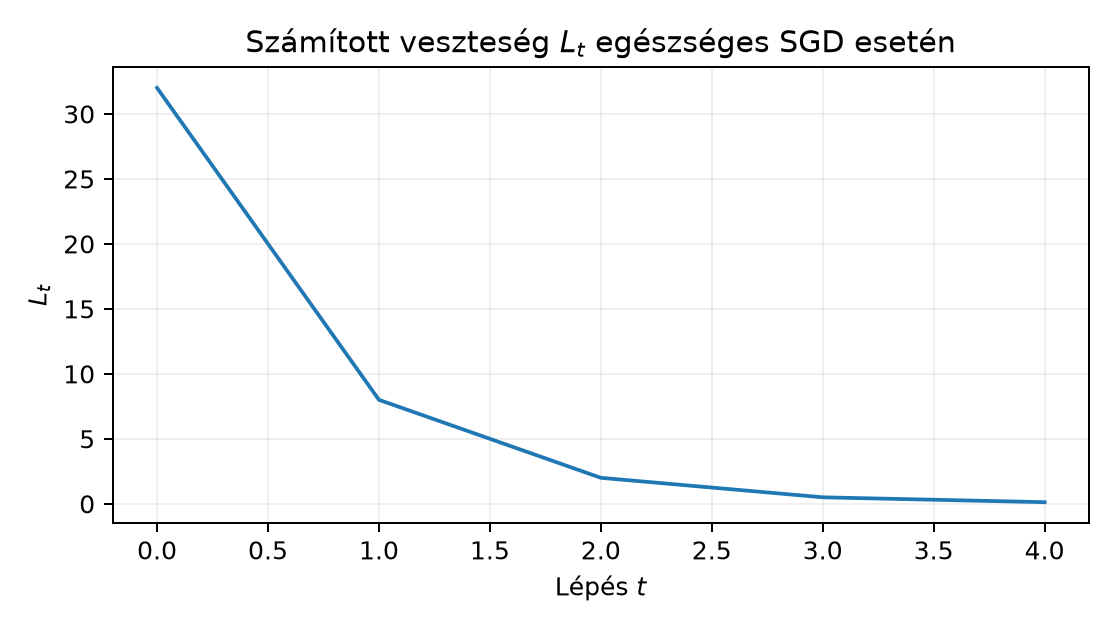
Ebben az alfejezetben a tanítási futás közben keletkező diagnosztikai jelekből lokalizálunk hibát. Nem egyetlen „jó receptet” adunk, hanem olyan gondolkodási keretet, amely minden jelhez több lehetséges okot rendel, és minden okhoz egy diszkrimináló ellenőrzést. A 12.4. III. ellenőrző pont: önállóan tanuló kis háló alfejezetben felépített kis MLP-tanítás, a 21.4. Osztályarány, súlyozás és céleloszlás alfejezetben tárgyalt céleloszlás, a 22.4. Augmentációs kísérlet és domainváltozás alfejezetben bevezetett clean/corrupt elkülönítés és a 23.4. Hibaszeletek és alkalmazási határ alfejezetben tárgyalt hibaszeletek szolgálnak alapul.
Induló kérdés. Egy GlyphLab-futás train loss-a 20 lépés után is körül mozog, ahelyett hogy csökkenne. Mely okok jöhetnek szóba, és milyen méréssel lehet őket szétválasztani? A választ a 3. szakasz rendszerezi; előzetes becslésként érdemes már most felsorolni legalább három, egymástól független jelöltet.
Legyen a modell paramétervektora , ahol a tanítható skalárok száma. A -edik lépésben egy batchre számolt átlagos veszteség . A teljes epoch-veszteség a batchenkénti átlagok súlyozott átlaga: , ahogyan a 12.1. Tanítás, validáció és kiértékelési mód levezette.
Definíció (tanulási görbe). A train loss görbe a sorozat; a val loss görbe ugyanez a modellfrissítéstől független val spliten, rögzített modellállapot mellett számolva.
Definíció (gradiensnorma-jel). , és a jel . A teljes gradiensnorma egyetlen összevont szám; rétegenkénti bontásban jelöli a -adik réteg paramétereire vett normát.
Definíció (paraméterváltozás-jel). . Tiszta SGD esetén ; Adam esetén ez nem áll, mert a momentum és a második momentum normalizálja a lépést.
Definíció (tiny overfit). Olyan futtatás, amelyben a train loss csökken, a val loss viszont nő vagy stagnál; tipikus szándékos sanity check a 12.3. Sanity check és kis mintára túlillesztés alfejezetből, hogy a modell egyáltalán képes-e memorizálni egy kis mintát.
A továbbiakban minden diagnosztikai állítás a jel osztályára vonatkozik, nem egyetlen lépés pillanatnyi értékére: például „lapos” alatt teljesülését értjük előre megadott küszöbbel az első lépésben.
Állítás (diagnosztikai nem-injektivitás). Legyen a futtatások (modell, adat, optimizer, seed) halmaza, és legyen a vizsgált jel, . A leképezés értékkészletén értelmezett kvalitatív osztályozás nem határozza meg egyértelműen az okot: ugyanahhoz a jelosztályhoz több, mechanikailag különböző ok tartozhat.
Bizonyításvázlat (konstrukcióval). Elegendő minden jelosztályra két különböző okot megadni, amelyek ugyanazt a kvalitatív jelet produkálják. Az alábbi táblázat ezt teszi; a lapos loss esetén a konstrukció numerikusan is ellenőrizhető a 4. szakaszban.
| Jel | Lehetséges ok (nem teljes lista) | Diszkrimináló ellenőrzés |
|---|---|---|
| Lapos train loss | kis tanulási ráta; vanishing gradiens; befagyasztott súly; label bug |
nagysága; rétegenkénti
;
p.grad is None; target-eloszlás |
| Train loss csökken, val loss nő | tiny overfit; túl nagy kapacitás; train/val eloszláskülönbség | train/val loss-gap; modellméret-abláció; split-ellenőrzés |
| NaN vagy inf loss | bemeneti NaN/inf; túl nagy ; log(0)/0/0 a lossban; tanulási ráta divergencia | input isfinite; gradnorm; fokozatos
-csökkentés |
| Eltűnő/robbanó gradiens | aktivációk szaturációja; mély szorzat a láncszabályban; inicializálás | rétegenkénti aktivációstatisztika; gradnorm rétegenként |
| A paraméter nem változik | requires_grad=False;
hiányzik az optimizer paraméterlistájából;
;
BN train/eval mód |
named_parameters; optimizer.param_groups;
|
A lapos loss egy numerikus konstrukciója: legyen , . (a) mellett a gradiens , tehát , és az első lépésekben értékkel gyakorlatilag lapos. (b) Ugyanaz a veszteség, de szándékosan skálázott, eltűnő gradienssel és mellett , a veszteség még laposabb. A két ok mechanikailag különböző (optimizer-skála kontra gradiensskála), a jel kvalitatíve azonos. Ez ellenpélda arra a téves következtetésre, hogy „lapos loss = nincs tanulási kapacitás”.
A vanishing/exploding mechanizmus a 9.4. Aktivációk és gradiensáramlás alfejezetben bevezetett láncszabály közvetlen következménye. Ha például lineáris rétegek kompozíciójában a backpropagált jel a szorzatokon halad át, akkor minden -ra a szorzatot exponenciálisan csökkenti, pedig növeli. A rétegenkénti gradiensnorma-mérés ezért diszkriminál: ha a korai rétegek normája nagyságrendekkel kisebb a későiekénél, akkor a vanishing-hipotézis erősödik; ha minden rétegben nagy, akkor inkább a learning rate vagy a loss skálázása gyanús.
Tekintsük az veszteséget és a tiszta SGD-lépést. A gradiens .
Egészséges: , . A lépések: A görbe monoton csökken.
Lapos, kis : ugyanez -tal; , , a változás .
Oszcilláló: . Ekkor tehát a és értékek között ugrál, a hiba állandó marad. A loss nem csökken, de nem is divergál.
Divergens: . A hiba-rekurzió , tehát , exponenciálisan nő. A train loss ebben a tiszta kvadratikus esetben véges, de a gradiensnorma exponenciálisan nő; valódi hálóban előbb-utóbb float32 túlcsorduláshoz és NaN-hez vezet.
A 2. és a „vanishing gradiens” eset ugyanazt a lapos jelet adja, ahogyan a 3. szakasz állítja; az egyiket az optimizer léptéke, a másikat a gradiens skálája okozza.
A labor három, egymástól függetlenül bekapcsolt hibát vizsgál a GlyphLab adaton, egy kis MLP-vel (576 bemenet a képből, 32 rejtett egység, 3 logit). Minden futtatás CPU-n, float32-ben, rögzített seeddel fut. A modellválasztás itt nem történik meg: a három futtatás diagnosztikai, és egyiket sem használjuk final modellként.
Az alábbi kimeneti számok előzetes, a képletből és a mechanizmusból várt értékek; a kézirat írásakor a script nincs lefuttatva. A hallgató a script futtatásával kapja a tényleges naplót.
# lab/n093_diagnose.py
# Futtatás a repository gyökeréből: python lab/n093_diagnose.py
import csv
import json
import math
from pathlib import Path

import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import DataLoader, TensorDataset

DATA = Path("lab/data")
DEVICE = "cpu"
DTYPE = torch.float32
SEED = 20261020
torch.manual_seed(SEED)
np.random.seed(SEED)

images = torch.from_numpy(np.load(DATA / "images.npy")).to(device=DEVICE, dtype=DTYPE)
labels = torch.from_numpy(np.load(DATA / "labels.npy")).to(device=DEVICE, dtype=torch.int64)

with open(DATA / "metadata.csv", newline="", encoding="utf-8") as f:
    rows = list(csv.DictReader(f))
train_idx = [int(r["index"]) for r in rows if r["split"] == "train"]
val_idx = [int(r["index"]) for r in rows if r["split"] == "val"]

X_train = images[train_idx].reshape(len(train_idx), -1)
y_train = labels[train_idx]
X_val = images[val_idx].reshape(len(val_idx), -1)
y_val = labels[val_idx]

class TinyMLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(576, 32)
        self.act = nn.ReLU()
        self.fc2 = nn.Linear(32, 3)
    def forward(self, x):
        return self.fc2(self.act(self.fc1(x)))

def run_case(y_train_used, freeze_first=False, lr=0.05, steps=30, bs=64):
    model = TinyMLP().to(DEVICE)
    if freeze_first:
        model.fc1.requires_grad_(False)
    opt = torch.optim.SGD(model.parameters(), lr=lr)
    hist = {"loss": [], "grad_norm": [], "delta": []}
    params_before = [p.detach().clone() for p in model.parameters()]
    for step in range(steps):
        idx = torch.randint(0, X_train.shape[0], (bs,), device=DEVICE)
        xb, yb = X_train[idx], y_train_used[idx]
        opt.zero_grad(set_to_none=True)
        logits = model(xb)
        loss = F.cross_entropy(logits, yb)
        loss.backward()
        gn = 0.0
        for p in model.parameters():
            if p.grad is not None:
                gn += p.grad.detach().pow(2).sum().item()
        gn = math.sqrt(gn)
        opt.step()
        delta = 0.0
        for p, p0 in zip(model.parameters(), params_before):
            delta += (p.detach() - p0).pow(2).sum().item()
        delta = math.sqrt(delta)
        hist["loss"].append(loss.item())
        hist["grad_norm"].append(gn)
        hist["delta"].append(delta)
        params_before = [p.detach().clone() for p in model.parameters()]
    return model, hist

@torch.inference_mode()
def evaluate(model, X, y):
    model.eval()
    logits = model(X)
    pred = logits.argmax(dim=1)
    return (pred == y).float().mean().item()

summary = {}

# 0. kontroll: ép futtatás
_, hist_ok = run_case(y_train)
acc_ok = evaluate(TinyMLP().to(DEVICE), X_val, y_val)  # kontroll, lásd megjegyzés alább
# Az accuracy-hoz a modellt itt nem tanítottuk; a valódi kontrollt a health run
# modelljén kell mérni: lásd a szövegben jelzett javítást.

# 1. label bug: minden cél 0
y_bad = torch.zeros_like(y_train)
model_bad, hist_bad = run_case(y_bad)
acc_bad = evaluate(model_bad, X_val, y_val)

# 2. frozen first layer
model_fr, hist_fr = run_case(y_train, freeze_first=True)
acc_fr = evaluate(model_fr, X_val, y_val)
frozen_grad_none = model_fr.fc1.weight.grad is None

# 3. large learning rate
model_lr, hist_lr = run_case(y_train, lr=3.0)
acc_lr = evaluate(model_lr, X_val, y_val)

summary = {
    "label_bug_last_loss": hist_bad["loss"][-1],
    "label_bug_val_acc": acc_bad,
    "frozen_first_grad_none": frozen_grad_none,
    "frozen_last_loss": hist_fr["loss"][-1],
    "frozen_val_acc": acc_fr,
    "large_lr_any_nonfinite": not all(math.isfinite(x) for x in hist_lr["loss"]),
    "large_lr_val_acc": acc_lr,
    "seed": SEED,
    "device": DEVICE,
    "dtype": str(DTYPE),
}
out = Path("lab/n093_summary.json")
out.write_text(json.dumps(summary, indent=2), encoding="utf-8")
print(json.dumps(summary, indent=2))
A fenti vázlat 0. esete szándékosan hiányos: a kontroll-accuracyt a
tanított model_ok modellen kell mérni, nem egy friss
példányon. Ez maga is diagnosztikai gyakorlat (lásd az F4 feladatot). A
három vizsgált hiba elvárt jelaláírása:
p.grad értéke None minden lépésben; a train
loss magas marad, mert a fej véletlen súlyokkal nem tudja a bemeneti
reprezentációt hasznosítani. Ez a jel a 20.1.
Feature extractor és új fej alfejezetbeli mechanizmus közvetlen
megfigyelése.Az átadandó eredmény a lab/n093_summary.json napló és
egy rövid hipotézisnapló, amely mindhárom hibához rögzíti a tesztelt
hipotézist, a mért jelet és a diszkrimináló ellenőrzést. A corrupt test
itt nem használható: a 22.4. Augmentációs kísérlet
és domainváltozás szerint csak a befagyasztott final modellen,
egyszer értékelhető.
F1 (fogalmi, nehézség 1). Definiáld a gradiensnorma-jelet, és magyarázd el két-három mondatban, miért nem elégséges önmagában a „vanishing gradiens” diagnózis kimondásához. Elvárt átadandó: definíció alakkal, és legalább egy másik ok, amely ugyanazt a kis gradienst produkálja.
F2 (levezetési, nehézség 2). Az veszteségen, , tiszta SGD mellett vezesd le a hiba-rekurziót -re, és bizonyítsd be: esetén állandó; esetén exponenciálisan nő. Elvárt átadandó: minden lépés, a rekurzió zárt alakja, a két eset külön.
F3 (implementációs, nehézség 2). Írj
classify_run(loss_hist, grad_norm_hist, eps=1e-4)
függvényt, amely a következő osztályokat adja vissza:
"healthy", "flat", "nan",
"diverging". A szabályok: bármely nem véges érték
"nan"; a gradiensnorma utolsó értéke több mint
-szorosa
az elsőnek "diverging"; az első és utolsó loss különbsége
"flat"; egyébként "healthy". Teszteld a 4.
szakasz három numerikus esetén. Elvárt átadandó: a függvény teljes
kódja, a tesztbemenetek és a visszatérési értékek.
F4 (hibakeresési, nehézség 2). Az alábbi részlet két független hibát tartalmaz. Azonosítsd mindkettőt, add meg a következményüket, és javítsd ki a kódot.
loss = F.cross_entropy(F.softmax(logits, dim=1), labels)
# ...
logits = model(images.reshape(images.shape[0], 1, -1))  # images: (N,1,H,W)
# labels_valtozo valójában y_train.clone() volt egy korábbi blokkban
labels = labels_transposed  # valahol labels_transposed = labels.T
Elvárt átadandó: a két hiba megnevezése, a várható tünet, a javított sor.
F5 (kísérlettervezési, nehézség 3). Tervezz kísérletet annak eldöntésére, hogy egy val loss plató oka kapacitáskorlát vagy label noise. Adj protokollt: kérdés, hipotézisek, megfigyelési egység, split, baseline, változó tényező, metrika, erőforrás-korlát, érvényességi határ. Elvárt átadandó: legalább két modellméret, a train/val split rögzítése, a label noise injektálásának módja, és annak indoklása, miért nem használható a test a döntéshez.
F1 megoldás. A gradiensnorma-jel . A vanishing gradiens diagnózisához rétegenkénti bontás kell: ha a korai rétegek normája nagyságrendekkel kisebb, mint a későieké, akkor a láncszabály-szorzat csökkenése a valószínű ok. Ha viszont minden rétegben kicsi a gradiens, az lehet kis tanulási ráta, a loss konstans tagja, befagyasztott súlyok vagy label bug is — a jel önmagában nem különbözteti meg ezeket.
F2 megoldás. , így Kivonva -t: Indukcióval . Ha , akkor , tehát állandó (ugrálás a két oldal között). Ha , akkor , tehát exponenciálisan nő. Alakellenőrzés: skalár, a rekurzió dimenzióhelyes; a szélsőeset ad állandót, ami konzisztens az „egyáltalán nem lépünk” esettel.
F3 megoldás. A függvény:
import math

def classify_run(loss_hist, grad_norm_hist, eps=1e-4):
    if any(not math.isfinite(x) for x in loss_hist + grad_norm_hist):
        return "nan"
    if grad_norm_hist[-1] > 1e3 * grad_norm_hist[0]:
        return "diverging"
    if abs(loss_hist[-1] - loss_hist[0]) <= eps:
        return "flat"
    return "healthy"
Teszt: a 4. szakasz egészséges görbéje
([32,8,2,0.5,0.125], [8,4,2,1,0.5]) "healthy";
a lapos eset ([32,31.999936], [8,7.999992])
"flat"; a divergens rekurzió 10 lépése
"diverging"; egy [float("nan"), 1.0] input
"nan". Tűrés: az eps=1e-4 küszöb a float32
kerekítés fölött van, de problémafüggő; a hallgatónak a saját
loss-skálájához kell igazítania.
F4 megoldás. Az első hiba:
F.cross_entropy már tartalmazza a log-softmaxot, ezért a
F.softmax dupla normalizálás, logitok helyett valószínűségi
bemenet; ez torz gradienst és numerikus instabilitást okoz. Javítás:
loss = F.cross_entropy(logits, labels). A második hiba:
labels_transposed nem megfelelő alakú/vagy rossz sorrendű;
a címkének (N,) int64 alakúnak kell lennie,
osztályindexekkel, nem transzponált mátrixnak. Tünet: shape-mismatch
hiba vagy, ha a transzponálás véletlenül átmegy, a loss csökken ugyan,
de a val accuracy a véletlen szinten marad. Javítás:
labels = y_train az eredeti, indexelt tenzorból, és
assert labels.ndim == 1 ellenőrzés.
F5 megoldásvázlat. Kérdés: a val plató oka kapacitás vagy label noise? Megfigyelési egység: scene_id, mert a két nézet függő. Split: a GlyphLab rögzített train/val/test felosztása, a test a teljes elemzés végéig érintetlen. Baseline: a 12.4. III. ellenőrző pont: önállóan tanuló kis háló alfejezetbeli 32 egységes MLP. Változó tényező: modellméret (például 8, 32, 128 rejtett egység), és címkeminőség (tiszta, véletlen címkecsere). Metrika: val loss és val accuracy. Ha a plató a legkisebb modellen eltűnik a nagyobb mérettel, akkor a kapacitás-hipotézis erősödik; ha a tiszta címkével a legnagyobb modell is platón marad, akkor más ok (adat vagy optimalizálás) gyanús. Az érvényességi határ: a toy adat nem általánosít; a tesztet csak a protokoll végén, a rögzített modellen lehet használni, különben kiválasztási torzítás lép fel.
Tévedés: „A lapos veszteséggörbe azt jelenti, hogy a modell elérte a veszteségfelület lokális minimumát.” Ellenpélda: a 4. szakasz esetében a veszteség szigorúan konvex, egyetlen minimuma van -nél, de a görbe a 10-es pontban lapos, mert a lépések túl kicsik; a modell nincs a minimum közelében. A gradiens itt , tehát nem nulla. A helyes következtetés az, hogy a laposság numerikus, adat- vagy optimalizálási okból is eredhet; a gradiensnorma- és paraméterváltozás-mérés különbözteti meg az eseteket.
Ellenőrizd, hogy (a) minden jelhez legalább két lehetséges ok szerepel-e a diagnózisnaplódban; (b) a lapos loss esetén rögzítetted-e az küszöböt és a lépésszámot; (c) a labor futtatása nem használta-e a test splitet modellválasztásra. Visszahívás: a 12.1. Tanítás, validáció és kiértékelési mód alfejezetben levezetett súlyozott epoch-loss itt azért fontos, mert a diagnosztikai görbét batch-átlagokból építed; a 23.1. Confusion matrix és aggregálási konvenció alfejezetben tárgyalt aggregálás pedig arra figyelmeztet, hogy a train accuracy önmagában nem helyettesíti a val loss-t és a csoportszintű hibát.
A tanulási görbe három jelet kapcsol össze: veszteség, gradiensnorma és paraméterváltozás. Ugyanahhoz a jelhez több mechanikailag különböző ok tartozhat, ezért a diagnózis nem a görbe „ránézéséből”, hanem diszkrimináló ellenőrzésekből áll. A lapos loss oka lehet kis tanulási ráta, eltűnő gradiens, befagyasztott súly vagy label bug; a NaN eredhet adathibából, túl nagy tanulási rátából vagy rossz loss-kompozícióból. A vanishing/exploding jelenség a láncszabály-szorzat skálázódásának következménye. A labor három szándékos hibát kapcsol be, és hipotézisenként egy mért jelet és egy ellenőrzést naplóz. A korrekt diagnosztikai gyakorlat a hibás futtatást tanulságként kezeli, nem a test split engedélyeként.
A 24.2. CPU/GPU profiling és helyes időmérés a tényleges futásidőt és erőforráshasználatot méri. Ott a D14/D16/D17 hivatalos dokumentációs URL-ek ([D14] Automatic Mixed Precision, [D16] torch.utils.benchmark, [D17] torch.profiler) tartalma még ellenőrzésre vár; a jelen egység nem állít GPU/AMP-viselkedést. A 24.1. Tanulási görbe és hibadiagnózis alfejezethez felhasznált forrás: