A 8.1. Kockázat, mintavétel és baseline alfejezetben láttuk, hogy a Hoeffding-korlát egy rögzített hipotézisre számszerűsíti az empirikus és a populációs kockázat eltérését. A gyakorlati modellválasztás azonban nem rögzített: több jelölt közül éppen azt választjuk, amelyik a tanítómintán a legjobbnak látszik. Ebben az alfejezetben az a kérdés, hogyan kaphatunk olyan állítást, amely minden jelöltre egyszerre, tehát a mintán választott modellre is érvényes, ha véges.
Előismeret: a 8.1. Kockázat, mintavétel és baseline populációs kockázat, empirikus kockázat, iid minta és a Hoeffding-állítás fogalma; a 7.2. Softmax és többosztályos cross-entropy cross-entropy definíciója; a 4.2. Parciális derivált és gradiens gradiens fogalma annyiban, hogy itt tudatosan nem használunk differenciálhatóságot: a korlát csak korlátosságot és függetlenséget kér.
Induló becslés: ha jelölt, minta és megengedett kudarcvalószínűség, mekkora hibasáv garantálható? A levezetés után ezt pontosan kiszámítjuk.
Legyen a bemeneti tér, a célok tere, pedig hipotézisosztály, azaz jelöltek egy halmaza; elemei függvények. A tanulási feladat loss függvénye , tehát értékkészlete a zárt intervallumba esik. Egy -ra a populációs kockázat és az iid mintán vett empirikus kockázat:
A tenzoralak itt egyszerű: ha a modell megfigyelésre logitokat ad, akkor a loss megfigyelésenként egy-egy skalár, az empirikus kockázat pedig ezek átlaga, tehát skalár. A skalár reduction elengedhetetlen: a Hoeffding-korlát átlagokra szól.
Az alábbi állítást adottnak vesszük; a teljes bizonyítást nem reprodukáljuk, mert forrása [P27] eredeti cikke, amelynek státusza jelen kéziratban kiadói bibliográfiai rekord, nem pedig teljesen olvasott bizonyítás.
Tétel (Hoeffding, -korlátos alak). Legyen független valószínűségi változó, mindegyik a intervallumba esik; legyen és . Ekkor minden -ra
és a két irányt összeadva
A a képletekben természetes logaritmus. A alakra az általános Hoeffding-állításból , helyettesítéssel jutunk. Az állítást rögzített hipotézisre már 8.1. Kockázat, mintavétel és baseline alkalmazta: ott .
A uniókorlát (union bound) elemi valószínűségi egyenlőtlenség: tetszőleges eseményekre
A jobb oldal akkor is igaz, ha az események erősen összefüggenek; ezért a korlát sok eseményre laza lehet, de a levezetés egyszerű és mindig érvényes.
Most bizonyítjuk az alfejezet fő állítását. A felhasznált Hoeffding-alakból indulunk ki; a saját hozzájárulás az uniókorlát alkalmazása.
Tétel (véges hipotézisosztály egyenletes korlátja). Legyen véges, . Tegyük fel, hogy a loss minden bemenetre, és iid minta. Ekkor minden -ra
Bizonyítás. Rögzítsünk egy -t. Az változók a -be esnek; az iid minta miatt függetlenek, és . A kétoldali Hoeffding-korlát szerint minden -ra
Definiáljuk az eseményt. A bal oldalon álló akkor és csak akkor éri el -t, ha valamelyik -ra bekövetkezik ; tehát
A uniókorlátot és (1)-et alkalmazva, felhasználva, hogy az összegben tag van:
Ezzel az állítást beláttuk.
A bizonyítás státusza: a Hoeffding-egyenlőtlenség bizonyítását a kézirat nem végzi el; a tétel kimondott, [P27]-re hivatkozó előfeltétel. A uniókorlátos lépés a jelen alfejezet saját, teljes levezetése.
A tétel kényelmesebb alakját kapjuk, ha a kudarcvalószínűségre adott felső korlátot rögzítünk. Legyen a konfidenciaparaméter; a megcélzott konfidenciaszint. Megoldjuk a
egyenletet -ra:
Ezzel a tétel így fogalmazható: valószínűséggel egyszerre minden -ra
Az értelmezése feltételes, ismételt mintavételi garancia: ha a kísérletet sok független mintán megismételnénk, a minták legfeljebb hányadán romolhat el az egyenletes hibasáv; az [S02] forrás a konfidenciaintervallum hasonló értelmezését tárgyalja.
Vezessük le az adaptív választásra vonatkozó következményt. Legyen az empirikus kockázatminimalizáló (ERM), azaz , és legyen a populáció szerinti legjobb. Az egyenletes eseményen minden -ra, így -ra és -ra is igaz, hogy . Ezért
Itt a középső egyenlőtlenség az ERM definíciója: minimalizálja -t. A végeredmény a tanulási korlát:
Következmény. A fenti feltételek mellett legalább valószínűséggel
Ez az, amit a rögzített -ra vonatkozó 8.1. Kockázat, mintavétel és baseline alfejezetbeli korlát nem tudott garantálni: az adaptívan választott hibája legfeljebb -nal haladja meg az osztály legjobb populációs kockázatát, a többlet pedig az uniókorlát ára.
Tekintsük a bevezető kérdést: , , . Ekkor
Tehát 95% konfidenciaszinten az empirikus kockázat minden jelöltre legfeljebb százalékponttal tér el a populációs kockázattól, az ERM pedig legfeljebb százalékponttal rosszabb, mint az osztály legjobbja.
A labor kódja determinisztikus: nincs véletlenszám, nincs tensor,
ezért seed, dtype és device nem alkalmazandó. A math modul
64 bites lebegőpontos számítást végez.
"""lab/n030_bound.py — Véges H egyenletes korlátjának numerikus számítása.

A számítás determinisztikus, ezért nincs seed, tensor dtype vagy device.
Futtatás: python lab/n030_bound.py
"""
import math

def uniform_bound(M: int, n: int, delta: float) -> tuple[float, float]:
    """Adott M, n, delta mellett visszaadja (epsilon, bound).

    bound = 2*M*exp(-2*n*epsilon**2), amelynek delta körül kell lennie
    a (2) képlet numerikus ellenőrzéseként.
    """
    if not (isinstance(M, int) and isinstance(n, int)):
        raise TypeError("M és n egész típusú legyen")
    if M <= 0 or n <= 0:
        raise ValueError("M és n pozitív egész")
    if not 0.0 < delta < 1.0:
        raise ValueError("delta a nyílt (0,1) intervallumba esik")
    eps = math.sqrt(math.log((2.0 * M) / delta) / (2.0 * n))
    bound = 2.0 * M * math.exp(-2.0 * n * eps * eps)
    return eps, bound

def main() -> None:
    delta = 0.05
    tolerance = 1e-12  # 64 bites lebegőpontos ellenőrzési küszöb
    print(f"delta = {delta}")
    for M in (10, 1000, 1_000_000):
        print(f"M = {M}")
        for n in (100, 500, 1000, 5000, 10_000):
            eps, bound = uniform_bound(M, n, delta)
            ok = abs(bound - delta) <= tolerance * max(1.0, delta)
            print(f"  n={n:6d}  epsilon={eps:.6f}  bound={bound:.6e}  ellenorzes={ok}")

if __name__ == "__main__":
    main()
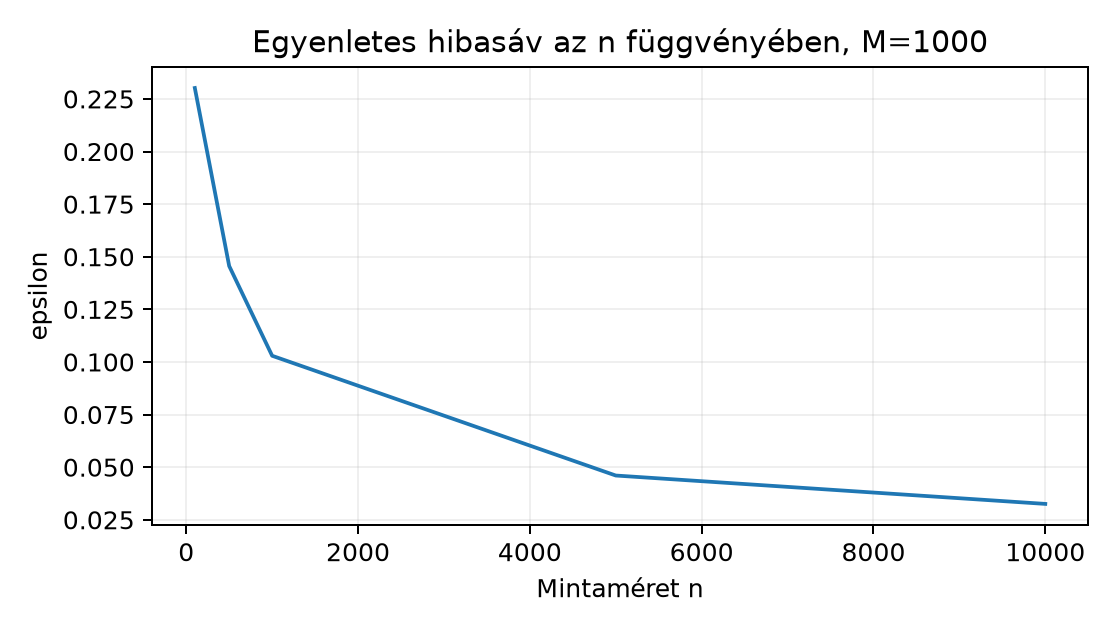
Az alábbi értékek a (2) képletből számított szemléltetésként szerepelnek, nem mérési eredmények.
| 10 | 100 | 0,173082 |
| 10 | 1000 | 0,054733 |
| 10 | 10000 | 0,017308 |
| 1000 | 100 | 0,230181 |
| 1000 | 1000 | 0,102941 |
| 1000 | 10000 | 0,032552 |
| 100 | 0,295842 | |
| 1000 | 0,132304 | |
| 10000 | 0,041838 |
A bound oszlop minden sorban
-öt
ad vissza a lebegőpontos pontosság erejéig: a (2) képletet úgy
definiáltuk, hogy a helyettesítés kiejtse egymást. Ez az ellenőrzés azt
igazolja, hogy a kód az inverz képletet konzisztensen számolja.
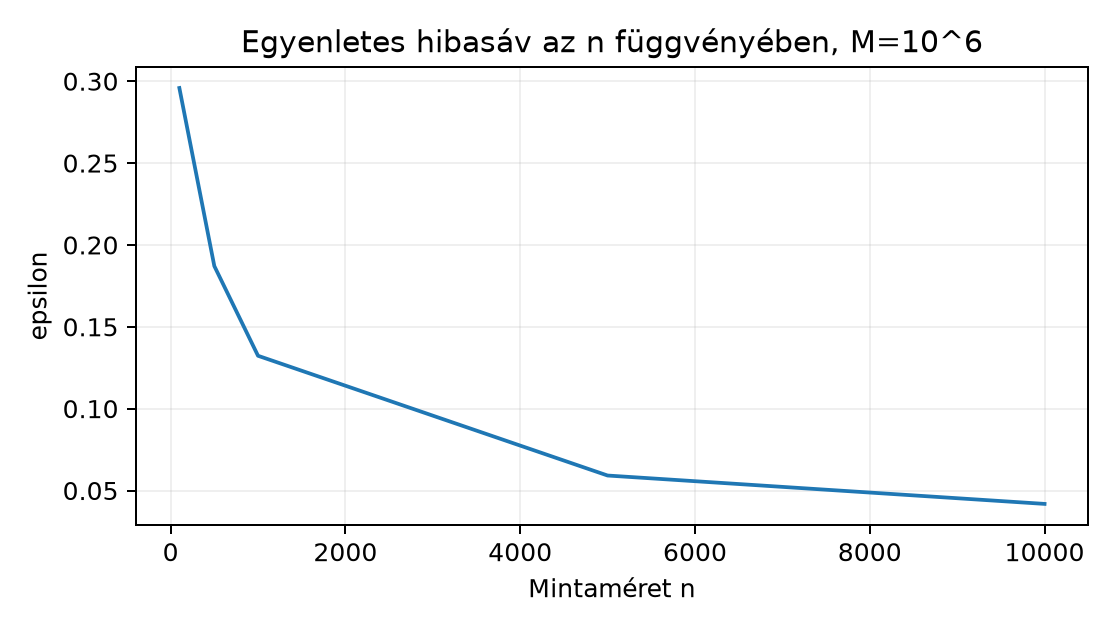
Mikor használhatatlanul laza a korlát? A képlet két logaritmusos, két gyökös tényezőt tartalmaz. , esetén százalékpont; egy -beli losson a teljes tartományhoz képest ez hatalmas, és az ERM-korlát százalékpont. A gyakorlati összehasonlításokban ennél jóval kisebb különbségek is döntőek. Két ok miatt laza a korlát: (i) a Hoeffding-korlát maga sem használja ki az eloszlás szórását; (ii) az uniókorlát a legrosszabb esetben teljesen független eseményeket feltételező összeget ad, pedig a hipotézisek kockázatbecslései erősen korrelálnak. Ezért a alakot felső garanciaként, nem pedig éles predikcióként kell olvasni. Kis -re vagy nagy -re a korlát gyakorlati döntésre alkalmatlan lehet, ettől matematikailag helyes.
A tétel feltétele, hogy a loss minden bemenetre -be essen. A többosztályos cross-entropy a 7.2. Softmax és többosztályos cross-entropy alfejezetből logitsokra:
Ez nem korlátos -gyel. Legyen , a helyes osztály , a logit pedig . Ekkor
A logit növelésével a loss tetszőlegesen nagy lehet, tehát nem létezik rögzített , amellyel a -re normálás a feladat tartalmi megváltozatása nélkül elvégezhető lenne.
Nézzünk konkrét ellenpéldát arra, hogy a feltétel nélkül a konklúzió ténylegesen hamis lehet. Legyen , tehát , . Tegyük fel, hogy az egyetlen megfigyelés célja valószínűséggel , valószínűséggel , a modell pedig mindig logitot ad. A loss esetén , esetén ; így . Az egyelemű mintán vagy , vagy , tehát
hiszen az eltérés mindkét kimenetelben . A -korlátos tétel viszont -re felső korlátot adna, ami nyilvánvalóan hamis erre a nem korlátos lossra. A tétel érvényes, a feltételei azonban nem teljesülnek: változtatás nélkül nem alkalmazható korlátlan cross-entropyra. Ha a loss -be esik, akkor a -re skálázott változatra alkalmazható a korlát, de a skálának megfelelően is skálázódik; a nyers logits-alapú cross-entropy esetén nincs ilyen véges .
Fogalmazza meg saját szavaival a uniókorlátot, és magyarázza el, miért lép be az szorzó a képletbe. Adjon két olyan eseményt, amelyre a uniókorlát egyenlőséggel teljesül, és kettőt, amelyre a korlát szigorúan nagyobb a tényleges valószínűségnél. Elvárt eredmény: definíció, az szorzó eredete és négy konkrét esemény indoklással.
Legyen , , . Számítsa ki a (2) képlettel -t, majd az egyenletes esemény feltételével vezesse le az ERM-hibakorlátot: igazolja, hogy legalább valószínűséggel , és adja meg a számértékét. Elvárt eredmény: levezetése, a három egyenlőtlenség mindegyikének indoklása, végső számérték.
Írjon Python függvényt, amely az
hármasból a (2) képlet szerint
-t
és a
azonosság numerikus ellenőrzését adja vissza. Tesztelje
-re.
A kód tartalmazzon típus- és tartományellenőrzést. Elvárt eredmény:
futtatható kód, a fenti paraméterre
és a bound visszaadása
körül
relatív tolerancián belül.
A következő függvény hibás:
def rossz_epsilon(M: int, n: int, delta: float) -> float:
    import math
    return math.sqrt(math.log(M / delta) / (2 * n))
Lokalizálja a hibát, magyarázza el a matematikai következményét a garantált konfidenciaszintre, javítsa a kódot, és -tel mutassa meg, hogy a hibás érték kisebb, mint a helyes . Visszaellenőrzésképpen számítsa ki, hogy a hibás mellett a mennyiség mennyivel haladja meg a megcélzott -t. Elvárt eredmény: hiba oka, következmény, javított kód és két numerikus kontroll.
Tervezzen Monte Carlo szimulációt annak vizsgálatára, hogy egy konkrét, véges hipotézisosztályon a tényleges maximális eltérés mennyivel kisebb a Hoeffding-unókorlátnál. Válasszon hipotézist, Bernoulli-paraméterekkel a -beli lossra, mintát, rögzített seedet és ismétlést. Írja le a protokollt: megfigyelési egység, a mérendő mennyiség (a minta feletti eloszlása), a Hoeffding-baseline, a Monte Carlo becslés standard hibája, és a következtetés érvényességi határa. A feladat nyitott; nem kell futtatni. Elvárt eredmény: legalább egy teljes protokoll, az alternatívák indoka, és annak megfogalmazása, hogy a szimuláció miért nem cáfolhatja az általános tételt.
A uniókorlát: . A képletben a egyetlen hipotézisre vonatkozó kudarc-korlát; mivel hipotézis van, és a rossz esemény az, hogy bármelyik hipotézisre sérül a sáv, a unió valószínűségét a valószínűségek összege korlátozza, ez az -szeres szorzó.
Egyenlőség például: a kockadobásnál , , ekkor . Szigorú egyenlőtlenség: , , ekkor a unió valószínűsége , az összeg . Egy másik szigorú pár: , ; a unió valószínűsége , az összeg .
Behelyettesítünk a (2) képletbe. természetes:
Az egyenletes esemény valószínűséggel bekövetkezik; ezen az eseményen minden -ra . Az ERM és a populációs optimum egyaránt -beli, ezért (i) , hiszen az egyenletes sáv -ra is igaz; (ii) , mert minimalizálja az empirikus kockázatot; (iii) , mert a sáv -ra is igaz. Összekapcsolva . A számérték , tehát legalább valószínűséggel az ERM populációs kockázata legfeljebb százalékponttal haladja meg az osztály optimumát.
A laborban közölt uniform_bound függvény éppen ezt
valósítja meg. A
-re:
M, n, delta = 1000, 500, 0.05
eps, bound = uniform_bound(M, n, delta)
print(eps, bound)
# Kimenet (lab-profil): 0.1029399569316797 0.05000000000000004
Az ellenőrzés
abs(bound - delta) <= 1e-12 * max(1.0, delta): a
bound a math.exp és a math.log
inverz műveletei miatt
körül lesz
relatív hibán belül. Szélsőeset-kontroll:
,
vagy
ValueError-t ad; ez a (2) képlet logaritmusának és a
valószínűség-értelmezésnek a tartományellenőrzése.
A hiba: a függvény -t számol helyett, tehát a kétoldali Hoeffding-korlát -es szorzóját elveszíti. Következmény: az érték kisebb lesz, mint a megcélzott -hoz tartozó garantált sáv; az így jelentett konfidenciaszint hamis, mert a tényleges kudarc-korlát -nál nagyobb.
Javítás: a logaritmus argumentuma (2.0 * M) / delta
legyen:
def helyes_epsilon(M: int, n: int, delta: float) -> float:
    import math
    return math.sqrt(math.log((2.0 * M) / delta) / (2.0 * n))
Numerikus kontroll: -re a hibás érték
míg a helyes ; a hibás érték valóban kisebb. A hibás -nal számolt kudarc-korlát
ami a megcélzott kétszerese; az ellenőrzés tehát kimutatja a konfidenciaszint sérülését.
Kérdés: mennyivel kisebb egy konkrét osztályon a tényleges , mint a Hoeffding–uniókorlát értéke?
Protokoll. Rögzítsük hipotézist; a jelölthöz tartozó loss legyen Bernoulli, ahol , tehát ismert. Minden ismétlésben generáljunk független megfigyelést, minden -re a lossokat; a megfigyelési egység az ismétlésenkénti minta, a mért statisztika . A baseline a (2) képletből , , mellett:
A becsült túllépési arány
;
a standard hiba
,
amely
-nél
legfeljebb
.
A seed rögzítése (például np.random.default_rng(20261020))
biztosítja az újrafuttathatóságot.
Értelmezési korlát. A szimuláció egyetlen eloszláson mér; nem cáfolhatja az általános tételt, mert a tétel minden -beli lossra vonatkozó felső korlát. Ha jóval kisebb -nál, az a uniókorlát lazaságát szemlélteti ezen az eloszláson, nem a képlet hibáját. Alternatívák: változtatása, közös megfigyeléseken számolt veszteségek, vagy a maximális eltérés eloszlásának hisztogramja; ezek a korreláció hatását vizsgálnák, de mindegyik csak illusztráció.
A 8.1. Kockázat, mintavétel és baseline rögzített hipotézisre mondta ki a Hoeffding-korlátot; most azt egyenletessé tettük. A 7.2. Softmax és többosztályos cross-entropy cross-entropy definíciója adta a nem korlátos ellenpéldát. A 4.2. Parciális derivált és gradiens gradiensfogalma itt tudatosan nem szerepel feltételként: a statisztikai garanciához semmilyen differenciálhatóság nem kell, csak korlátosság, iid minta és véges .
Ha a hipotézisosztály véges, a rögzített hipotézisre szóló Hoeffding-korlátot uniókorláttal minden jelöltre kiterjeszthetjük: -korlátos loss és elemű iid minta esetén legalább valószínűséggel minden -ra , ahol . Ebből az ERM-hibakorlát ; ez az adaptív választás első korrekt garanciája. A korlát gyakran túl laza a gyakorlati döntéshez, mert a Hoeffding-lépés és az uniókorlát is konzervatív. Korlátlan cross-entropyra a tétel változtatás nélkül nem alkalmazható.
A 8.3. Kapacitás, regularizálás és modellválasztás a kapacitást, a regularizálást és a modellválasztást kapcsolja ehhez a korláthoz: a alak megmutatja, miért növeli a nagyobb hipotézisosztály a statisztikai hibát, és hogyan ellensúlyozhatja a korlátozott keresési tér a mintakorlátot. A következő egység ezt az elvet viszi át a gyakorlati modellválasztási döntésekre.