A Northstar prediktív projektben rendeléskor szeretnénk előre
jelezni, hogy a kézbesítés 7 napnál később érkezik-e. A célváltozó
target_late: 1, ha delivery_days > 7,
egyébként 0. A modell minden rendeléshez egy
becsült késési valószínűséget ad, amelyből egy
küszöbbel döntést képzünk: ha
,
a rendelést kockázatosnak jelöljük, és az ügyfélszolgálat előzetesen
ellenőrzi. A döntésnek kétféle hibája van: hamis pozitív (felesleges
ellenőrzés) és hamis negatív (észrevétlen késés, elégedetlen ügyfél). Az
értékelés bemenete tehát páronként az igaz target_late és a
modell pontszáma, megfigyelési egysége egy rendelés. Az elvárt
ellenőrzés: a választott metrika kézzel is reprodukálható legyen egy kis
mintán, és a döntési célhoz illeszkedjen.
Induló becslés. Tegyük fel, hogy a tesztidőszakban a rendelések 7%-a késik. Egy „mindig időben” modell accuracy-je 93%, mégis semmilyen kockázatos rendelést nem talál meg. Ez már jelzi: a csupasz accuracy önmagában nem alkalmas a döntési cél értékelésére.
Legyen kiértékelt rendelés, a tényleges késés, a küszöbölés utáni döntés. A konfúziós mátrix az igazság és a döntés kereszttáblája:
| Döntés: késik (1) | Döntés: időben (0) | |
|---|---|---|
| Ténylegesen késik (1) | TP | FN |
| Ténylegesen időben (0) | FP | TN |
Kézi kontroll: ha , ebből 70 késik, és mindenkit időben érkezőnek jelölünk, akkor , , , . Így accuracy , recall , precision pedig nem értelmezhető, mert nem jelöltünk pozitív esetet. A magas accuracy tehát csak a ritka pozitív osztály tükröződése, nem a döntés hasznossága.
Ha a cél napokban mért delivery_days becslése lenne, a
két leggyakoribb hiba:
Itt a tényleges kézbesítési napok száma, a becslés, az eredmény mértékegysége nap. A MAE lineárisan büntet, az RMSE négyzetesen, ezért utóbbi érzékenyebb a nagy tévedésekre. Ha a döntési költség arányos az eltéréssel, a MAE; ha a kiugró késések különösen költségesek, az RMSE a jobb cél.
A küszöbölés előtti valószínűséget a log loss (más néven bináris keresztentrópia) értékeli:
Itt a modell becsült értéke, . A függvény kisebb értéke jobb; a tökéletes modellnél , a mindig modellnél . A log loss erősen bünteti a magabiztos, de hibás predikciót: ha , de a modell értéket ad, a tag , míg esetén csak . Ez közvetlen kapcsolatban áll a Bayesi frissítés rácson likelihood-fogalmával: a negatív log-likelihood átlagát számoljuk, ezért a kalibrált valószínűségű modell előnyben részesül.
A ROC-görbe (Receiver Operating Characteristic) a modell pontszámaihoz tartozó összes lehetséges küszöbnél ábrázolja a
párokat. A ROC-AUC a görbe alatti terület, értéke 0 és 1 között van, a véletlen pontszámú modellé 0.5. Egyenértékű értelmezés: annak valószínűsége, hogy egy véletlenül választott késő rendeléshez nagyobb pontszámot ad a modell, mint egy véletlenül választott időben érkezőhöz; döntetlennél fél pont számít.
A ROC-AUC a küszöbtől független sorrendi jellemző. Nem mondja meg, hogy az operatív küszöbnél mennyi a precision és recall, és nem tartalmazza a kétféle hiba költségét.
A PR-görbe a recall függvényében a precision-t
ábrázolja, a PR-AUC a precision–recall görbe alatti
területet jelenti. A scikit-learn average_precision_score
függvénye azonban average precisiont (AP) számol: a
recall növekményeivel súlyozott precisionértékek összegét, nem pedig a
PR-görbe trapézszabályos integrálját. A két érték eltérhet; a további
kódpéldában AP szerepel. A precision a Bayes-féle feltételes arány miatt
függ az alaprátától:
ahol a pozitív osztály aránya. Ha kicsi, ugyanazon TPR és FPR mellett a precision alacsonyabb. A ROC-AUC a TPR–FPR párokon alapul, ezért előzetes eltolódásra (prior shift) kevésbé érzékeny; a PR-AUC viszont erősen függ tőle. Ritka kimenetelnél a PR-AUC informatívabb, mert nem engedi, hogy a sok negatív eset elfedje a pozitív esetek megtalálásának minőségét.
A példa determinisztikus, nincs véletlen seed. Nyolc rendeléshez ismerjük az igaz késési címkét és a modell becsült értékét:
import numpy as np
from sklearn.metrics import (
    confusion_matrix, accuracy_score, precision_score, recall_score,
    log_loss, roc_auc_score, average_precision_score
)

# y_true: 1 = késik, 0 = időben érkezik; p_score: P(késés) becslés
y_true = np.array([1, 0, 1, 1, 0, 0, 1, 0])
p_score = np.array([0.8, 0.4, 0.6, 0.3, 0.2, 0.7, 0.9, 0.1])
threshold = 0.5
y_pred = (p_score >= threshold).astype(int)

print("y_pred:  ", y_pred)
print("confusion (sor: pozitív, negatív):")
print(confusion_matrix(y_true, y_pred, labels=[1, 0]))
print("accuracy:  ", accuracy_score(y_true, y_pred))
print("precision: ", precision_score(y_true, y_pred))
print("recall:    ", recall_score(y_true, y_pred))
print("log_loss:  ", round(log_loss(y_true, p_score), 6))
print("ROC-AUC:   ", roc_auc_score(y_true, p_score))
print("Average precision (AP): ", round(average_precision_score(y_true, p_score), 6))
A fájlt metrics_demo.py néven a projektgyökérbe mentve a
futási parancs Linux/macOS terminálban, illetve PowerShellben:
python metrics_demo.pyA scikit-learn használt függvényei a jelenlegi stabil 1.4+ sorozatban
ugyanazt a felületet használják; az average_precision_score
a pos_label=1 alapértelmezést követi.
A kód futása előtt kézzel is ellenőrizhető a 0.5-ös küszöb. Az egyes elemekre:
| index | |||
|---|---|---|---|
| 1 | 1 | 0.8 | 1 |
| 2 | 0 | 0.4 | 0 |
| 3 | 1 | 0.6 | 1 |
| 4 | 1 | 0.3 | 0 |
| 5 | 0 | 0.2 | 0 |
| 6 | 0 | 0.7 | 1 |
| 7 | 1 | 0.9 | 1 |
| 8 | 0 | 0.1 | 0 |
Ebből , , , , tehát
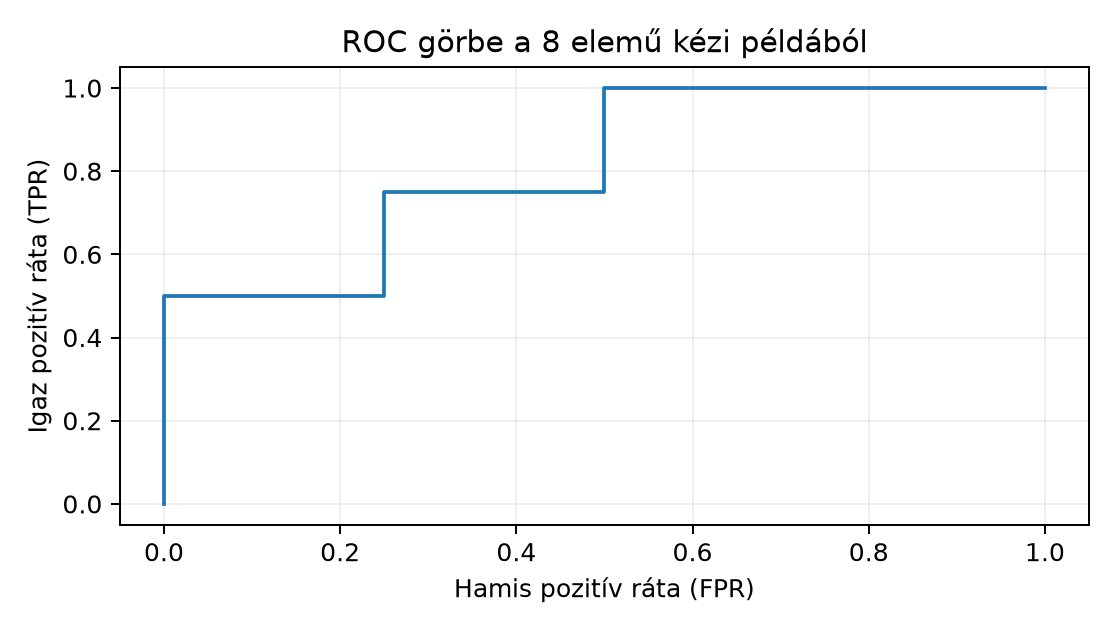
A ROC-AUC kézi ellenőrzése: a négy pozitív pontszám , a négy negatív . A pozitív–negatív pontszámpárok közül 13-ban nagyobb a pozitív pontszám, döntetlen nincs, ezért
A log loss kézi ellenőrzése: a pozitív esetekhez , a negatívokhoz tartozik, az átlagos negatív log-likelihood . A példa alapján a várható kimenet tehát:
confusion (sor: pozitív, negatív):
[[3 1]
 [1 3]]
accuracy:   0.75
precision:  0.75
recall:     0.75
log_loss:   0.510826
ROC-AUC:    0.8125
PR-AUC/AP:  0.8542
A fenti számok kézi levezetésűek; ebben a dokumentumban nem futtattuk a kódot, de helyi futtatásnál a numerikus értékek 1e-6 tűrésen belül egyeznek a levezetéssel.
A ROC-görbe lépcsős alakja is kézzel követhető a küszöb csökkentésével:
A konfúziós mátrix szerint a modell 4 késést ténylegesen tartalmazó rendelésből 3-at jelölt, és 1 időben érkezőt tévesen kockázatosnak minősített. A 0.75-ös accuracy itt kiegyensúlyozott alaprátánál () már informatívabb, de a kiinduló 7%-os késési aránynál ugyanez a döntési szabály másként viselkedne. Ha például 1000 rendelésből 70 késik, és a fenti arányokat változatlannak képzeljük, a „mindig tagadó” modell 0.93 accuracy-t adna 0 recall mellett, ezért a döntési célt recall/precision párossal kell megítélni. A log loss 0.51 kisebb a nem informatív 0.693-nál, jelezve, hogy a valószínűségek hordoznak információt; a ROC-AUC 0.81 és a PR-AUC 0.85 ugyanezt erősíti meg ezen a kis mintán. A PR-AUC itt magasabb, mint a ROC-AUC, ami kiegyensúlyozott mintán nem ritka; a két metrika eltérő skálán értékel.
A ROC AUC rangsorolási mutató, önmagában nem fejezi ki az üzleti költséget vagy a kalibrációt. Küszöböt a hamis pozitív és hamis negatív döntések várható költségének és a kapacitáskorlátnak megfelelően válasszunk.
A tesztidőszakban 1200 rendelésből 84 késik. A nullmodell mindenkit időben érkezőnek jelöl. Számítsd ki az accuracy-t, a recall-t, és indokold, miért nem használható ez a nullmodell a kockázatos rendelések előszűrésére. Mi a precision a nullmodellnél?
Adott és , küszöb . Számítsd ki kézzel a konfúziós mátrixot, az accuracy-t, precision-t és recall-t. Ellenőrizd, hogy a modell jobb-e a véletlen döntésnél.
Egy kolléga azt állítja: „A modell ROC-AUC-ja 0.96, tehát nyugodtan alkalmazhatunk 0.5-ös küszöböt, és a beavatkozás jól fog működni.” A 0.5-ös küszöbnél a konfúziós mátrix: TP=40, FN=60, TN=850, FP=50. Számítsd ki a precision-t, recall-t és accuracy-t. Mi a hiba a kolléga érvelésében? Milyen további döntési adatra lenne szükség a küszöb megválasztásához?
A Northstar-modellt egy új régióra alkalmazzuk, ahol a késési alapráta 5% a korábbi 15% helyett. Tegyük fel, hogy a modell pontszámainak osztályon belüli eloszlása nem változik, csak az alapráta csökken. Mi történik a ROC-AUC-val, és mi történik a PR-AUC-val? Magyarázd a precision Bayes-féle képletével, és adj kvalitatív választ arra, melyik metrikában jelenik meg erősebben az eltolódás.
Az alapráta . A nullmodell esetén TP=0, FP=0, TN=1116, FN=84. Ezért
A precision nem értelmezhető, mert a nullmodell egyetlen pozitív jelölést sem ad; ha mégis 0-ként akarnánk definiálni, az félrevezető, mert nem „rossz pozitív döntések arányáról”, hanem arról van szó, hogy a döntési szabály nem jelöl semmit. A cél a késések megtalálása, ezért a 0 recall azt jelenti, hogy a figyelmeztetési folyamat egyetlen késést sem előz meg. Az accuracy 0.93 önmagában tehát használhatatlan a döntési célra.
A küszöb szerint , mert a 0.55, 0.80 és 0.60 értékek nagyobb-egyenlők 0.5-nél. A címkék: . A párok: (0,1)→FP, (1,0)→FN, (1,1)→TP, (0,0)→TN, (0,1)→FP, (1,0)→FN. Tehát TP=1, FN=2, FP=2, TN=1. Ebből
A véletlen döntés kiegyensúlyozott esetben körülbelül 0.5 accuracy-t adna, tehát ez a modell a 0.5-ös küszöbnél rosszabb a véletlennél. A pontszámok sorrendje alapján a ROC-AUC ettől még lehet 0.5-nél nagyobb, de az operatív küszöbnél a döntés gyenge.
A megadott mátrixból: TP=40, FN=60, TN=850, FP=50. Így
A 0.96-os ROC-AUC csak a pontszámok globális sorrendjét jellemzi; nem garantálja, hogy a 0.5-ös küszöbnél a precision és recall elfogadható. A hibás érvelés abban áll, hogy a küszöbválasztást a görbe alatti területből vezeti le. A döntéshez legalább a hamis pozitív és hamis negatív relatív költségére, valamint a beavatkozási kapacitásra lenne szükség; ezek nélkül a 0.5-ös küszöb önkényes.
Ha az osztályon belüli pontszámeloszlások változatlanok, a ROC-görbe TPR és FPR pontjai változatlanok, ezért a ROC-AUC közelítőleg állandó marad. A PR-görbe ezzel szemben erősen eltolódik, mert a precision függ az alaprátától:
Például ugyanazon , mellett -nél a precision , míg -nél . A PR-AUC ezért lényegesen csökken az új régióban, míg a ROC-AUC nem feltétlenül. A gyakorlatban a prevalenciaváltozást külön monitorozni kell, és a küszöböt az aktuális alaprátához igazítani.
A leggyakoribb tévedés, hogy a ROC-AUC-t közvetlen döntési metrikának tekintik. Az AUC azt méri, hogy a pontszámok átlagosan jól rangsorolnak-e, nem azt, hogy a kiválasztott küszöbnél hány téves riasztás keletkezik. Konkrét ellenpélda: ugyanaz a modell és működési ponttal 15%-os késési aránynál 0.414 precision-t ad, 5%-osnál 0.174-et. A ROC-görbén mindkét helyzet ugyanazt a pontot adja, tehát a ROC-AUC nem mutatja a döntési minőség romlását. Hasonlóan félrevezető a PR-AUC abszolút értékének átvitele egyik prevalenciájú adathalmazról a másikra: a PR-AUC csak az adott alaprátán érvényes.
Ez a jelenség a Bayesi frissítés rácson alfejezetben bevezetett feltételes valószínűség közvetlen következménye: a precision a feltételes arány, amely a prior eltolódásával változik, miközben a likelihood-alapú rangsor ugyanaz marad.
A metrika kiválasztása a döntési célból indul. Az accuracy ritka eseménynél félrevezető, mert a mindig tagadó nullmodell is magas értéket érhet el; ilyenkor a recall és precision a döntés hasznosságát mutatja. Folytonos célnál a MAE lineáris, az RMSE négyzetes hibabüntetést ad. A log loss a kalibrált valószínűségek minőségét méri, a ROC-AUC a küszöbtől független rangsort. A PR-AUC ritka eseménynél informatívabb, de függ az alaprátától. A küszöbválasztás mindig külön döntés, amelyhez a hibaköltségek és kapacitások ismerete szükséges. A következő Keresztvalidáció a függőségi szerkezethez alfejezetben a keresztvalidációt igazítjuk a Northstar-idősor függőségi szerkezetéhez.