Egy kampányértékelő csapat két kis, szándékosan szintetikus
adatkészleten akarja megtanulni, mit tesz a statsmodels
GLM, ha a célváltozó nem folytonos. A bináris cél egy konverziós jelző,
a számlálási cél egy rendelési tételszám. A generáló paraméterek
ismertek, ezért a becsült együtthatókat tartalmi értelemben is
ellenőrizhetjük.
Bináris munkapélda: 600 megfigyelési egység,
minden sor egy független kampány alá vont ügyfél. Bemenetek:
variant (control vagy treatment)
és segment (consumer vagy
business). Cél: conversion
.
A generáló lineáris prediktor:
A valódi kezelési hatás ezen a skálán log odds ratio, azaz
.
Poisson munkapélda: 240 megfigyelési egység,
minden sor egy megfigyelési ablak. Bemenet: priority
().
Cél: item_count, nemnegatív egész. A generáló várható
érték:
A priority valódi multiplikatív hatása
,
tehát a kiemelt ablakokban átlagosan mintegy 35%-kal több tétel
várható.
Induló becslés, mielőtt tovább olvasna: a bináris
modell variant együtthatója várhatóan
és
közé esik, de mit jelent ez a megfigyelési skálán, és miért nem
százalékpontos különbség? A Poisson-modell priority
együtthatója nagyjából
;
hány százalékos átlagos emelkedést jelent ez az alapszintű ablakban?
A Diagnosztika és robusztus standard error OLS-modelljében az átlagos cél lineáris volt, a hibatag pedig normális eloszlású. A GLM ezt általánosítja, miközben a következő szerkezetet tartja meg:
Itt
az
-edik
megfigyelés magyarázó vektor, első eleme
,
a
darab ismeretlen együttható,
a lineáris prediktor,
pedig a linkfüggvény (link). A g
inverzével a várható értéket kapjuk vissza az eredeti kontingens skálán.
A link megválasztása az a statisztikai döntés, amely elválasztja a
normális lineáris, a logisztikus és a Poisson-modellt.
Az OLS identitáslinket használ, g(mu) = mu, normális
hibataggal,
,
ahol a variancia nem függ az átlagtól. A bináris és a Poisson-cél a link
skáláján is lineáris, de a variancia a várható érték függvénye, ezért a
szokásos lineáris modell csal.
A likelihood visszahívásához: az illesztés a log-likelihoodot,
maximalizálja. A likelihood annak a valószínűsége (illetve sűrűsége), hogy az -edik megfigyelt cél éppen , ha a modell paramétere lenne. A maximum likelihood becslés a logaritmus miatt szorzat helyett összeget optimalizál. A becslés pontbecslés; a bizonytalanságát a standard error és a konfidenciaintervallum hordozza, ugyanúgy mint IV. ellenőrző pont: korrekt statisztikai állítás alfejezetben.
A bináris célra a logit link a leggyakoribb:
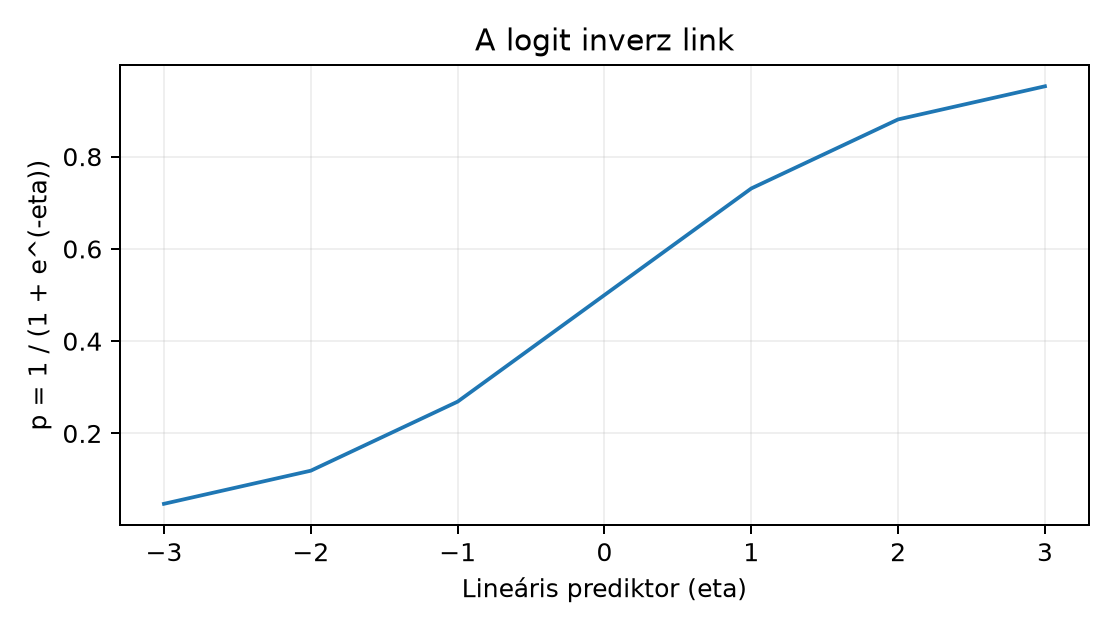
Az inverz link a logisztikus függvény:
A szomszédos ábra a függvény alakját mutatja.
Az odds a kedvező esély arány a kedvezőtlenhez:
A logit ennek természetes logaritmusa. Kis kézi kontroll: ha , az odds , a log odds . Ha , akkor , az odds és a log odds . Az együttható tehát a log odds additív változása: , ezért minden más változó rögzítése mellett az odds multiplikatív változása
Az interpretáció ezért: egységnyi prediktorváltozás az oddsot
-szeresére
változtatja. statsmodels GLM esetben a becsült
együttható a link skálán van; a predict(which="response")
adja a
valószínűséget.
A Poisson-cél a nemnegatív egész számokra illik, amikor az egy abszolút gyakoriság. A megfigyelt eloszlása:
A Poisson-ferde jelleg miatt a természetes link a logaritmus:
Így az együttható a logaritmikus skálán additív; a várható átlagra vonatkozó hatása multiplikatív:
A érték -vel való növelése százalékos átlagos emelkedést jelent. Például esetén , tehát . A Poisson-modell a varianciát is az átlaghoz köti: . Ez a kötöttség sok valós számlálási folyamatban sérül; az ilyen overdispersion hatását a deviance és a reziduális eltérések jelzik.
A likelihoodhoz tartozó deviance (eltérés) a modellt a telített modellhez viszonyítja:
A telített modell minden megfigyeléshez szabad paramétert ad, ezért a log-likelihood a lehető legnagyobb. Minél kisebb a deviance, annál jobb a modell — de a deviance önmagában nem egy 0–1 közötti jósági mutató, és függ a mintamérettől. Bináris célra a telített modell , ezért
Poisson-célra az konstans elhagyásával a szokásos számítás:
ahol a tagot -nak vesszük. A null deviance a csak interceptet tartalmazó modell deviance-a. A kettő különbsége a likelihood alapú modellösszehasonlítás alapja: ha az új prediktor a nullmodellhez képest a likelihoodot számottevően növeli, a bővített modell deviance-a kisebb. Poisson-célra a kisebb deviance a df-hez viszonyítva 1-hez közeli, ha a modell a feltételt teljesíti.
A link skálán a hatás additív, a válasz skálán általában nem. A
bináris modellben
log odds ratio, a Poisson-modellben log rate ratio. A predikció
közlésekor ezért mindig meg kell adni a skálát: a
which="linear" a lineáris prediktort, a
which="response" a várható célváltozót adja. A
konfidenciaintervallum a link skálán szimmetrikus, de a válasz skálán a
nemlineáris inverz link miatt másképp viselkedik.
Az alábbi kód seedelt numpy generátorokat használ, ezért
a generálási sorrend adott Python/NumPy környezetben reprodukálható. A
kódot a tanuló a saját gépén futtathatja; itt csak a
szemléltető, elméletileg várt kimenet szerepel, mert a
szöveggenerálás nem futtatja a kódot, és egy seed sem garantál minden
platformon bitazonos lebegőpontos véletlent.
import numpy as np
import pandas as pd
import statsmodels.api as sm
import statsmodels.formula.api as smf

# --- Bináris cél: konverzió ---
rng_bin = np.random.default_rng(20261020)
n = 600
variant = np.tile(["control", "treatment"], n // 2)
segment = np.where(rng_bin.uniform(size=n) < 0.5, "consumer", "business")
eta_true = -1.0 + 0.5 * (variant == "treatment") + 0.4 * (segment == "business")
p_true = 1.0 / (1.0 + np.exp(-eta_true))
conversion = rng_bin.binomial(1, p_true)

df_bin = pd.DataFrame({
    "variant": pd.Categorical(variant),
    "segment": pd.Categorical(segment),
    "conversion": conversion,
})

# --- Poisson-cél: tételszám kiemelt ablakonként ---
rng_pois = np.random.default_rng(7)
n2 = 240
priority = rng_pois.binomial(1, 0.4, size=n2).astype(int)
rate_true = np.exp(1.2 + 0.3 * priority)
item_count = rng_pois.poisson(rate_true)

df_pois = pd.DataFrame({
    "priority": priority,
    "item_count": item_count,
})

# Illesztés és link skálán értelmezendő együtthatók
model_bin = smf.glm(
    "conversion ~ C(variant) + C(segment)",
    data=df_bin,
    family=sm.families.Binomial(),
).fit()

model_pois = smf.glm(
    "item_count ~ priority",
    data=df_pois,
    family=sm.families.Poisson(),
).fit()

print("--- Bináris GLM, szemléltető lehetséges futás ---")
print(model_bin.params.round(3))
print("Deviance:", round(model_bin.deviance, 3))
print("Null deviance:", round(model_bin.null_deviance, 3))
print()
print("--- Poisson GLM, szemléltető lehetséges futás ---")
print(model_pois.params.round(3))
print("Deviance:", round(model_pois.deviance, 3))
print("Null deviance:", round(model_pois.null_deviance, 3))
Egy lehetséges futás szemléltető kimenete:
--- Bináris GLM, szemléltető lehetséges futás ---
Intercept                 -1.01
C(variant)[T.treatment]    0.47
C(segment)[T.business]     0.36
Deviance: 781.2
Null deviance: 807.5

--- Poisson GLM, szemléltető lehetséges futás ---
Intercept                  1.19
priority                   0.31
Deviance: 241.3
Null deviance: 255.6
A C() a formula nyelvében arra kéri a Patsy réteget,
hogy a variant és a segment oszlopokat
kategorikus változóként kezelje. A referencia szintek ábécésorrend
szerint control és consumer, ezért az
együttható a treatment és a business additív hatását adja hozzá az
intercepthez.
A link skálán adott és a válasz skálán adott predikció egyezését a modell saját paramétereiből ellenőrizzük. Bináris esetben a kézi számítás
Poisson esetben
.
A következő kód a minta minden sorára ugyanazt az eredményt várja, mint
a predict(which="response").
# Bináris kézi mátrix: Intercept, treatment, business
X_bin = np.column_stack([
    np.ones(n),
    (df_bin["variant"] == "treatment").astype(float),
    (df_bin["segment"] == "business").astype(float),
])
eta_bin = X_bin @ model_bin.params.values
p_hat = 1.0 / (1.0 + np.exp(-eta_bin))

# Poisson kézi mátrix: Intercept, priority
X_pois = np.column_stack([
    np.ones(n2),
    df_pois["priority"].astype(float),
])
eta_pois = X_pois @ model_pois.params.values
lambda_hat = np.exp(eta_pois)

# Invariáns: a kézi és a modell-predikció egyezik
assert np.allclose(model_bin.predict(which="response"), p_hat, atol=1e-10)
assert np.allclose(model_pois.predict(which="response"), lambda_hat, atol=1e-10)

# Skálatulajdonságok
assert (p_hat > 0).all() and (p_hat < 1).all()
assert (lambda_hat > 0).all()

# Deviance kézi reprodukálása
y_bin = df_bin["conversion"].values
D_bin = -2.0 * np.sum(y_bin * np.log(p_hat) + (1.0 - y_bin) * np.log(1.0 - p_hat))
y_pois = df_pois["item_count"].values
D_pois = 2.0 * np.sum(
    np.where(y_pois > 0, y_pois * np.log(y_pois / lambda_hat), 0.0)
    - (y_pois - lambda_hat)
)
assert np.allclose(D_bin, model_bin.deviance, atol=1e-8)
assert np.allclose(D_pois, model_pois.deviance, atol=1e-8)
Az assert akkor nem jelez, ha a tanuló a fenti kódot
futtatva a saját futás paramétereivel számol. A tolerancia a
lebegőpontos műveletek és a statsmodels belső optimalizálás közötti
kerekítés miatt van.
A bináris modellben az Intercept -1.01 a referencia
csoport, tehát a control és consumer csoport
becsült log oddsa. Innen
A treatment együttható log odds ratio; az odds ratio . Tehát a kezelt ügyfelek oddsa mintegy 60%-kal nagyobb, mint az azonos szegmensbe tartozó kontrollügyfeleké. A business együttható ; , tehát a business szegmensben az odds 43%-kal nagyobb. A konkrét valószínűségi növekmény ettől eltér: a treatment csoportban a consumer réteg becsült , tehát ; a növekmény a reference -hez képest százalékpont. Ugyanez a business rétegben más numerikus növekményt adhat, mert a hatás a válasz skálán nem konstans: , .
A Poisson-modell priority együtthatója
log rate ratio;
.
A kiemelt ablakokban a várható tételszám a nem kiemelthez képest
36,3%-kal nagyobb. Az alapablak várható tételszáma
;
a kiemelt ablaké
.
A predikció a válasz skálán tehát nem az együttható hozzáadásával, hanem
az exponenciális linkkel kapható meg.
A deviance a bináris példában a nulldeviancához képest kisebb, de önmagában nem jelenti azt, hogy a modell „jól” magyarázza a konverziót. A Poisson-példában a modell deviance a reziduális szabadságfokkal ; ez az 1 körüli eltérés azt jelzi, hogy a generálás pontosan Poisson, tehát a szórásfeltétel ezen a kis szintetikus mintán nem sérül durván.
A konfidenciaintervallumok a link skálán szimmetrikusak; a válasz
skálán a végpontok inverz linkkel transzformáltak. A
get_prediction().summary_frame() kimenete ezt a válasz
skálán jeleníti meg, ezért a mean oszlop a
-t
vagy
-t
tartalmazza, a csúcsok pedig a megadott névleges szintű
intervallumot.
GLM-ellenőrzés: binomiális logitnál az együttható log-odds skálájú, exp(β) esélyhányados, nem kockázati arány. Poisson-modellnél az exp(β) feltételes várható számlálás aránya; a túlzott diszperzió ellenőrzése nélkül a standard hibák félrevezetők lehetnek.
Értelmezés. Egy másik bináris GLM-illesztés paraméterei: Intercept , treatment . (a) Számítsa ki a kezelt és a kontroll csoport becsült valószínűségét. (b) Számítsa ki az odds ratio-t, a kockázati arányt és a százalékpontos különbséget. Melyik egyenlő az értékkel?
Implementálás. A fenti model_bin
modellt használva kérje le a
get_prediction().summary_frame(alpha=0.05) egy oszlopát a
válasz skálán. Ellenőrizze, hogy a mean oszlop numerikusan
illeszkedik a kézzel számolt p_hat tömbhöz, és a
mean_ci_lower/mean_ci_upper oszlopok a
tartományba esnek. Miért nem feltétlenül szimmetrikus a CI a
mean körül?
Hibadiagnózis. Egy kolléga a Poisson-modell
priority együtthatóját,
-et,
így értelmezi: „a kiemelt ablakokban
plusz tétel van”. Nevezze meg a hibát, javítsa ki, és mutassa meg
számszerűen, miért függ az abszolút többlet az alapszinttől.
Megváltozott feltétel. Az adatgyűjtés
megváltozik: minden sor egy ügyfél, de a megfigyelési ablak hossza nem
azonos; a táblában events a megfigyelt események száma,
days pedig a megfigyelési napok száma. A cél a napi
eseményráta kezelés előtti és utáni aránya. Adjon meg
statsmodels formulás GLM-et a megfelelő offsettel,
magyarázza, miért log offset kell, és adja meg az ellenőrző
invariánst.
1. megoldás. Az intercept a kontrollcsoport log oddsa: , tehát . A kezelt csoport , . Az odds ratio , ez az egyetlen, ami közvetlenül az exponenciális együtthatóval egyenlő. A kockázati arány ; a százalékpontos különbség , azaz százalékpont. A valós generáló hatás ezen a konkrét ponton ezért nem és nem valószínűségnövekedés.
2. megoldás.
frame_bin = model_bin.get_prediction().summary_frame(alpha=0.05)

# Invariáns: a summary_frame mean oszlopa a response skálán van
assert np.allclose(frame_bin["mean"].values, p_hat, atol=1e-10)
assert frame_bin["mean_ci_lower"].between(0, 1).all()
assert frame_bin["mean_ci_upper"].between(0, 1).all()

# A link skálán definiált intervallum a nemlineáris inverz link miatt
# a válasz skálán csak akkor lesz pontosan szimmetrikus, ha p = 0.5.
print(frame_bin[["mean", "mean_ci_lower", "mean_ci_upper"]].head(3))
A bináris modellben a link skálán az intervallum ugyanolyan széles a
pont körül, de az inverz logit balról jobbra lapos, ezért a
körüli távolság a válasz skálán a tartomány belsejében eltérő. A konkrét
statsmodels verzió summary_frame viselkedését a tanulónak
érdemes a saját környezetében
help(model_bin.get_prediction().summary_frame) paranccsal
ellenőriznie; az állítás maga a skálatranszformáció matematikája.
3. megoldás. A hiba háromszoros. Először is az együttható a logaritmikus link skálán van, ezért önmagában nem az események átlagos számához adódik. Másodszor a link inverze miatt a hatás multiplikatív: , azaz a várható tételszám -kal nagyobb. Harmadszor az abszolút többlet a baseline rate függvénye. Ha a nem kiemelt ablak várható tételszáma , akkor a kiemelt várható érték , a többlet tétel. Ha a baseline , akkor a kiemelt várható , a többlet . Az additív ezért semmilyen ponton nem helytálló a válasz skálán.
4. megoldás. Ha a megfigyelési ablak hossza
days, akkor a Poisson-modell várható eseményszáma
Logaritmálva:
A tag ismert konstans, ezért a modellbe offsetként kerül. A megoldás mintapéldája:
rng4 = np.random.default_rng(11)
n4 = 180
treatment = rng4.binomial(1, 0.5, size=n4)
days = rng4.choice([1, 3, 7], size=n4)
rate4 = np.exp(0.0 + 0.2 * treatment)
events = rng4.poisson(rate4 * days)
df4 = pd.DataFrame({"treatment": treatment, "days": days, "events": events})

model4 = smf.glm(
    "events ~ treatment",
    data=df4,
    family=sm.families.Poisson(),
    offset=np.log(df4["days"]),
).fit()

# Invariáns: a várható events egyenlő days * exp(eta)
X4 = np.column_stack([np.ones(n4), treatment.astype(float)])
eta4 = X4 @ model4.params.values
expected_events = df4["days"].values * np.exp(eta4)
assert np.allclose(model4.predict(which="response"), expected_events, atol=1e-8)

# A napi ráta aránya a kezelés esetén:
rr = np.exp(model4.params["treatment"])
print("becsült napi rate ratio:", round(rr, 3))
Az offset nélkül a modell a nyers eseményszámot magyarázná, és a
hosszabb ablakok nagyobb célértéke a kezeléshez nem kapcsolódó hatást
torzítaná. A predict(which="response") itt a várható
eseményszámot adja; a várható napi ráta
.
A becsült treatment együttható a napi ráta log aránya, a
rate ratio pedig a megfelelő exponenciális.
A leggyakoribb félreértés: az odds ratio nem kockázati arány és nem százalékpontos különbség. Példa: és . Ekkor , , ezért . A kockázati arány , a százalékpontos különbség százalékpont; egyik sem és nem . Más induló szintnél ugyanez az OR más abszolút különbséget ad. Ez ugyanaz a skálaugrás, mint amikor az IV. ellenőrző pont: korrekt statisztikai állítás kísérleti összefoglalójában a kockázati különbség volt a primer hatás; a logisztikus regresszióban viszont az OR a természetes interpretációs skála.
A Diagnosztika és robusztus standard error
robusztus standard hibájának logikája itt is érvényes: a p-érték a
nullmodell szerinti feltételes szélsőség, nem a paraméter igaz
valószínűsége. A cov_type="HC0" változat a GLM-ben is
kérhető, de a modell szerkezeti feltételeit nem cseréli le. A bináris és
Poisson GLM korlátja, hogy a variancia nem szabad paraméter; ha a
Poisson-eloszlás szórása a gyakorlatban nagyobb, a szokásos
Wald-intervallum túl optimista lehet, és a deviance-t sem szabad
-ként
olvasni.
Az eredmény akkor helyes, ha (1) a
predict(which="response") a bináris modellnél a
tartományban, a Poissonnál pozitív tartományban marad; (2) a kézi
és
np.allclose módon illeszkedik; (3) a modell deviance nem
nagyobb, mint a null deviance, mert a bővített modell likelihoodja
legalább akkora; (4) minden értelmezés megnevezi, hogy log oddsról, odds
ratio-ról, kockázati arányról vagy válasz-skálás átlagról van szó.
A GLM a lineáris prediktort linkfüggvénnyel kapcsolja a cél várható értékéhez. A bináris célhoz tartozó logit link a log oddsot modellezi, ezért az együttható exponense odds ratio; a Poisson-cél logaritmusos linkje a várható eseményszámot, az együttható exponense pedig rate ratio-t ad. A deviance a likelihood összehasonlító mértéke, de önmagában nem abszolút jósági mutató. Az értelmezést mindig az adott skálán kell megadni. A következő alkalmazásban ezt a GLM-keretet oksági kísérleti értelmezéssel kötjük össze, ahol a kontrollváltozók és a randomizálás szerepe egészíti ki a becslést.