A 31.3. Diffúziós zajmodell és CNN-denoiser egységben a diffúziós zajmodellt, a feltételes denoisert és a mintavételezési sémát építettük fel. Ott a generált minta még csak egyetlen realizáció volt; most azt vizsgáljuk, mit jelent egy generatív modell eloszlását jónak nevezni. A likelihood, a mintaminőség, a változatosság, a memorizáció és a származás öt különböző kérdés, amelyeket nem szabad egyetlen pontszámba mosni. Az induló kérdés: ha egy modell egyetlen, emberi szemmel tökéletesnek tűnő képet állít elő, bizonyítja-e ez, hogy a modell jól közelíti a valódi adateloszlást? A válasz nem, és ezt formális ellenpéldával is igazolni fogjuk.
Visszautalás: a 30.4. Önfelügyelt kísérlet korrekt összevetése erőforrás-könyvelése azt tanította, hogy a módszerhatást csak azonos költségkeret mellett lehet értelmezni; ugyanez a fegyelem kell a generatív modellek összehasonlításához is. A 27.4. Instance mask és összetett feladat instance-felosztási ellenpéldája azt mutatta, hogy egyetlen aggregált pixelmetrika elfedi a szerkezeti hibát; a generatív értékelésben is hasonló a helyzet. A 19.4. ConvNeXt és a recept/architektúra elválasztása recept/architektúra szétválasztása pedig arra figyelmeztet, hogy az értékelési protokollt a modellválasztás előtt kell rögzíteni.
Legyen a megfigyelési tér a képek halmaza; a valódi, ismeretlen adateloszlást , a generátor által indukált eloszlást pedig jelöli. Egy generált batch alakja , ahol a batchméret, a csatornaszám, a térbeli méretek; a GlyphLab esetén , . A generált minták függetlenek, ha a mintavételi folyamat minden mintát azonos eloszlásból, függetlenül húz.
A teszt log-likelihood (átlagos log-sűrűség) egy elemű, a modelltől független tesztmintán:
A bit-per-dimension (BPD) ennek normált változata: , ahol a dimenziószám és a természetes logaritmus. A likelihood a sűrűségmodellt méri: azt, hogy a modell mekkora valószínűségi tömeget rendel a tesztadathoz. A mintaminőség (sample quality) ezzel szemben egy realizált minta vagy mintahalmaz emberi vagy automatikus bíráló által adott minőségi pontszáma; ez nem a likelihood függvénye, és a kettő nem ekvivalens.
A Fréchet Inception Distance (FID) a valódi és generált minták egy köztes reprezentációjában számolt Gauss-közelítésen alapul. Ha a reprezentációban a valódi minták átlaga , kovarianciája , a generáltaké , akkor a Fréchet-távolság:
ahol a mátrixszorzat egyértelmű pozitív szemidefinit négyzetgyöke. Az 1-dimenziós speciális esetben , , és a kifejezés alakra egyszerűsödik, feltéve, hogy .
A változatosságot (diversity) a generált halmaz belső szóródásával mérjük. Egy elemű halmazra a páronkénti átlagos L2 távolság:
ahol az összegzés az dimenziós vektorok euklideszi normáját használja. A lefedettség (coverage) azt méri, hogy a valódi eloszlás támogatásának mekkora része van reprezentálva; egy egyszerű proxy: a valódi tesztminták hányadához létezik -nál közelebbi generált minta.
A memorizáció heurisztikus definíciója: egy generált minta -szinten memorizált, ha
ahol a tanítóhalmaz és az adateloszlásból származtatott küszöb. A származás (provenance) nem numerikus metrika, hanem dokumentációs követelmény: adatforrás, licenc, modellarchitektúra, súly-hash, generálási seed, szoftververzió és időbélyeg rögzítése.
A két fogalom nem felcserélhető. Egy nagy varianciájú Gauss-modell, amely az egész mintateret elkeni, viszonylag nagy likelihoodot adhat a tesztpontokra, de mintái homályosak, alacsony kontrasztúak. Fordítva, egy éles, “látványos” mintákat adó generátor elhagyhatja a valódi eloszlás teljes móduszait, ezért likelihoodja a kihagyott pontokban nulla (illetve log-likelihoodja ). A likelihood tehát a lefedettség irányában érzékeny, a mintaminőség pedig a realizmus irányában.
A következő lemmát az egyszerűség kedvéért véges mintatéren mondjuk ki, ahol a valószínűségi eloszlások tömegfüggvények.
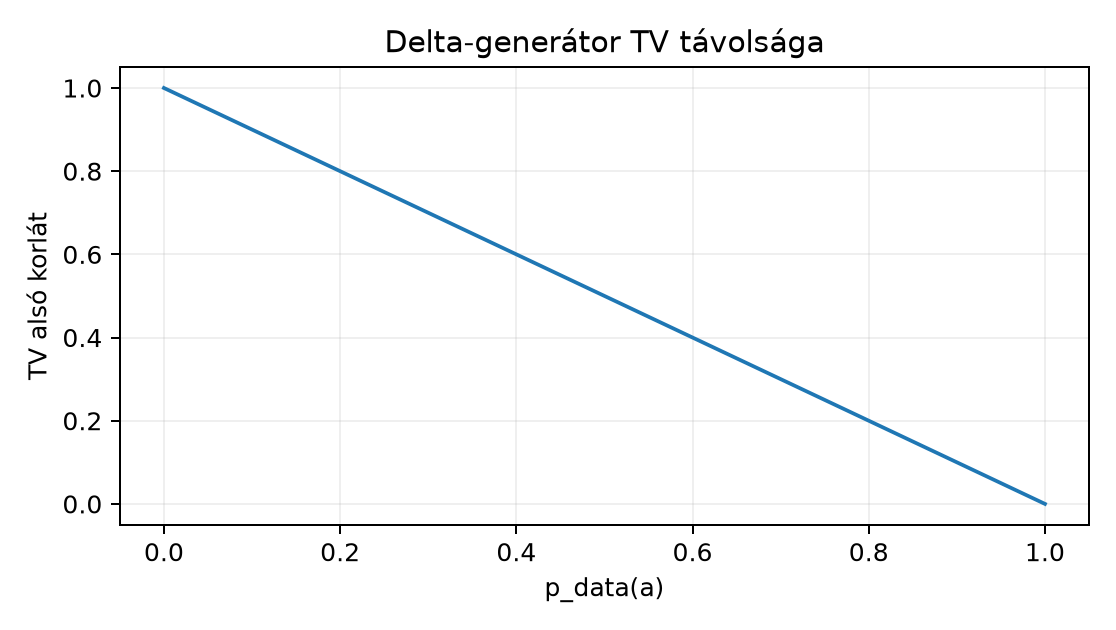
Lemma (delta-generátor ellenpélda). Legyen olyan eloszlás -en, amelynek legalább két különböző pontja van pozitív tömeggel, és legyen a Dirac-delta egy pontra. Ekkor:
Bizonyítás. (1) A teljes variációs távolság definíciója . Válasszuk az eseményt. Ekkor , míg , mert a delta-eloszlás teljes tömege -ban van. A szuprémum legalább ekkora, tehát . A feltétel szerint , így a jobb oldal pozitív.
Következmény: ha a generátor mindig ugyanazt a vizuálisan tökéletes képet adja, akkor az egyetlen realizált minta “látványos” lehet, miközben a generátor eloszlása maximális távolságra van a valódi eloszlástól minden olyan esetben, ahol a valódi eloszlás nem koncentrálódik egyetlen pontra. A mintaminőség tehát nem azonos a modellminőséggel.
Ezt az összefüggést szemlélteti a következő, a lemmából számított diagram:
A FID a valódi és generált eloszlások közötti Fréchet-távolságot egy köztes reprezentációban számítja, és a két eloszlást Gauss-eloszlással közelíti. Ebből három korlát következik.
Gauss-feltevés. A FID csak az első két momentumot használja. Két eloszlás, amelynek azonos az átlaga és a kovarianciája, a FID szerint megkülönböztethetetlen, még akkor is, ha a magasabb momentumok vagy a támogatás szerkezete alapvetően eltér.
Reprezentációfüggés. Az “Inception” hálózat egy adott osztályozási feladaton tanult hálózat; a FID az általa definiált feature-térben mér. Egy másik hálózat vagy egy finomhangolt változat más FID-et adhat ugyanazokra a mintákra. A FID nem feladatfüggetlen képminőség-mérték.
Véges mintás becslés. A gyakorlatban és véges mintából becsült mennyiségek. A FID becslése torzított és nagy varianciájú lehet, különösen kevés generált minta esetén; egyetlen FID értékhez ezért mindig meg kell adni a mintaméreteket, a seed-eket és ismételt becslések szórását. Egyetlen seed FID értéke nem megbízható modellminősítés.
A FID további korlátja, hogy a mátrix-négyzetgyök numerikusan érzékeny lehet, ha a kovarianciamátrixok közel szingulárisak.
A diversity hiánya akkor is fennállhat, ha a FID alacsony. Például ha a generátor a valódi eloszlás átlagát és kovarianciáját pontosan reprodukálja Gauss-közelítésben, a FID nulla lehet, miközben a generált minták tényleges halmaza egyetlen pontból áll. Ezért a FID mellett független diversity-mutatót kell számolni, például a páronkénti átlagos távolságot, és azt a valódi tanítóhalmaz ugyanilyen mutatójával összehasonlítani.
A memorization ellenőrzése azért fontos, mert a generátor a tanítóhalmazt másolhatja új minta helyett. A fenti -küszöbös definíció heurisztikus: az megválasztása adatfüggő. Jó gyakorlat a tanítóhalmaz páronkénti L2 távolságainak alsó percentiliséből származtatni -t, így a küszöb a tényleges adatsűrűséghez igazodik. A memorizáció detektálása nem bizonyítja a szándékos másolást, de jelzi az általánosítási kockázatot. Az adatvédelmi következményeket külön kell kezelni; a definíció nem jogi fogalom.
A provenance a generált műtárgyhoz tartozó metaadat. Minimális mezők: a generátor modell architektúrája és súlyainak SHA-256 hash-e, a tanítóadat forrása és licence, a generálási seed és konfiguráció, a szoftververzió, valamint a generálás időpontja. A provenance nélkül egy generált kép tudományos vagy üzleti felhasználása nem reprodukálható és nem auditálható.
A következő kód a fenti definíciókat számítja ki egy diszkrét háromosztályos példán, ahol a valódi eloszlás , a generátor pedig delta-eloszlás az A osztályon. A kód nem igényel külső mélytanulási könyvtárat.
# munkakönyvtár: lab/n124/
# n124_szamitott_pelda.py
# Számított példa; a kézirat írásakor nem futtattuk.
import numpy as np

# Diszkrét eloszlások: A=0, B=1, C=2
p_data = np.array([0.5, 0.3, 0.2], dtype=np.float32)
p_gen = np.array([1.0, 0.0, 0.0], dtype=np.float32)

# Teljes variációs távolság
tv = 0.5 * np.sum(np.abs(p_data - p_gen))
print(f"TV = {tv:.6f}")

# KL(p_data || p_gen); a p_gen=0 tagok +inf-et adnak
finite_mask = p_gen > 0
finite_part = np.sum(p_data[finite_mask] *
                     np.log(p_data[finite_mask] / p_gen[finite_mask]))
print(f"KL véges része = {finite_part:.6f}; teljes KL = +inf")

# 1D FID proxy: valós és generált embedding statisztikák
mu_r, sigma_r = 2.5, np.sqrt(1.25)   # valós: 1,2,3,4 átlaga és szórása
mu_g, sigma_g = 2.5, 0.0             # generált: mind 2.5
fid_1d = (mu_r - mu_g) ** 2 + (sigma_r - sigma_g) ** 2
print(f"FID_1D = {fid_1d:.6f}")

# Diversity proxy: páronkénti egyezés egy 4 elemű generált halmazon
samples = np.array([0, 0, 0, 0], dtype=np.int64)
pairs_equal = np.mean([samples[i] == samples[j]
                       for i in range(len(samples))
                       for j in range(i + 1, len(samples))])
print(f"Páronkénti egyezés = {pairs_equal:.3f}; "
      f"diversity proxy = {1 - pairs_equal:.3f}")
A kód várható, kézzel is ellenőrizhető kimenete: ; a KL véges része , a teljes KL pedig ; a FID_1D ; a páronkénti egyezés , tehát a diversity proxy . A kimenet jelölt számított példa, nem mért futás.
A feladat egy kis generatív kísérlet tervének elkészítése, előre rögzített értékeléssel, adat- és súlyforrással. Az alábbi terv a GlyphLab adatán (lab/ADATOK.md) alapul, és a kötelező főutat követi: kis CPU, eredeti adatok, külső súly nélkül.
Adatforrás. lab/data/images.npy,
lab/data/labels.npy, lab/data/metadata.csv. A
generatív modellt kizárólag a train split 240 képén tanítjuk; a val (60
kép) és a test (60 kép) kizárólag értékelésre szolgál. A scene_id
szerinti csoportosítást megőrizzük: ugyanazon jelenet két nézete
ugyanabba a splitbe tartozik.
Modell és súlyforrás. Egy kis VAE vagy diffúziós denoiszer a 31.1. VAE és variációs alsó korlát és 31.3. Diffúziós zajmodell és CNN-denoiser definíciói szerint. Az architektúra: encoder Conv2d(1→8, 3×3, stride 2), Conv2d(8→16, 3×3, stride 2), majd lineáris réteg egy 16 dimenziós latens térbe; a dekóder ennek tükörképe. A súlyokat saját tanítással állítjuk elő: seed=20261020, Adam lr=1e-3, batch=32, 200 epoch, float32 CPU, checkpoint a legjobb val rekonstrukciós MSE alapján. A modellválasztás után egyszer futtatjuk a tesztet.
Értékelési szerződés (a tanítás előtt rögzítve).
Ez a terv szemléltető protokoll; a kézirat írásakor nem futtattuk, ezért mért FID, diversity vagy memorizációs számot nem állítunk.
F1 (fogalmi, nehézség 1). Magyarázza el, miért nem bizonyítja egyetlen látványos generált kép a generátor jó eloszlásmodelljét. Adjon konkrét ellenpéldát a lemmából.
F2 (levezetési, nehézség 2). Legyen , , . Számolja ki a TV távolságot, a KL-divergenciát (ahol értelmezhető), és a delta-generátor diversity proxyját egy 5 elemű generált halmazra.
F3 (implementációs, nehézség 2). Írjon Python-függvényt, amely két 1-dimenziós embeddinghalmazra (, ) kiszámítja az 1D FID proxy-t: . Tesztelje a fenti példán (valós ; generált mind ). Adja meg a várt eredményt és a numerikus toleranciát.
F4 (hibakeresési, nehézség 2). Az alábbi kód a memorizációs küszöböt akarja meghatározni, de hibás:
# hibás vázlat
def memorized_ratio(gen, train, eps_fraction=0.05):
    # train: (N, D) float32; gen: (M, D) float32
    D = train - train[:, None, :]          # helytelen broadcasting
    flat = np.linalg.norm(D, axis=-1)
    eps = np.quantile(flat, eps_fraction)
    return np.mean(np.min(np.linalg.norm(gen[:, None, :] - train[None, :, :], axis=-1), axis=1) <= eps)
Lokalizálja a hibát, magyarázza el a következményét, és írja meg a javított változatot. Ellenőrizze egy kis méretű mesterséges adaton.
F5 (kísérlettervezési, nehézség 3). Tervezzen értékelési protokollt egy külső, előtanított generatív modell memorizációjának mérésére 10 000 képből álló saját tesztkörnyezetben. Adja meg az adatforrást, a küszöbválasztást, a kontrollcsoportot és a következtetési korlátot. A terv nem igényelhet futtatást, de a döntési pontokat explicit módon kell tartalmaznia.
F1 megoldás. Az egyetlen látványos minta csak egyetlen pont a mintatérből; a generatív modell minősége az eloszlás egészére vonatkozik. A delta-generátor lemmája szerint ha , akkor . Ha a valódi eloszlás valószínűséggel más osztályokat tartalmaz, a TV legalább , ami a maximális -hez közeli rossz érték, miközben az minta önmagában tökéletesnek látszhat. A mintaminőség tehát szükséges, de nem elégséges feltétel.
F2 megoldás. TV: . KL: , mert két tag végtelen. A generált 5 elemű halmaz mind a 0 osztályt adja, ezért a páronkénti egyezés , a diversity proxy . Alakellenőrzés: a TV -ben van, a KL nemnegatív vagy végtelen; a diversity proxy -ben van.
F3 megoldás.
import numpy as np

def fid_1d(r, g):
    """1D FID proxy: (mean_r-mean_g)^2 + (std_r-std_g)^2."""
    r = np.asarray(r, dtype=np.float32)
    g = np.asarray(g, dtype=np.float32)
    mu_r, mu_g = r.mean(), g.mean()
    sigma_r, sigma_g = r.std(), g.std()  # population std, ddof=0
    return (mu_r - mu_g) ** 2 + (sigma_r - sigma_g) ** 2

r = np.array([1, 2, 3, 4], dtype=np.float32)
g = np.full(5, 2.5, dtype=np.float32)
print(f"FID_1D = {fid_1d(r, g):.6f}")
Várt eredmény:
,
,
,
,
tehát
.
Tolerancia:
float32 esetén a szórás számítása miatt; ha a library
ddof=1-et használ, a várt érték megváltozik, ezért a
megoldás ddof=0-át explicit módon kell beállítani, vagy a
függvény dokumentációjában jelezni.
F4 megoldás. Az első hiba:
D = train - train[:, None, :] helytelenül próbál páronkénti
különbséget képezni, de a broadcasting rossz: train alakja
,
train[:, None, :]
,
így a kivonás
-t
adhat, de a kód a flat változóval a normát a teljes
tenzoron veszi, ami nem a páronkénti távolságokat adja, és a
quantile rossz dimenzióra vonatkozik. Helyes változat:
def memorized_ratio(gen, train, eps_fraction=0.05):
    # train: (N, D) float32; gen: (M, D) float32
    pair_train = np.linalg.norm(
        train[:, None, :] - train[None, :, :], axis=-1)
    # a diagonális nulla; levesszük vagy bent hagyjuk,
    # de a percentilis számításánál a nullák torzíthatnak
    iu = np.triu_indices(train.shape[0], k=1)
    dist_train = pair_train[iu]
    eps = np.quantile(dist_train, eps_fraction)
    dist_gen = np.linalg.norm(
        gen[:, None, :] - train[None, :, :], axis=-1)
    return np.mean(np.min(dist_gen, axis=1) <= eps)
A javítás ellenőrzése: ha train = [[0,0],[1,0],[0,1]]
float32, akkor a páronkénti távolságok
,
az 5. percentilisük
;
ha a generált halmaz [0.1,0.1], akkor a minimális train
távolság
,
ami
,
tehát a memorized_ratio
.
A hibás kód ezt nem adná.
F5 megoldás. A terv vázlata: (1) adatforrás: egy nyilvános, licenc szempontból újrafelhasználható képgyűjtemény 10 000 képpel, hash-elt azonosítókkal; (2) a generatív modell rögzített checkpointja, az általa előállított 10 000 generált kép; (3) küszöbválasztás: a tanítóhalmaz páronkénti L2 távolságainak 1. percentilise a pixel- vagy feature-térben, hogy a természetes sűrűséghez igazodjon; (4) kontroll: egy független, nem tanított halmaz (például nyilvános tesztkészlet) páronkénti távolságai, és annak az aránya, hogy a kontrollképek hány százalékához van -nál közelebbi tanítókép; (5) döntési pont: a memorizációs arányt a kontroll arányához viszonyítva értelmezzük, nem abszolút küszöbként; (6) korlát: a mérés heurisztikus, nem bizonyít szándékos másolást, és az választása befolyásolja az eredményt; a következtetés csak a rögzített protokollra érvényes. A terv nem állít mért eredményt.
A leggyakoribb tévhit, hogy a generált minta automatikus tény: ha a generált kép emberi szemmel valószerű, akkor a modell “megtanulta az eloszlást”. A delta-generátor ellenpélda ezt cáfolja: a generált minta lehet tökéletes, miközben az eloszlás TV távolsága pozitív, sőt a KL divergenciája végtelen. Hasonló tévhit az, hogy egyetlen generatív metrika teljes minőségítéletet ad; a FID nem méri a memorizációt, a likelihood nem méri a vizuális élességet, a diversity pedig nem méri a realizmust. Csak több, előre rögzített metrika együttes jelentése lehet érvelés alapja.
Önellenőrzés: a TV mindig -be esik; a KL nem szimmetrikus, és ha a generátor támogatása nem fedi a valódi eloszlás támogatását, a végtelen; az 1D FID nemnegatív, és nulla csak akkor, ha az átlagok és a szórások is egyeznek. A memorizációs küszöbnek adatfüggőnek kell lennie; egy rögzített, az adattól független félrevezető.
Visszahívás: a 30.4. Önfelügyelt kísérlet korrekt összevetése erőforrás-könyvelése azt követeli, hogy a generatív összehasonlításokban is rögzítsük a címke- és számítási költségkeretet; a FID proxyhoz használt PCA illesztése a train halmazhoz tartozik. A 27.4. Instance mask és összetett feladat instance-ellenpéldája azt mutatta, hogy egy aggregált metrika elrejtheti a szerkezeti hibát, ezért a generatív értékelésben is szükség van a diverzitás és a lefedettség külön mérésére.
A generatív modellek értékelése többdimenziós: a likelihood a sűrűségmodellt, a mintaminőség a realizált outputot, a diversity a változatosságot, a memorizáció a tanítóadat-másolást, a provenance pedig a származás dokumentálását méri. Egyetlen látványos kép nem bizonyítja a jó eloszlásmodellt: a delta-generátor ellenpéldában a TV távolság pozitív, a KL pedig végtelen, miközben a minta tökéletesnek tűnhet. A FID Gauss-közelítése és véges mintás becslése további korlátokat jelent. A laborterv a GlyphLab adatán előre rögzített FID-pixel-PCA proxy, diversity és memorizációs küszöb protokollját adja, mért eredmény nélkül.
A 32.1. Szekvenciamodell és változó hossz szekvenciamodellekre lép át. A generatív értékelés itt bevezetett szétválasztása közvetlenül érvényes lesz a nyelvi modellekre is: a likelihood (perplexity), az emberi mintaminőség, a diversity és a memorizáció ott is külön mérőszám, és a provenance a szöveges modelleknél ugyanúgy kötelező.