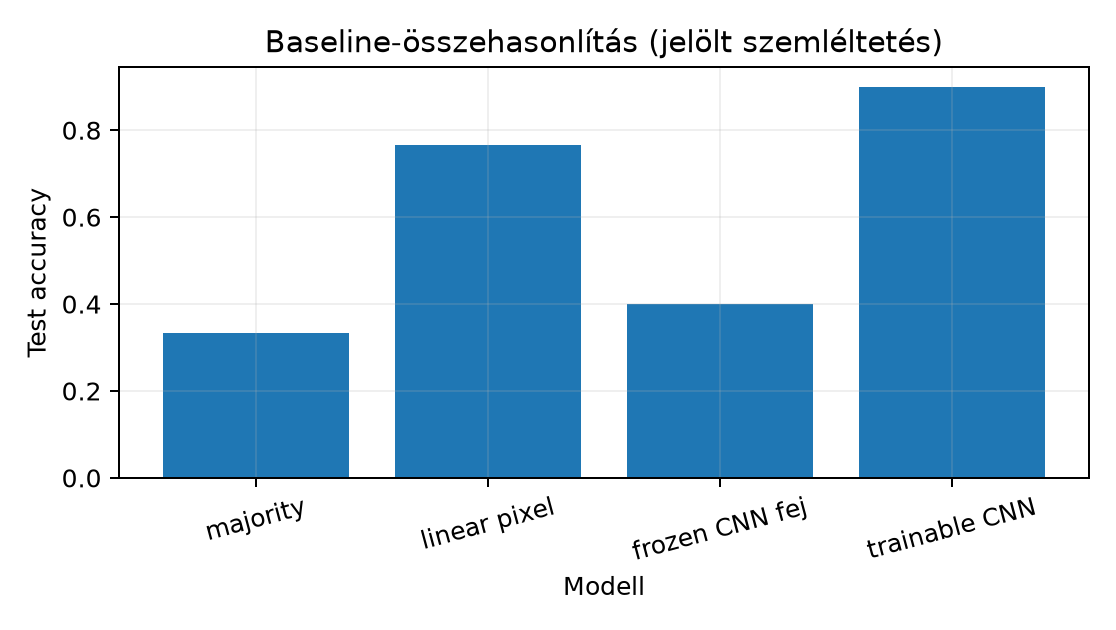
Ez az egység azt a mérnöki kérdést rendezi szerződésbe, hogy egy CNN milyen referenciapontokhoz képest nevezhető jobbnak kis, saját adaton. Előismeret a 25.2. Multilabel és hierarchikus cél alfejezetből: a kölcsönösen kizáró osztályokhoz softmax és int64 osztályindex-cél tartozik, a multilabel BCE ettől különböző feladat. Visszahívjuk a 24.3. Mixed precision és nagyobb batch alfejezetből, hogy f32 CPU-n teljes batch esetén nincs szükség gradiensakkumulációra, a 21.3. Dropout, súlyregularizálás és augmentáció alfejezetből, hogy a regularizálás nem univerzális győzelmi trükk, a 13.3. Lokális szűrők és tanult reprezentáció alfejezetből pedig, hogy a szűrőtanulás lokális feature mapokat hoz létre.
Induló becslés. A kezdő GlyphLab adat kiegyensúlyozott: trainen osztályonként 80, val/testen 20–20 kép van. A többségi osztályt tippelő modell tehát körülbelül testpontosságot ér el; a lineáris pixelmodell ennél többet tudhat, mert a három orientáció képstatisztikája eltérő. Egy kis CNN előnyét csak akkor érdemes állítani, ha a két egyszerűbb referencia fölé megy, és a mérés a val–test protokollt betartja.
Majority classifier. Legyen a tanító célvektor . A tanító osztálygyakoriság
A majority classifier minden bemenetre ugyanazt az osztályt adja:
Ez a definíció döntetlen esetén hiányos, ezért rögzítjük a könyv konvencióját: ha több maximális gyakoriságú osztály van, a legkisebb indexet választjuk. A GlyphLab train kiegyensúlyozott, tehát minden -ra, és a döntetlen-szabály a 0 osztályt adja. A test is kiegyensúlyozott, ezért a várhatóan használt pontosság itt nem becsült zaj, hanem a felépítésből következő determinisztikus érték. A modellnek nulla tanulható paramétere van; ez benchmark-padló, nem előrejelző rendszer.
Linear pixel baseline. A bemeneti kép , intenzitás , float32 NCHW. A pixelmodell először ellapítja a képet elemű vektorrá, majd egy affin réteget alkalmaz:
A tanításhoz [D07] szerint logits bemenetű cross-entropy-t használunk, int64 céllal, softmax nélkül a modell végén. Ez ekvivalens egy magméretű, 576 bemeneti és kimeneti csatornás konvolúciós réteggel: nincs lokális recepciós mező, csak csatornánkénti lineáris pontozás. A paraméterszám . A modell képes megtanulni minden lineárisan szeparálható pixelkombinációt, de nem tudja a képen belüli eltolást vagy lokális mintázatot reprezentálni.
Frozen features. Rögzítsünk egy feature-extractort, például egy CNN konvolúciós törzsét. A kimenet . A tanulható fej ekkor , ahol , . A „frozen” azt jelenti, hogy -t a tanítás során konstansnak tekintjük: a fej paramétereit frissítjük, a törzs paramétereit nem. Ez a transzfertanulás egyik szélső ága: külső vagy véletlen súlyú törzsből kinyert jellemzőkre lineáris osztályozót tanítunk. A másik ág a finomhangolás, ahol -t és -t együtt frissítjük, általában kisebb tanulási rátával.
A reprezentáció–classifier elválasztó összehasonlítás. A következő lemma pontosan megadja, mely gradiens-tagok különböztetik meg a fej tanulását a reprezentáció tanulásától.
Lemma (fej–törzs gradiens egy batch-lépésben). Legyen , és differenciálható veszteség. Legyen , és jelölje . Ha a könyvtár gradienskonvenciójával differenciálható (a ReLU töréspontokon a 9.4. Aktivációk és gradiensáramlás alfejezetben rögzített konvencióval), akkor
és a 4.3. Jacobi-mátrix, láncszabály és VJP Jacobi-oszlopkonvencióval, mellett
Levezetés. A logitok . Rögzített mellett , ezért a láncszabályból
tehát . A biasra , így . A -függés csak -en át lép be; a -gradiens a lineáris fej VJP-je, , majd a 4.3. Jacobi-mátrix, láncszabály és VJP láncszabály adja a alakot. Az átlag linearitása hozza a batch-átlagokat.
A fagyasztott ágban nem kerül az optimizer frissítési szabályába, ezért a pályája konstans ; a trainable ágban ugyanez a tag elmozdítja -t. Ha a két ág azonos törzzsel, azonos kezdeti fejjel, azonos adatsorrenddel és azonos head-optimizerbeállítással indul, akkor a predikciók különbsége a elmozdulásához köthető. Ez kísérleti kontroll, nem kauzális bizonyíték: azt méri, hogy az adott recept alatt a reprezentáció megváltoztatása javít-e a validációs metrikán.
Kis adat és transzfer. A GlyphLab train 240 kép, de
csak 120 független scene_id; a megfigyelési egység a
jelenet, nem a kép. A test
képen egy képnyi tévesztés
pontosságkülönbség, ezért a három modell közti kis eltérést scene-szintű
páros összehasonlítással kell értelmezni 23.3. Páros
összehasonlítás és csoportszintű intervallum. Külső előtanított
súlyt itt nem használunk a laborban; a transzfer fogalmilag az
törzs külső súlyból való indulását jelenti, és a
fagyasztott–finomhangolt két ág ugyanazt a protokollt követi. A [D13]
modellkatalógus konkrét súlyverzióját, preprocessingjét és licencét
külön kell ellenőrizni, mielőtt transzfer-eredményt közlünk.
Legyen egyetlen példa, , , , cél . Ekkor a logit , a softmax , és a cross-entropy -gradiense . A lemma szerint
A fagyasztott törzsnél nem létezik frissítési tagként, mert bemeneti konstansként viselkedik a fej számára. Ha -t egy törzs állítaná elő, a trainable ágban és is fellépne.
Minimális ellenőrző kód (# munkakönyvtár: lab/, az
alábbi kimenet a képletekből számított elvárt érték, nem most
végrehajtott futás):
import torch
import torch.nn.functional as F

z = torch.tensor([[3.0, -1.0]])
V = torch.zeros(2, 2, requires_grad=True)
b = torch.zeros(2, requires_grad=True)

s = z @ V.T + b          # logits: (1,2)
loss = F.cross_entropy(s, torch.tensor([0]))
loss.backward()

print(V.grad)
# elvárt: tensor([[-1.5000,  0.5000],
#                 [ 1.5000, -0.5000]])
print(b.grad)
# elvárt: tensor([-0.5000, 0.5000])Protokoll a futás előtt. Kérdés: a tanuló CNN jobb
validációs/testpontosságot ér-e el a GlyphLab orientációfeladaton, mint
a majority, a lineáris pixel és a fagyasztott véletlen törzsű lineáris
fej? Hipotézis: a lineáris pixel a geometriai intenzitáskülönbségek
miatt a majority fölé kerül; a fagyasztott véletlen törzs rossz
reprezentációt ad, ezért a fej önmagában keveset tanul; a trainable CNN
a W elmozdításával ezt felülmúlja. Adat: a GlyphLab
data/images.npy, data/labels.npy,
data/metadata.csv; a maszk és doboz nem modellbemenet.
Megfigyelési egység: scene_id; a pontosság-pontbecslés
mellett a szignifikanciavizsgálat a 23.3. Páros
összehasonlítás és csoportszintű intervallum páros, scene-bootstrap
kerete. Változó tényező: reprezentációs kapacitás. Metrika: accuracy; a
legjobb checkpoint kiválasztása kizárólag a val spliten történik, a
testet utána egyszer értékeljük. Keret: CPU, float32, seed
20261020, teljes batch, Adam lr=1e-2, 30
epoch.
A labor CNN-je az ebben az egységben definiált SmallCNN:
Conv2d(1,8,3,padding=1), ReLU, MaxPool2d(2), Conv2d(8,16,3,padding=1),
ReLU, MaxPool2d(2), Flatten, Linear(576,3). Paraméterszám 2979; a
lineáris pixelmodellé 1731. A fagyasztott ág a CNN törzsét rögzíti, és
csak a
fejet tanítja.
# Munkakönyvtár: lab/
# Futás: cd lab && python baseline_compare.py
import copy
import csv
import json

import numpy as np
import torch
import torch.nn as nn

SEED = 20261020
DEVICE = torch.device("cpu")


def load_glyphlab(base="data"):
    X = np.load(f"{base}/images.npy")          # (360,1,24,24), float32
    y = np.load(f"{base}/labels.npy")          # (360,), int64
    with open(f"{base}/metadata.csv", newline="") as f:
        rows = list(csv.DictReader(f))
    split = np.array([r["split"] for r in rows])
    idx = {k: split == k for k in ("train", "val", "test")}
    assert X.shape == (360, 1, 24, 24) and X.dtype == np.float32
    assert np.all((X >= 0.0) & (X <= 1.0))
    assert y.dtype == np.int64
    return X, y, idx


def majority_accuracy(y_tr, y_te):
    counts = np.bincount(y_tr)
    pred = int(np.flatnonzero(counts == counts.max())[0])  # legkisebb index donor
    return float((y_te == pred).mean())


class LinearPixel(nn.Module):
    def __init__(self, d=24 * 24, K=3):
        super().__init__()
        self.fc = nn.Linear(d, K)

    def forward(self, x):
        return self.fc(x.flatten(1))


class SmallCNN(nn.Module):
    def __init__(self, K=3):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 8, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
            nn.Conv2d(8, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2))
        self.head = nn.Sequential(nn.Flatten(), nn.Linear(16 * 6 * 6, K))

    def forward(self, x):
        return self.head(self.features(x))


def train_model(model, x_tr, y_tr, x_va, y_va, x_te, y_te, epochs=30, lr=1e-2):
    opt = torch.optim.Adam(model.parameters(), lr=lr)
    lossf = nn.CrossEntropyLoss()
    best_va, best_state = -1.0, None
    for _ in range(epochs):
        model.train()
        opt.zero_grad()
        loss = lossf(model(x_tr), y_tr)
        loss.backward()
        opt.step()
        model.eval()
        with torch.no_grad():
            va = (model(x_va).argmax(1) == y_va).float().mean().item()
        if va > best_va:
            best_va, best_state = va, copy.deepcopy(model.state_dict())
    model.load_state_dict(best_state)
    model.eval()
    with torch.no_grad():
        te = (model(x_te).argmax(1) == y_te).float().mean().item()
    return best_va, te


torch.manual_seed(SEED)
X, y, idx = load_glyphlab()
TX = torch.as_tensor(X, dtype=torch.float32, device=DEVICE)
TY = torch.as_tensor(y, dtype=torch.int64, device=DEVICE)
trn, va, te = idx["train"], idx["val"], idx["test"]

maj_va = majority_accuracy(y[trn], y[va])
maj_te = majority_accuracy(y[trn], y[te])
assert abs(maj_te - 1.0 / 3.0) < 1e-6

# Lineáris pixelmodell.
torch.manual_seed(SEED)
lin = LinearPixel().to(DEVICE)
lin_va, lin_te = train_model(lin, TX[trn], TY[trn], TX[va], TY[va], TX[te], TY[te])

# Tanuló CNN: azonos W0 törzs és fej.
torch.manual_seed(SEED)
cnn = SmallCNN().to(DEVICE)
w0 = copy.deepcopy(cnn.features.state_dict())
head0 = copy.deepcopy(cnn.head[1].state_dict())
cnn_va, cnn_te = train_model(cnn, TX[trn], TY[trn], TX[va], TY[va], TX[te], TY[te])

# Fagyasztott törzs; a fej kezdőpontja azonos a CNN fejével.
head = nn.Linear(576, 3).to(DEVICE)
head.load_state_dict(copy.deepcopy(head0))
with torch.no_grad():
    Ztr = cnn.features(TX[trn]).flatten(1)
    Zva = cnn.features(TX[va]).flatten(1)
    Zte = cnn.features(TX[te]).flatten(1)
# Kezdeti predikció-egyezés a tanuló CNN-nel.
with torch.no_grad():
    cnn.eval()
    full0 = cnn(TX[te])
    frozen0 = head(Zte)
assert torch.allclose(full0, frozen0, atol=1e-6)
# Törzs súlya nem változhat a fagyasztott ág tanítása alatt.
w_before = copy.deepcopy(cnn.features.state_dict())
frozen_va, frozen_te = train_model(head, Ztr, TY[trn], Zva, TY[va], Zte, TY[te])
assert all(torch.equal(w_before[k], cnn.features.state_dict()[k]) for k in w_before)

result = {
    "majority_val_acc": maj_va,
    "majority_test_acc": maj_te,
    "linear_pixel_val_acc": lin_va,
    "linear_pixel_test_acc": lin_te,
    "frozen_cnn_val_acc": frozen_va,
    "frozen_cnn_test_acc": frozen_te,
    "trainable_cnn_val_acc": cnn_va,
    "trainable_cnn_test_acc": cnn_te,
    "cnn_params": sum(p.numel() for p in cnn.parameters()),
    "linear_params": sum(p.numel() for p in lin.parameters()),
}
print(json.dumps(result, indent=2))
A kimeneti séma szemléltetése, nem ennek a kéziratnak az írásakor futott mérés:
Eredményértelmezés. A majority padlója . A lineáris pixelmodell és a CNN közti különbséget a fagyasztott ág teszi értelmezhetővé: ha a fej a rögzített véletlen jellemzőkből alig tanul, a trainable CNN többlete a reprezentáció elmozdulásából származik. Ha a lineáris pixelmodell a CNN közelében vagy fölötte van, az nem hiba: a GlyphLab feladat lineáris intenzitásjele erős, és ebből a szintetikus eredményből nem következtetünk természeteskép-teljesítményre.
F1 (fogalmi, nehézség 1). Mi a majority classifier döntetlen-konvenciója ebben a könyvben, és miért pontosan a GlyphLab testpontossága? Adjunk olyan train–test címkepárt, ahol a train-majority a testen 0 pontosságú. Átadandó: a döntetlen-szabály, a kiegyensúlyozottsági indoklás és egy konkrét ellenpélda.
F2 (levezetési, nehézség 2). Vezesse le a lemma alkalmazásával -t és -t egyetlen példára, ha , , , , . Melyik tag marad el a fagyasztott törzs frissítéséből, és miért? Átadandó: a softmax-gradiens, a két mátrix/vektor és egy alakellenőrzés.
F3 (implementációs, nehézség 1). Írjon futtatható
NumPy-függvényt majority_accuracy(y_tr, y_te) néven, amely
a legkisebb indexű többségi osztályt választja döntetlennél, és a
testpontosságot adja. Tesztelje a ([0,0,1,1],[1,1,0,0]) és
([0,0,0,1],[0,0,1,0]) eseteken. Átadandó: kód, elvárt
értékek, futási ellenőrzés.
F4 (hibakeresési, nehézség 2). Adott a szándék szerint fagyasztott törzsű fej-tanítás:
backbone = SmallCNN().features
head = nn.Linear(576, 3)
opt = torch.optim.Adam(list(backbone.parameters()) + list(head.parameters()), lr=1e-2)
for xb, yb in loader:
    opt.zero_grad()
    loss = F.cross_entropy(head(backbone(xb).flatten(1)), yb)
    loss.backward()
    opt.step()
Mi a hiba, mi a kísérleti következménye, és hogyan javítandó?
Átadandó: ok, következmény, javított kód és egy assert,
amely a törzs változatlanságát ellenőrzi.
F5 (kísérleti transzfer, nehézség 3). Tervezzen transzfer-kísérletet egy kisméretű természetes képi osztályozásra, külső előtanított törzzsel. A terv kötelezően tartalmazza: a downstream adat splitjét, a fagyasztott és finomhangolt baseline-t, az azonos preprocessinget, a metrikát, a seed/batch receptet és a következtetési korlátot. A [D13] katalógusból választott konkrét súlyverzióval együtt rögzítse az előfeldolgozást és a licencfeltételeket is. Átadandó: protokollterv pontokban, nem futtatott numerikus eredmény.
F1 megoldása. Döntetlennél a legkisebb indexű
osztályt választjuk. A GlyphLab trainen mindhárom osztály gyakorisága
80/240, a testen 20/60, ezért a donor osztály 0, és a testbeli 0-címkék
aránya
;
itt nincs mintavételi zaj, mert a split-generátor rögzített
osztályonkénti jelenetszámot képez. Ellenpélda:
y_tr=[0,0,0,1], y_te=[1,1,1,0]; a train-majority 0, de a
testen minden címke 1, így a pontosság 0.
F2 megoldása. , , cél , ezért . Ebből
Alakellenőrzés: , , tehát ; . A fagyasztott ágban nincs a frissítésben, mert állandó bemenet, és a -hez vezető gráfélt levágtuk; trainable ágban lép fel.
F3 megoldása.
import numpy as np

def majority_accuracy(y_tr, y_te):
    counts = np.bincount(y_tr)
    pred = int(np.flatnonzero(counts == counts.max())[0])
    return float((y_te == pred).mean())

print(majority_accuracy(np.array([0, 0, 1, 1]), np.array([1, 1, 0, 0])))
# elvárt: 0.0, mert döntetlen -> 0, a test csak 1-es.
print(majority_accuracy(np.array([0, 0, 0, 1]), np.array([0, 0, 1, 0])))
# elvárt: 0.75, mert a donor 0, a testen három 0 van.
A függvény a döntetlennél a legkisebb indexet adja; a
bincount a bemenet nemnegatív int64 címkéire értelmes.
Szélsőeset: egyetlen osztályt tartalmazó train esetén a pred
egyértelmű.
F4 megoldása. Hiba: az optimizer a
backbone.parameters() listát is tartalmazza, tehát a törzs
súlyai frissülnek; ez finomhangolás, nem fagyasztott features.
Következmény: a reprezentáció–classifier összehasonlítás érvénytelenné
válik, mert a head-teljesítményhez reprezentációváltozás is társul.
Javítás:
for p in backbone.parameters():
    p.requires_grad_(False)

with torch.no_grad():
    Ztr = backbone(Xtr).flatten(1)
    Zva = backbone(Xva).flatten(1)

head = nn.Linear(576, 3)
opt = torch.optim.Adam(head.parameters(), lr=1e-2)
w0 = copy.deepcopy(backbone.state_dict())

for ep in range(5):
    opt.zero_grad()
    loss = F.cross_entropy(head(Ztr), ytr)
    loss.backward()
    opt.step()

assert all(torch.equal(w0[k], backbone.state_dict()[k]) for k in w0)
Az assert egy tanítási ciklus után is garantálja, hogy a törzs bitre
azonos maradt. A no_grad cache egyúttal levágja az autograd
gráfot a törzs irányába.
F5 megoldásminta. Terv: (1) downstream adat
rögzített train/val/test csoportos splitje, ahol a független egység a
jelenet vagy személy, és a val kizárólagos modellválasztásra szolgál.
(2) Baseline A: fagyasztott külső törzs, újonnan inicializált lineáris
fej, a törzs súlyai requires_grad_(False). (3) Baseline B:
azonos törzs finomhangolva, kisebb lr, például a fej
tizede, azonos epoch- és batch-recepttel; a kezdeti predikció-egyezést a
két ág indulásakor run-ellenőrzéssel rögzítjük. (4) Preprocessing a
törzs dokumentált bemeneti sémájával egyezik; eltérés esetén a transzfer
domain-shiftet szenved. (5) Metrika: top-1 accuracy és a scene-szintű
páros bootstrap a 23.3. Páros összehasonlítás és
csoportszintű intervallum szerint; a testet a val-alapú checkpoint
után egyszer értékeljük. (6) Korlát: a kis downstream minta miatt a két
ág különbsége nem általános transzfer-törvény; a [D13] katalógus konkrét
súlyverzióját, licencét és preprocessingjét a futtatás előtt ellenőrizni
kell.
Tipikus tévedés. „A szintetikus GlyphLab-on a CNN magas pontossága azt mutatja, hogy a modell természetes képeken is jól teljesít.” Ez nem következik. Ellenpélda: egy -es XOR-képfeladaton a lineáris pixelmodell legfeljebb trainpontosságot érhet el, mert a négy sarokpont affin hipersíkkal nem választható szét; egy megfelelő nemlineáris CNN a négy mintát megtanulhatja. A GlyphLab orientáció lineárisan erős geometriai jelet hordoz, ezért ott a lineáris baseline is magas lehet; egy másik szintetikus vagy természetes feladat nehézsége ettől független.
Önellenőrzés. Rögzítettem-e a majority döntetlen-szabályát? A baseline-ok csak a képtensort használják, a maszkot és dobozt nem? A fagyasztott ág kezdeti logitja numerikusan egyezik a trainable CNN kezdeti logitjával? A legjobb modellt val, a testet azután választom? A testkülönbséget kép vagy scene-szintű egységgel értelmezem?
Visszahívás. A 13.3. Lokális szűrők és tanult reprezentáció alfejezetben rögzített szűrő a tanulható kernel egy pontja; itt a lineáris pixelmodell kernel, tehát nem használja a súlymegosztás térbeli lokalitását. A 21.3. Dropout, súlyregularizálás és augmentáció szerint a weight decay és dropout heurisztika, ezért a labor összehasonlítása ugyanazt a regularizálásmentes receptet alkalmazza minden ágra. A 24.3. Mixed precision és nagyobb batch szerint f32, teljes batch és CPU mellett nincs szükség GradScalerre vagy akkumulációra; ha később kevert pontosságúra váltunk, a három ágat azonos numerikus úton kell futtatni.
A kis adaton a CNN-t csak azonos spliten futtatott referenciákhoz képest értékeljük. A majority a leggyakoribb tanítóosztályt adja, döntetlennél a legkisebb indexet; a kiegyensúlyozott GlyphLab testen pontossága . A lineáris pixelmodell bemenetet képez le három logitra, paraméter nélküli térbeli lokalitás nélkül. A fagyasztott törzsű fej csak a fejgradienst frissíti; a trainable CNN a -n át -t is. Ugyanazon , fejkezdőpont és recept mellett a két ág közti különbség a reprezentáció elmozdulását méri. A labor protokollt, ellenőrző assertet és jelölt szemléltető kimenetet ad; a tényleges futás a 25.4. Nyílt halmaz és ismeretlen input nyílt halmaz előtt a transzfer és baseline korlátokat is rögzíti.
A 25.4. Nyílt halmaz és ismeretlen input egység a nyílt halmazú felismerést tárgyalja: a három GlyphLab-osztályra tanított softmax pontszám nem dönthet ismeretlen inputról anélkül, hogy a logit-kalibráció és a döntési küszöb szerződését újra megnyitnánk.
Felhasznált források: