A 21.1. Inicializálás és varianciaterjedés egységben az inicializálás skálaviszonyait vezettük le; ott a frissítés nagyságát még szabadon hagytuk. Itt a learning rate (tanulási ráta, LR), az lépésméret kérdését vizsgáljuk: milyen intervallumban stabil, hogyan változtassuk a tanítás során ütemezetten, és hogyan rögzítsük reprodukálhatóan. Induló becslés: ha a cél és , akkor a gradiens . Mekkora választásnál válik a frissítés oszcillálóvá? A pontos határt egy egyszerű kvadratikus kontrollból vezetjük le; ez a lokális görbület és a lépésméret kapcsolatának alapesete lesz.
Legyen a paramétervektor a -edik frissítés után, a paraméterszám. A -edik minibatch indexhalmaza , mérete . A batch-átlag loss:
ahol az -edik tanítóminta vesztesége. A teljes gradiensű frissítéshez képest a következő SGD-lépést használjuk:
A gradiens alakja megegyezik alakjával, tehát . Az általában skalár; a 20.2. Finomhangolás és tanulási ráta finomhangolási egységben láttuk, hogy paramétercsoportonként eltérő is lehet. A következő terminusokat külön kell választani:
optimizer.step() hívás.drop_last=False, egy epoch
stepből áll; drop_last=True esetén
.A kettő nem felcserélhető, mert a legtöbb schedule a lépések vagy az epochok függvénye.
A levezetési kötelezettségünk a következő állítás.
Állítás (kvadratikus lépésméret-korlát). Legyen , valamely -ra, és legyen a frissítés teljes gradiensű, rögzített mellett:
Ekkor:
Levezetés. , így
Az első állítás -ra triviális, az indukciós lépés pedig a fenti egyenlet. A mértani sorozat pontosan akkor tart nullához, ha ; mellett ez ekvivalens azzal, hogy , azaz . A harmadik pont: akkor és csak akkor, ha .
A érték a lokális görbületből származik; többdimenziós, nem-kvadratikus célfüggvény esetén a Hessian legnagyobb sajátértéke játszik hasonló szerepet, de ez utóbbi kapcsolatot itt csak heurisztikus irányelvnek tekintjük (a spektrális eszközöket 3.4. Sajátérték, SVD és spektrális határ vezette be). A fenti állítás maga teljes, a feltételek szerint bizonyított levezetés.
Kézi számpélda. Legyen , tehát , .
Ez a kontroll nem állít semmit a CNN-veszteség felületéről; azt mutatja meg, hogyan számolható ki a stabilitási tartomány egy explicit görbületű feladaton.
A learning rate schedule (tanulási ráta ütemezése) egy előre rögzített vagy pozitív sorozat a tanítási költségvetésre. Három gyakori családot definiálunk.
Step decay. Rögzített kezdőérték, csillapítási tényező és lépcsőhossz mellett
Epoch-alapú változatban , ahol epoch-hossz. A két változatot át kell számolni: az epoch-alak lépcsője lépésnek felel meg.
Cosine annealing. Rögzített össz-lépésszámra
A végpontokban és . A itt lépésindex; epoch-alapú használathoz a lépést epochból kell átszámolni.
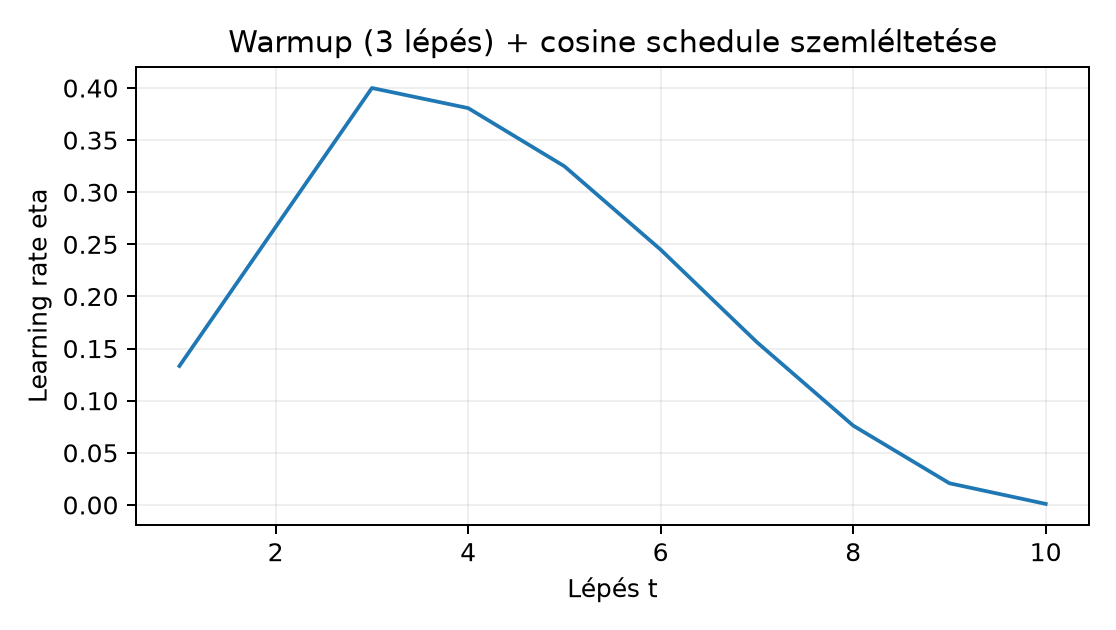
Warmup. A fő schedule elé lineáris növekedést iktatunk. Az első lépésben
majd -ra a választott ütem következik. A cél, hogy a nagy kezdeti gradiens ne tegye tönkre a frissen inicializált rétegeket; ez heurisztika, és a szükségességét az adott modellen validációval kell igazolni. A BatchNorm-irodalom a nagyobb LR alkalmazhatóságát empirikus előnyként közli [P07], de a mechanizmus vitatott; a running state kérdéseit 18.2. Batch normalization train és eval módban tárgyalja.
Kiszámolt mini-példa. , , , . A warmup a lépésekre értéket ad. A cosine-szakasz hosszú, a átindexeléssel; a lépésben , a végpontban .
A könyvtári API-kban (például a PyTorch
torch.optim.lr_scheduler modulja, [D06]) a scheduler
állapotot tart nyilván: az aktuális epoch/step
számlálót, az utolsó érvényes
értéket, a plateau-változatnál a patience-számlálót és a legjobb
validációs metrikát. Ez az állapot a kísérlet része. Ha a checkpointba a
modell- és optimizer-state_dict mellett a
scheduler-state_dict nem kerül be, a visszatöltés után a
schedule nem ott folytatódik, ahol abbamaradt; ez reprodukálhatósági
hibát okoz (vö. 12.1.–12.2.). A mentésnek tehát három state_dict-et és az
aktuális epochot kell tartalmaznia.
Az epoch vs step megkülönböztetés azért lényeges, mert a step-alapú schedule más számú frissítést ad a batch-mérettől függően, míg az epoch-alapú schedule azonos epochszám mellett más LR-pályát és más számítási költséget jelent.
A ReduceLROnPlateau nem előre rögzített függvény,
hanem visszacsatolt döntés: ha a rögzített validációs halmaz mért
metrikája patience epochon át nem javul, a scheduler
szorzót hajt végre, és a patience-számlálót nullázza. Mivel a validációs
halmaz itt közvetlenül befolyásolja a tanítási pályát, a validációs
split a modellválasztás része; a végső tesztet érintetlenül kell hagyni
(1.3. Adatfelosztás és a megfigyelési egység).
Az adaptív ütem előnye, hogy a csökkentés időzítését az adathoz
igazítja; ára, hogy a zajos validációs metrika hamis plateau-t is
jelezhet.
Protokoll. Kérdés: konstans
vagy warmup+cosine ad-e alacsonyabb legjobb validációs loss-t a
GlyphLabon? Hipotézis: a cosine az utolsó szakaszban csökkentett LR-rel
simábban ér be a minimumba. Adat: lab/data/ a
GlyphLab-szerződés szerint; a train/val splitet a
metadata.csv adja, a scene-szintű csoportosítást az 5.4. Függő képek, seedek és resampling egységben
rögzítettük. Modell: a 9.2. MLP és nemlinearitás
definícióját követő kis MLP, bemenet
(NCHW
),
rejtett 32 ReLU neuron, dropout
,
kimenet
logits. Optimizer: AdamW lr=1e-3, weight_decay=0.01; a
decoupled weight decay [P02] absztraktja szerint a
súlycsillapítási tagot nem skálázza az LR, ezért a schedule csak az
LR-pályát változtatja. Batch 32, 40 epoch, seed 20261020, CPU float32.
Az összehasonlításban azonos modell, optimizer, batch, epoch és seed
mellett csak a schedule típusa változik; ez az „azonos update-keret”. A
best checkpointot a validációs loss minimuma választja; a végső tesztet
a kiválasztás után értékeljük.
Futtatási parancs:
cd lab && python n082_schedule_compare.py. A vázlat
a 11.3. Dataset és DataLoader a split után
adatbetöltési mintáját használja:
# lab/n082_schedule_compare.py
# CPU-futási vázlat; a kimenet JELÖLT SZEMLÉLTETÉS, nem mért futtatás.
import math
import numpy as np
import torch
from torch import nn
from torch import optim

torch.manual_seed(20261020)
device = torch.device("cpu")

X = np.load("data/images.npy")          # (360,1,24,24) float32
y = np.load("data/labels.npy")          # (360,) int64
# metadata.csv: split oszlop; a pontos string-feldolgozást lásd n043.
meta = np.genfromtxt("data/metadata.csv", delimiter=",", names=True)
train_idx = np.where(meta["split"] == b"train")[0]
val_idx   = np.where(meta["split"] == b"val")[0]

B = 32
STEPS_PER_EPOCH = math.ceil(len(train_idx) / B)   # 8
EPOCHS = 40
TOTAL_STEPS = EPOCHS * STEPS_PER_EPOCH
WARMUP_STEPS = 3 * STEPS_PER_EPOCH

def make_model():
    return nn.Sequential(nn.Flatten(), nn.Linear(576, 32), nn.ReLU(),
                         nn.Dropout(0.05), nn.Linear(32, 3)).to(device)

def make_lr_lambda(kind):
    if kind == "const":
        return lambda step: 1.0
    if kind == "cosine":
        def f(step):
            if step < WARMUP_STEPS:
                return 0.2 + 0.8 * step / WARMUP_STEPS
            t = step - WARMUP_STEPS
            T = TOTAL_STEPS - WARMUP_STEPS
            return 0.5 * (1 + math.cos(math.pi * t / T))
        return f
    raise ValueError(kind)

def run(kind):
    model = make_model()
    opt = optim.AdamW(model.parameters(), lr=1e-3, weight_decay=0.01)
    sched = optim.lr_scheduler.LambdaLR(opt, make_lr_lambda(kind))
    lossf = nn.CrossEntropyLoss()
    best_val = math.inf
    Xt = torch.from_numpy(X[train_idx])
    yt = torch.from_numpy(y[train_idx])
    Xv = torch.from_numpy(X[val_idx])
    yv = torch.from_numpy(y[val_idx])
    for epoch in range(EPOCHS):
        model.train()
        perm = torch.randperm(len(yt))
        for i in range(0, len(yt), B):
            xb = Xt[perm[i:i+B]]
            yb = yt[perm[i:i+B]]
            opt.zero_grad()
            lossf(model(xb), yb).backward()
            opt.step()
            sched.step()
        model.eval()
        with torch.no_grad():
            val_loss = lossf(model(Xv), yv).item()
        if val_loss < best_val:
            best_val = val_loss
            torch.save({"model": model.state_dict(), "opt": opt.state_dict(),
                        "sched": sched.state_dict(), "epoch": epoch}, "best.pt")
    return best_val

print("const  best_val_loss:", run("const"))
print("cosine best_val_loss:", run("cosine"))
A szemléltetett kimenet (nem mért adat):
const  best_val_loss: 0.640
cosine best_val_loss: 0.594
Értelmezés: a különbség egyetlen seedből nem bizonyít általános előnyt; ismételt seedek és a közös kiindulás ellenőrzése szükséges. A labor célja a szerződéses kivitelezés, nem egy előre megadott győztes.
F1 (fogalmi, nehézség 1). Definiálja a step és az
epoch közötti különbséget, és adja meg a kapcsolatukat
drop_last=True esetén. Miért nem elegendő azt közölni, hogy
„50 epochig tanítottuk a modellt”, ha valaki reprodukálni akarja a
schedule-t?
F2 (levezetési, nehézség 2). Tekintse az függvényt, kezdőpontot és az konstans lépésű gradiensmódszert. (a) Adja meg zárt alakját. (b) Számolja ki értékét. (c) Milyen intervallumban konvergál a módszer? (d) Ellenőrizze, hogy esetén .
F3 (implementációs, nehézség 2). Írjon
Python-függvényt
cosine_lr(step, T, eta_max, eta_min, warmup=0) néven, amely
a fenti cosine-képletet valósítja meg, warmup>0 esetén a
tartományban lineáris növekedéssel. A 0. regressziós teszt:
,
,
;
a végpontokra step=0 ad
értéket, step=T ad
értéket. A relatív tűrés
.
Szélsőeset: warmup=0 ne osszon nullával.
F4 (hibakeresési, nehézség 2). Egy kolléga a
checkpointba csak model.state_dict() és
opt.state_dict() objektumokat ment, a scheduler
state_dict-jét nem, majd a visszatöltés után a
ReduceLROnPlateau patience-számlálóját újraindulni észlelte. Adja meg a
hiba okát, következményét és a javított mentés/betöltés kódját.
F5 (kísérlettervezési/transzfer, nehézség 3). Tervezzen kis CPU-kísérletet a GlyphLabon, amely a step decay (, lépcső 15 epoch) és a cosine annealing validációs lossát hasonlítja össze. Adja meg: megfigyelési egység, split, baseline, változó tényező, metrika, keresési keret és seed. Indokolja, miért nem vonható le általános következtetés egyetlen seedből, és milyen ismétlést tenne hozzá.
F1. A step egy optimizer-frissítés, az epoch az
összes tanítóminta egyszeri végighaladása. drop_last=True
esetén egy epoch
stepet tartalmaz, mert az utolsó,
-nél
rövidebb batch kimarad. Az „50 epoch” önmagában nem határozza meg a
frissítések számát:
esetén például 400,
esetén 200 lépés lehet. A step-alapú schedule tehát ugyanannyi epoch
alatt eltérő LR-pályát jár be; a reprodukcióhoz a batch-méretet, a
drop_last értéket és a schedule típusát is meg kell
adni.
F2. Itt , tehát , és
F3. A függvény:
import math

def cosine_lr(step, T, eta_max, eta_min, warmup=0):
    if step < warmup:
        return eta_max * step / warmup if warmup > 0 else eta_max
    t = step - warmup
    T_eff = T - warmup
    if T_eff <= 0:
        raise ValueError("warmup < T szükséges")
    return eta_min + 0.5 * (eta_max - eta_min) * (1 + math.cos(math.pi * t / T_eff))
Ellenőrzés: cosine_lr(0, 100, 0.1, 1e-4) a
warmup=0 ág miatt a cosine-szakaszba lép,
,
,
az eredmény
.
cosine_lr(100, 100, ...) esetén
,
,
az eredmény
.
A lebegőpontos kerekítés a
relatív tűrésen belül van. A warmup=T eset kizárt a
T_eff<=0 ellenőrzéssel.
F4. Ok: a scheduler belső számlálói (epoch,
patience, best metrika, utolsó LR) nem részei a modell vagy az optimizer
state_dict-jének; önálló objektumban élnek. Következmény:
visszatöltéskor a scheduler új példánya nulla patience-számlálóval
indul, tehát a plateau-várás elölről kezdődik, és a folytatás LR-pályája
eltér a megszakított futásétól. Javítás:
torch.save({"model": model.state_dict(), "opt": opt.state_dict(),
            "sched": sched.state_dict(), "epoch": epoch}, "ckpt.pt")

ckpt = torch.load("ckpt.pt", weights_only=True)
model.load_state_dict(ckpt["model"])
opt.load_state_dict(ckpt["opt"])
sched.load_state_dict(ckpt["sched"])
Ellenőrzés: a mentés utáni sched.get_last_lr() értékét
naplózza; a visszatöltés után ugyanazt kell visszaadnia.
F5. Egy lehetséges terv. Megfigyelési egység: egy teljes tanítási futás a rögzített seeddel. Split: a GlyphLab scene-szintű train/val/test felosztása; a validáció a best checkpoint kiválasztására szolgál, a teszt csak a végén fut. Baseline: konstans . Változó tényező: a schedule típusa (step decay versus cosine), minden más azonos. Metrika: legjobb validációs loss; záró teszt-accuracy a kiválasztott checkpointra. Keresési keret: 15 epochos lépcső, , batch 32, AdamW, seed 20261020. Egy seed nem általánosít, mert a súlyinicializálás és a minibatch sorrend realizációja eltérő pályát ad. Ismétlés: három seed (például 20261020, 20261021, 20261022), átlag és seed-szórás, páros seed-különbség a két schedule között; a következtetést a GlyphLabra és a használt modellcsaládra korlátozzuk.
„A 40 epochos lépcsős ütem ugyanannyi számítást végez, mint a 40 epochos cosine, mert mindkettő 40 epoch.” Ez hibás. A 240 tanítóképből mellett 8 batch képződik, mellett 4; 40 epoch az elsőnél 320, a másodiknál 160 frissítést jelent. A step-alapú step decay az elsőben 320 lépés alatt több lépcsőt hajthat végre, mint a másodikban; a forward/backward hívások száma és a számítási költség is eltér. A költség tehát stephez és batch-mérethez kötött, nem epochhoz.
Önellenőrző kérdések. (1) Mi a intervallum szerepe a kvadratikus példában? (2) Mely állapotokat kell a checkpointba menteni a scheduler folytatásához? (3) A cosine-képlet és végpontjaiban milyen értéket ad?
Visszahívás 21.1. Inicializálás és varianciaterjedés. Az inicializálás varianciaskálája és az LR nem független: a túl nagy kezdeti aktivációskálából adódó nagy gradiens ugyanazt a stabilitási határt feszíti, mint a túl nagy . A két beállítást együtt kell diagnosztizálni.
Visszahívás 20.2. Finomhangolás és tanulási ráta. A finomhangolásnál a paramétercsoportonkénti LR ugyanazt a frissítési szabályt használja, csak csoportonként más; a scheduler ilyenkor minden csoportra azonos ütemben skáláz.
Visszahívás 17.2. AlexNet és a kísérleti kontextus. Az AlexNet-kísérlet tanulsága, hogy a nagy hálózatok tanítási eljárása (LR, momentum, dropout, augmentáció) szétválaszthatatlan az elért teszteredmény kontextusától; a 17.2. AlexNet és a kísérleti kontextus alfejezetben közölt 15,3% top-5 hiba nem a schedule önmagában való dicsérete.
A learning rate a gradiensfrissítés skálája; a korlát mutatja, hogy a lokális görbület felső határt szab a stabil lépésnek. A step decay, a cosine annealing és a warmup előre rögzített ütemek, a ReduceLROnPlateau ezzel szemben validációs visszajelzést használ. A scheduler állapota a reprodukálható tanítás része, ezért a checkpointnak a model, optimizer és scheduler state_dict mellett az epochot is tartalmaznia kell. Az epoch és a step különböző költség- és pályafogalom; azonos epochszám nem jelent azonos számítást. A labor két schedule kis CPU-futását azonos modell, optimizer, seed és split mellett hasonlítja össze.
A 21.3. Dropout, súlyregularizálás és augmentáció egység a dropout, a súlyregularizálás és az augmentáció kérdését tárgyalja. Ezek a regularizáló eszközök a schedule-rel együtt hatnak a validációs pályára, ezért ott azt is vizsgáljuk, hogyan kell őket kísérletileg szétválasztani.