A 14.3. Paraméterszám, MAC és
aktivációmemória egységben a teljes konvolúció paraméterszámát és
MAC-igényét vezettük le. Itt a groups paramétert
vizsgáljuk: ez nem pusztán egy gyorsítási kapcsoló, hanem a bemeneti és
kimeneti csatornák közötti kapcsolat explicit korlátozása. Előismeret a
cross-correlation képlet, a súlyalak és a kimeneti méret; Pythonból elég
a listaszámolás, PyTorchból a torch.nn.Conv2d alapvető
használata.
Induló kérdés: egy
,
,
-as
rétegnél mit jelent a groups=2? Hány súlyt takarít meg, és
melyik bemeneti csatorna szűnhet meg hatni valamelyik kimeneti
csatornára? A válaszhoz először a pontos definíció kell.
groups
paraméter definíciójaLegyen
a csoportok száma. A [D10] dokumentáció szerint a PyTorch
Conv2d groups paramétere megköveteli, hogy
és
is teljesüljön; pontosabban mindkettő osztható
-vel.
Jelölje
A súlytensor alakja ekkor
a bias pedig . A -edik csoport, , a bemeneti csatornák közül a
halmazt, a kimeneti csatornák közül az
halmazt kapja. A lényeg: a -edik kimeneti csoport csatornái kizárólag a -edik bemeneti csoport csatornáit látják. A cross-correlation képlete szimmetrikus zero paddinggel, stride-dal:
ahol . Két részletre érdemes figyelni. Először: a súly második indexe és között fut, ezért az abszolút bemeneti csatornából le kell vonni a csoport kezdőindexét, -et. Másodszor: a bias továbbra is kimeneti csatornánként egy skalár; a csoportosítás a bias alakját nem változtatja.
A groups=1 eset az eddigi teljes konvolúció:
,
,
minden bemeneti csatorna minden kimeneti csatornához kapcsolódik. A
másik szélső eset a depthwise konvolúció.
Ha , akkor : minden bemeneti csatorna saját kernelhalmazt kap, és a csatornák között nincs keverés. A kimeneti csatornát a
összefüggés írja le, ahol pozitív egész, az úgynevezett depthwise multiplier. A súlyalak ilyenkor
A groups=C_in és
választás tehát
;
ekkor minden bemeneti csatornához pontosan egy kimeneti csatorna
tartozik. Ha
,
minden bemeneti csatornából két különböző, egymástól független szűrt kép
készül, de a két kimeneti csatorna ugyanazt az egy bemeneti csatornát
látja.
A kifejezés „depthwise separable” két réteg kompozícióját jelöli: először egy depthwise réteg térbeli szűrést végez csatornánként, majd egy pontszerű, -es konvolúció keveri a csatornákat. A pointwise réteg definíciója:
Ez minden térbeli pozícióban ugyanazt a affin leképezést hajtja végre; a kernel térbeli kiterjedése , tehát térbeli keverés nincs. A depthwise réteg ezzel szemben térbeli keverést végez, de csatornakeverést nem. A kettő együtt közelítőleg szétválasztja a térbeli és csatornairányú számítást; ennek költségmodelljét a 19.1. Depthwise separable és pointwise réteg egység vizsgálja majd.
A levezetési kötelezettség a group korlátozás lineáris algebrai alakja. Rögzítsük a paddinget, stride-ot és kernelt, és lapítsuk a bemeneti tensort csatorna-major sorrendben egy vektorrá: előbb a csatorna minden pixele, majd az csatorna, és így tovább. Hasonlóan lapítsuk a kimenetet vektorrá. A zero padding mellett a cross-correlation lineáris operátor; legyen a mátrixa, azaz a bias nélkül.
Állítás (grouped operátor blokkdiagonális alakja). Ha és , akkor a csatorna-major rendezésben az mátrix
alakú, ahol a -edik blokk
éppen annak a teljes cross-correlationnak a mátrixa, amely a -edik csoport
súlyához tartozik.
Bizonyítás. A csatorna-major rendezésben az inputvektor -edik blokkja, , pontosan a csatornák pixeleit tartalmazza. A kimeneti vektor -edik blokkja, , a csatornák pixeleit tartalmazza. A definiáló képlet szerint minden kimeneti csatorna összegzése csak a csatornákon fut. Ezért nem függ -től, ha ; a mátrix -edik sorblokkjában minden nem- oszlopblokk zérus. A -edik diagonális blokk elemeit a fenti képlet -re és -ra megszorított változata adja. Ha az összegzésben bevezetjük a csoporton belüli indexeket és , a kapott egyenlet alakja pontosan egy bemeneti és kimeneti csatornás, súlyú, ugyanolyan paddingű és stride-ú cross-correlation. Ez pedig definíció szerint . Ezzel az állítást beláttuk.
A bias
hozzáadása nem rontja a szerkezetet: minden kimeneti koordinátához a
saját csatornájának skalárja adódik, csatornák közötti keverés nélkül.
Az állítás egyben megmutatja, mit jelent a „kapcsolat korlátozása”: a
csatornacsoportok szintjén a kapcsolati mátrix diagonális, míg
groups=1 esetén egyetlen blokk van, tehát minden
csatornapár össze van kötve. A mátrix blokkjain belül a térbeli pozíciók
természetesen továbbra is keverednek a kernel által; a group a térbeli
keverést nem tiltja, csak a csatornák közötti utat szűkíti.
Vegyünk egy , , , tehát , depthwise konfigurációt, bemenettel, kernellel, padding és bias nélkül. A kimeneti méret . Állítsunk be minden depthwise kernel elemet -re, és legyen a bemeneti csatorna konstans értékű: .
A -es csupa egyes kernel egy konstans bemeneten a összeget adja mind a négy kimeneti pozícióban. A bemeneti csatornához a és kimeneti csatornák tartoznak, tehát a várt kimenet
A bemeneti csatorna nem hat az kimeneti csatornára, és a bemeneti csatorna sem hat a kimeneti csatornára; a kapcsolat csatornánként izolált. Ez a legkisebb példa, amelyben a depthwise korlátozás ténylegesen látszik.
# munkakönyvtár: lab/
import torch

torch.manual_seed(0)
conv = torch.nn.Conv2d(3, 6, (2, 2), padding=0, groups=3, bias=False,
                       dtype=torch.float32)
with torch.no_grad():
    conv.weight.fill_(1.0)

x = torch.zeros(1, 3, 3, 3, dtype=torch.float32)
for c in range(3):
    x[0, c].fill_(float(c))

y = conv(x)
print(y.shape)
print(y[0, :, 0, 0])
A várt, a képletből számított kimenet (1,6,2,2) és
tensor([0., 0., 4., 4., 8., 8.]); ez képletből számított
érték, nem mérési jegyzőkönyv. A súlyok ellenőrzése:
assert conv.weight.shape == (6, 1, 2, 2)A második dimenzió , nem ; ez a depthwise alak legfontosabb ellenőrzése.
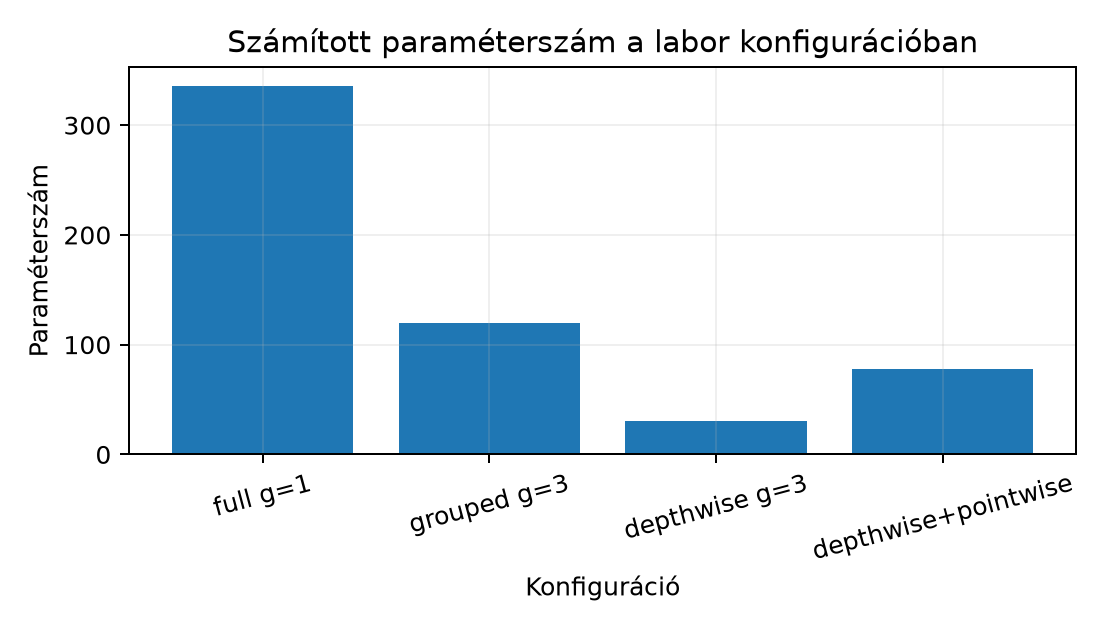
A labor célja három konfiguráció paraméterszámának összehasonlítása,
a súlyalak ellenőrzése és egy oszthatósági hiba pontos megfogása. Az
alábbi szkript a 14.3. Paraméterszám, MAC és
aktivációmemória képletét használja, és a [D10] dokumentációban
rögzített in_channels/out_channels
oszthatósági feltételre épít.
# munkakönyvtár: lab/
import torch

def count_params(conv):
    return sum(p.numel() for p in conv.parameters())

def describe(name, cin, cout, k, groups):
    conv = torch.nn.Conv2d(cin, cout, (k, k), bias=True, groups=groups,
                           dtype=torch.float32)
    w = conv.weight
    expected_w = cout * (cin // groups) * k * k
    assert w.shape == (cout, cin // groups, k, k), w.shape
    assert expected_w + cout == count_params(conv)
    mac_one_output = (cin // groups) * k * k
    print(f"{name:22s} weight={tuple(w.shape)} params={count_params(conv):3d} "
          f"MAC/output={mac_one_output}")

describe("full g=1",         3, 12, 3, 1)
describe("grouped g=3",      3, 12, 3, 3)
describe("depthwise g=3",    3,  3, 3, 3)
describe("pointwise 1x1",    3, 12, 1, 1)

try:
    torch.nn.Conv2d(5, 12, 3, groups=2)
except ValueError as e:
    print("hibas_groups:", type(e).__name__, "oszthatosagi feltetel serult")
A szkript a képletből számított várt kimenete, nem mért futás:
| Konfiguráció | Súlyalak | Paraméterek |
|---|---|---|
| full g=1 | (12, 3, 3, 3) | 336 |
| grouped g=3 | (12, 1, 3, 3) | 120 |
| depthwise g=3 | (3, 1, 3, 3) | 30 |
| pointwise 1x1 | (12, 3, 1, 1) | 48 |
A depthwise réteg után egy csatornás pointwise réteg összesen paramétert használ a teljes réteg paraméteréhez képest. A MAC-érték kimeneti elemenként a full esetben szorzás, a grouped esetben ; a pointwise utótag hozzáadását a 19.1. Depthwise separable és pointwise réteg végzi el teljes költségmodellként.
A hibás oszthatóság ellenpéldája:
,
esetén
,
ezért a konstruktor ValueError kivételt vet. Ugyanígy sérül
a feltétel, ha
nem osztható. A pontos hibaüzenet szövege PyTorch-verziófüggő; a labor a
kivétel típusát és az oszthatósági feltételt ellenőrzi, nem a konkrét
szöveget.
F1 (fogalmi, nehézség 1). Magyarázza el, mi a
különbség a groups=1, a groups=C_in és egy
közbülső groups=2 konfiguráció között a csatornák
kapcsolatában. Adjon kis ellenpéldát arra, hogy a groups
nem értelmezhető, ha
vagy
.
Átadandó: definíciók, egy-egy konkrét csatornahalmaz-példa és az
oszthatósági hiba oka.
F2 (levezetési/bizonyítási, nehézség 2). Legyen , , , kernel , input , padding , stride . Adja meg a csoportonkénti be- és kimeneti csatornahalmazokat, a súly alakját, a paraméterszámot, és a csatorna-major lapításban az mátrix blokkméreteit. Írja fel a középső csoport második kimeneti csatornájának egyetlen kimeneti elemére a teljes összegképletet. Átadandó: halmazok, alakok, blokkméretek és a képlet minden indexhatárral.
F3 (implementációs, nehézség 2). Írjon
PyTorch-szkriptet, amely a fenti depthwise kézi példát ellenőrzi
torch.allclose hívással, megszámolja a paramétereket egy
groups=1 és egy groups=3 rétegnél, és
próbaként megkísérli a
,
konstrukciót, elkapva a ValueError-t. Átadandó: futtatható
kód, elvárt kimenet és tolerancia.
F4 (hibakeresési, nehézség 2). Egy fejlesztő a
korábbi NumPy referencia conv2d függvényét hívja
groups=2 argumentummal. A függvény csak
groups=1-et támogat, és a paramétert csendben figyelmen
kívül hagyja. Hol van a hiba, mi a következménye, és milyen teszt fedné
fel azonnal? Átadandó: a hiba oka, egy olyan input, amelyen a helyes és
a hibás kimenet különbözik, és a javítás módja.
F5 (kísérleti/transzfer, nehézség 2). Tervezzen GlyphLab-kísérletet, amely egy teljes -as konvolúciót hasonlít össze egy depthwise separable réteggel azonos kimeneti csatornaszámon. Adja meg a kérdést, a megfigyelési egységet, a splitet, a baseline-t, a változó tényezőt, a metrikát és a következtetés korlátját. Átadandó: protokoll, legalább két lehetséges kimenetel értelmezése; előre rögzített győztest ne állítson.
F1. groups=1 esetén egyetlen csoport
van: mind a
bemeneti csatorna összekötött mind a
kimeneti csatornával. groups=C_in esetén
,
a
-edik
kimeneti csoport csak a
bemeneti csatornát látja; ez a depthwise eset. Ha
és
,
,
akkor a
csoport az
bemeneti és
kimeneti csatornát, az
csoport a
bemeneti és
kimeneti csatornát kapja. A
bemeneti csatorna nem hathat a
kimeneti csatornára. Az oszthatóság azért kell, mert a csoportoknak
egyenlő méretű partíciót kell alkotniuk;
,
esetén nem tudunk két egyenlő, diszjunkt csatornahalmazt képezni.
Ugyanez a kimeneti oldalon is fennáll.
F2. . A csoportok: : be , ki ; : be , ki ; : be , ki . A súly alakja ; a tanulható paraméterszám . A kimeneti méret , a lapított input mérete , a lapított output mérete . Az mátrix -os, három blokkal; minden blokk sor és oszlop méretű, tehát . A középső csoport második kimeneti csatornája , a bemeneti csatornák . Padding nélkül, mellett egy kimeneti elem:
A csoporton belüli második súlyindex mindig .
F3. A teljes megoldás:
# munkakönyvtár: lab/
import torch

torch.manual_seed(0)

conv = torch.nn.Conv2d(3, 6, (2, 2), padding=0, groups=3, bias=False,
                       dtype=torch.float32)
with torch.no_grad():
    conv.weight.fill_(1.0)
x = torch.zeros(1, 3, 3, 3, dtype=torch.float32)
for c in range(3):
    x[0, c].fill_(float(c))
y = conv(x)
expected = torch.tensor([[[[0., 0.], [0., 0.]],
                          [[0., 0.], [0., 0.]],
                          [[4., 4.], [4., 4.]],
                          [[4., 4.], [4., 4.]],
                          [[8., 8.], [8., 8.]],
                          [[8., 8.], [8., 8.]]]])
assert y.shape == (1, 6, 2, 2)
assert torch.allclose(y, expected, atol=1e-6)

full = torch.nn.Conv2d(3, 6, 3, groups=1, bias=True, dtype=torch.float32)
grouped = torch.nn.Conv2d(3, 6, 3, groups=3, bias=True, dtype=torch.float32)
n_full = sum(p.numel() for p in full.parameters())
n_grp = sum(p.numel() for p in grouped.parameters())
print(n_full, n_grp, full.weight.shape, grouped.weight.shape)

try:
    torch.nn.Conv2d(5, 12, 3, groups=2)
except ValueError as e:
    print("elkapva", type(e).__name__)
A várt kimenet: 168 60, (6,3,3,3) és
(6,1,3,3), majd elkapva ValueError. A
full réteg paraméterszáma
,
a grouped
.
A tolerancia
bőven elég, mert a példa egész értékű szorzásokat tartalmaz, és az
összegek float32-ben pontosan reprezentálhatók.
F4. A hiba oka: a referencia conv2d
aláírásában a groups paraméter vagy hiányzik, vagy
dekoratív, ellenőrzés nélkül. A függvény ezért a teljes
groups=1 úton számol, a hívó viszont grouped súlyt és
csatornakiosztást feltételez; a kimenet a csoportok közötti nem kívánt
keverést is tartalmazza. A következmény: hibás kísérleti eredmény, amely
a tanulás során csak közvetve, például váratlanul nagy kapacitásként
vagy rossz általánosításként jelenik meg. Azonnali teszt: depthwise cél,
,
,
kernel
csupa egyes, bemenet
,
konstans mezőkön. A helyes depthwise kimenet csatornánként
és
;
a hibás teljes konvolúció mindkét kimeneti csatornára
-t
adna, mert mindkét bemeneti csatornát összegzi. Javítás: a függvényben
explicit
if groups != 1:
    raise NotImplementedError("a referencia jelenleg csak groups=1-et tamogat")
ellenőrzés, és grouped teszt esetén a PyTorch Conv2d
mint független kontroll használata. A keretmegállapodás szerint a saját
NumPy-referenciát nem szabad teljes grouped implementációnak
nevezni.
F5. Kérdés: azonos kimeneti csatornaszám mellett a
depthwise separable réteg eléri-e a teljes konvolúció validációs
pontosságát a GlyphLab orientációfeladaton, miközben kevesebb paramétert
használ? Megfigyelési egység: scene_id, mert a két view egy
jelenethez tartozik. Split: a mellékelt, jelenetszintű train/val/test
felosztás, osztályonként
jelenettel. Baseline: ugyanaz a háló egyetlen full
Conv2d(1, C, 3) réteggel, majd globális pooling és lineáris
fej. Változó tényező: a konvolúciós blokk full vagy
depthwise()
+
pointwise()
alakú, azonos
kimeneti csatornaszámmal. Metrika: val accuracy és val loss;
modellválasztás kizárólag val loss alapján, legjobb checkpoint.
Záróteszt a rögzített testen, párosítva a clean/corrupt összevetéshez;
legalább három seed, és a seed-szórás jelenetszintű bootstrap
intervallummal, ahogy a 23.3. Páros összehasonlítás
és csoportszintű intervallum tárgyalja. Lehetséges kimenetelek: ha a
depthwise separable val lossban nem marad el, a korlátozott
csatornakapcsolat ennél a feladatnál elegendő; ha elmarad, a teljes
csatornakeverés szükséges az orientációhoz. Korlát: a
-es
szintetikus adat nem természetes képi benchmark, így az eredmény nem
vihető át más feladatra.
A leggyakoribb tévedés az, hogy a groups értéket csupán
sebességkapcsolónak tekintik. Ez két irányban hibás. A paraméterszám
valóban csökken, de a függvényosztály is szűkül: a fenti depthwise
példában a
bemeneti csatorna semmilyen kernelérték mellett sem hathat a
kimeneti csatornára, mert a mátrix megfelelő blokkja szerkezetileg
zérus. Ez nem optimalizálási, hanem reprezentációs korlát.
A második tévedés a saját NumPy-referencia túlértékelése. Ha a
conv2d referencia groups=1-re íródott, és
valaki groups=2 hívással használja, akkor a függvény vagy
hibát vet, vagy ami rosszabb, csendben teljes konvolúciót számol. Az
utóbbi nem grouped implementáció, hanem hibás hívás. Az ellenőrzés módja
a fenti F4-teszt: olyan input, amelyen a csoportok közötti keverés
jelenléte egyetlen skalárban látszik.
Ellenőrző lista: a súly második dimenziója
,
nem
;
a bias
elemű; a csoportindex az output oldalon
;
a kernel második indexe csoporton belüli, ezért
szerepel; a depthwise esetben
és
.
A labor assert ellenőrzi a súlyalakot és a
paraméterszámot.
Visszahívás 13.4. Határkezelés és frekvenciaintuíció alfejezetből: a határfeltétel a csatornabontástól független; a valid és zero padding ugyanúgy érvényes minden csoporton belül, mert a group csak a csatornák közötti kapcsolatot korlátozza, a térbeli indexelést nem. 10.4. Tanítási lépés és tanuló MLP alfejezetből: a tanítási lépésben a backward a tényleges kapcsolatok mentén folyik; a zérus mátrixblokk miatt egy bemeneti csatorna gradiense a rétegen keresztül csak a saját csoportjának kimeneteitől származhat. 2.4. Kis tudományos szoftverprojekt alfejezetből: a labor explicit konfigurációt, invariáns-ellenőrzést és hibás inputot is tesztel, nem csupán egy API-hívást mutat be.
A groups=g paraméter a be- és kimeneti csatornákat
diszjunkt csoportra osztja; a
-edik
kimeneti csoport csak a
-edik
bemeneti csoportot látja. A súly alakja
,
a paraméterszám
.
Csatorna-major lapításban a lineáris operátor mátrixa blokkdiagonális,
darab
blokkal; ez bizonyított, bias nélkül mondva ki. A depthwise eset
,
a pointwise
-es
réteg térbeli keverés nélkül kever csatornát; kettejük kompozíciója a
depthwise separable réteg. A hibás oszthatóság konstrukciós hibát ad, a
hiba csendes elnyelése pedig hamis grouped eredményhez vezet.
A 15.1. Súly- és biasgradiens egység a konvolúciós backwardban a súly- és biasgradienst vezeti le. A grouped mátrixszerkezet ott gradiensmaszkként jelenik meg: a súlygradiens csak azokra a csatornapárokra nemzérus, amelyek ugyanabba a csoportba tartoznak, a bemeneti gradiens pedig csak a kapcsolt bemeneti csatornákra folyik vissza.