Ez az egység a neurális hálózatok mögötti lineáris algebra első,
geometriai rétegét építi fel. A cél, hogy a vektor ne csak tömb legyen,
hanem koordinátákkal leírható geometriai és adatreprezentációs objektum;
a norma, a skalárszorzat, a távolság és az ortogonalitás pedig
ellenőrizhető, dimenzióhelyes művelet legyen. Előismeret a 2.1. Python, NumPy és tenzoralak
ndarray, shape, axis és
broadcasting fogalma, valamint a 2.4. Kis tudományos
szoftverprojekt kis projektben megszokott input–output
szerződés.
Induló kérdés: a GlyphLab egy 24×24-es szürke képe lapítva egy 576 elemű vektor. Ha két kép két ilyen vektor, mit jelent, hogy „közeliek”, és miért nem elég csak a pontonkénti szorzatösszegüket nézni? Becsülje meg, mekkora lehet egy ilyen képpár euklideszi távolsága, ha minden intenzitás a intervallumban van: a lehető legnagyobb érték, de a tipikus érték az adat tartalmától függ.
Definíció (valós vektor és koordináta). Legyen egész. Az tér egy eleme ; a könyv absztrakt képleteiben ez oszlopvektor. A standard bázisban az valós számok a vektor -edik koordinátái, vagyis , ahol az a vektor, amelynek -edik koordinátája 1, a többi 0.
Két vektor, és , akkor és csak akkor egyenlő, ha minden koordinátára . A koordináták nem abszolút tulajdonságok: más bázisban ugyanahhoz a geometriai vektorhoz más számsor tartozhat. Ebben a fejezetben mindig a standard bázisban dolgozunk; a bázisváltoztatás a későbbi sajátérték-témakörben tér vissza 3.4. Sajátérték, SVD és spektrális határ.
Adatreprezentációs olvasatban egy
lehet egy megfigyelés számszerű jellemzősora. A szerződés szerint egy
tiszta batch-vektor
soronként egy megfigyelést tárol:
.
Egy (1,24,24) NCHW szürke képből az
x = image.reshape(-1) kifejezés (576,) alakú
vektort állít elő; a pixel intenzitásértékei ekkor a vektor koordinátái,
a tengelyek sorrendje pedig a választott lapítási konvenció.
Definíció (skalárszorzat, dot product). Az vektorok skalárszorzata
A kifejezés másik szokásos jelölése , ahol a felső a transzponálást jelöli; ennek mátrixos használata a 3.2. Mátrixszorzás és affín réteg egységben pontosítjuk. Az eredmény skalár, tehát nincs tengelye. Ha batchben dolgozunk, az mátrixok sorainak páronkénti skalárszorzata
ami np.sum(X*Y, axis=1) alakú, (N,)
eredménnyel. A szorzás itt elemenkénti, a redukció a
tengelyen történik.
Az alábbi tulajdonságok közvetlenül a véges összeg definíciójából következnek, ezért külön tétel helyett levezetésként rögzítjük őket. Legyen és .
A pozitív definitség azért döntő, mert ebből lesz a geometriai hossz. A skalárszorzat önmagában nem hasonlósági döntés: az értéke függ a vektorok hosszától is.
Definíció (euklideszi norma). Egy vektor euklideszi normája, más néven -normája:
A nemnegatív gyök egyértelmű; , és pontosan akkor, ha . A norma a vektor origótól mért geometriai hossza. Érvényes a homogenitás: , mert a gyök alatti összeg minden tagja -nel szorzódik.
Általánosabban, esetén az -norma
és . A eset a Manhattan-norma. A háromszög-egyenlőtlenség általános -normákra a Minkowski-egyenlőtlenség következménye; ezt itt nem bizonyítjuk, csak a főúthoz szükséges esetet vezetjük le a következő szakaszban.
Definíció (euklideszi távolság). Az pontok távolsága
A definícióból és a norma tulajdonságaiból azonnal adódik, hogy , pontosan akkor, ha , és . A háromszög-egyenlőtlenséget a következő tétel garantálja.
Definíció (ortogonalitás). Az vektorok ortogonálisak, jelölésben , ha . A nullvektor minden vektorra ortogonális, mert minden szorzatösszeg tagja nulla. Egy vektor egységvektor, ha . Az halmaz ortonormált, ha minden elem egységvektor és páronként ortogonális.
Ha , az vektor egységvektor, az irányába mutat. A normalizálás a nullvektorra nem értelmezhető.
Definíció (koszinusz-hasonlóság). Ha és , akkor
A következő lemma szerint ez mindig a intervallumba esik. A név geometriai: ez a két irány közötti szög koszinusza. Az érték 1, ha a vektorok azonos irányú pozitív skalárszorosai, , ha ellentétes irányúak, és 0, ha ortogonálisak. A koszinusz-hasonlóság nem távolság, mert az azonos irányú, de különböző hosszúságú vektorokra 1, noha a vektorok nem egyenlők.
Az alábbi lemma a valós skalárszorzatra vonatkozó Cauchy–Schwarz-egyenlőtlenség. A bizonyítás standard másodfokú diszkussziós argumentum; nem használ mértékelméletet és nem támaszkodik külső tételre. A terminológia a [B01] lineáris algebrai keretével konzisztens, de a részletes levezetés itt saját kidolgozás.
1. lemma (Cauchy–Schwarz). Legyen , és legyen . Ekkor
Egyenlőség pontosan akkor áll fenn, ha és lineárisan összefüggő, vagyis , , vagy valamelyik a másik skalárszorosa.
Bizonyítás. Ha , akkor mindkét oldal nulla, és az állítás igaz. Legyen most . Minden esetén
ahol az átalakítás a bilinearitás és szimmetria definíciójából következik. Ez -ben másodfokú kifejezés, amelynek főegyütthatója . Mivel a kifejezés soha nem negatív, a másodfokú polinomnak legfeljebb egy valós gyöke lehet, tehát diszkriminánsa nem pozitív:
Osztva 4-gyel és átrendezve . A nemnegatív oldalakon a gyökvonás monoton, így .
Az egyenlőség esete: ha a diszkrimináns nulla, akkor a másodfokú kifejezésnek van valós gyöke, amire , tehát a pozitív definitség miatt , így a két vektor lineárisan összefüggő. Megfordítva, ha és , akkor diszkriminánsa nulla, és az egyenlőség kiszámolható. A esettel együtt ez adja a kimondott feltételt.
2. tétel (háromszög-egyenlőtlenség az euklideszi normára). Legyen , és . Ekkor
Egyenlőség pontosan akkor áll fenn, ha , , vagy valamely valós számra.
Bizonyítás. A norma definícióját kétszer alkalmazva:
Mivel , az 1. lemma szerint
Mindkét oldal nemnegatív, ezért a négyzetgyök monotonitása miatt .
Az egyenlőséghez a fenti egyenlőtlenségek mindegyikében egyenlőség kell. Az 1. lemma egyenlőségi feltétele a lineáris összefüggőség; a feltétel pedig azt kívánja, hogy a skalárszorzat nemnegatív legyen. Ez pontosan az állításban szereplő azonos irányú eset.
A tételből a távolságra is megkapjuk a háromszög-egyenlőtlenséget: tetszőleges esetén
Ezzel az euklideszi távolság a metrikaaxiómákat is teljesíti.
Legyen és . A skalárszorzat:
tehát a két vektor ortogonális. Mindkettő normája , így ortonormált párt alkotnak az és normalizált vektorok. A távolság
A Cauchy-egyenlőtlenség itt , a háromszög-egyenlőtlenség pedig . Ortogonális vektoroknál , mert a kereszttag eltűnik.
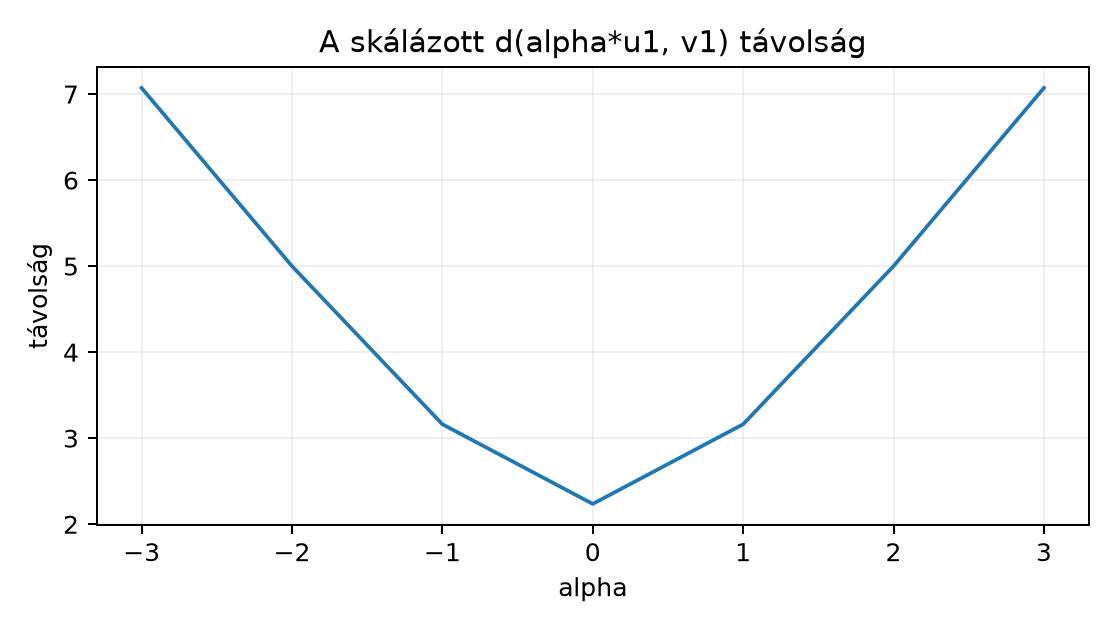
A skálázás hatása ugyanezen a páron: az vektor és skalárszorzata minden -ra, tehát az ortogonalitás minden esetén megmarad (a zérusvektor is ortogonális minden vektorhoz), de esetén a koszinusz-hasonlóság nem értelmezhető. A távolság viszont
ami -nál 5, -nél , és nagy -ra körülbelül ; tehát a távolság általában nem .
A munkakönyvtár labs/n009_vector_norm/. Az alábbi
munkamenet CPU-n fut, a számítás float64 pontosságú,
véletlen számot nem használ. A kimenet kézzel számított ellenőrző érték;
futtatás előtt a pontos numerikus megjelenést a használt NumPy-verzió
határozza meg.
# labs/n009_vector_norm/vector_lab.py
import numpy as np

def dot(x, y):
    return float(np.dot(x, y))

def norm(x):
    return float(np.sqrt(np.dot(x, x)))

def cosine(x, y):
    # a laborpéldákban egyik vektor sem nullvektor
    return dot(x, y) / (norm(x) * norm(y))

x = np.array([3.0, 4.0], dtype=np.float64)
y = np.array([-4.0, 3.0], dtype=np.float64)

print("dot", dot(x, y))
print("norm_x", norm(x), "norm_y", norm(y))
print("cosine", cosine(x, y))
print("distance", norm(x - y))
print("triangle_lhs", norm(x + y), "triangle_rhs", norm(x) + norm(y))
dot 0.0
norm_x 5.0 norm_y 5.0
cosine 0.0
distance 7.0710678118654755
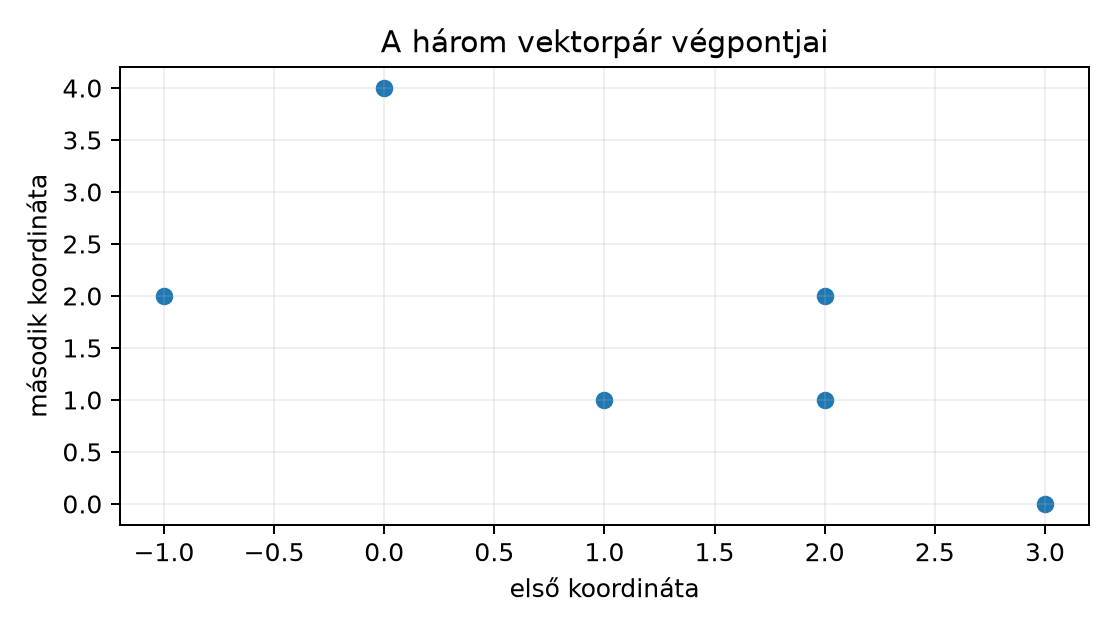
triangle_lhs 7.0710678118654755 triangle_rhs 10.0Átadandó eredmény. Válassza az alábbi három kétdimenziós vektorpárt:
Kézzel számítsa ki mindhárom párra a skalárszorzatot, a két normát, a koszinusz-hasonlóságot és a távolságot. Az ellenőrző indoklás: , mert ; , mert a tengelyvektorokra a szorzat 0; , ezért a pár párhuzamos és azonos irányú.
| pár | skalárszorzat | koszinusz | euklideszi távolság |
|---|---|---|---|
| 0 | 0 | ||
| 0 | 0 | ||
| 4 | 1 |
A kihagyott normák: és normája ; normája 3, normája 4; normája , normája . A harmadik párra a Cauchy-egyenlőtlenség egyenlőséggel teljesül: . A háromszög-egyenlőtlenség is egyenlőséggel teljesül: , míg .
A labor második része a skálázás. Rögzítse , , és vizsgálja az vektort. A skalárszorzat minden -ra, tehát az ortogonalitás esetén megmarad. A koszinusz -ra 0, -ra 0, -ra nem értelmezett. A távolság viszont
A görbe minimuma -nál ; az érték . Ezért a távolság nem mondható meg pusztán a skálázott vektor hosszából, és a „nagyobb hossz közelebb visz” állítás hamis.
A vektorok origóból induló ábrázolásához az alábbi, nem futtatott
laborvázlat használható; a quiver az origóból a végpontba
mutató nyilakat rajzol.
# labs/n009_vector_norm/vector_plot.py
import matplotlib.pyplot as plt
import numpy as np

pairs = [
    (np.array([2.0, 1.0]), np.array([-1.0, 2.0])),
    (np.array([3.0, 0.0]), np.array([0.0, 4.0])),
    (np.array([1.0, 1.0]), np.array([2.0, 2.0])),
]
fig, ax = plt.subplots(figsize=(5, 5))
for u, v in pairs:
    ax.quiver(0, 0, u[0], u[1], angles="xy", scale_units="xy",
              scale=1, color="black")
    ax.quiver(0, 0, v[0], v[1], angles="xy", scale_units="xy",
              scale=1, color="gray")
ax.set_xlim(-2, 4)
ax.set_ylim(-2, 5)
ax.set_aspect("equal")
ax.grid(True)
fig.savefig("vector_pairs.png", dpi=150)
A várt ábrán az első pár két, egymásra merőleges szakasz; a második pár a két tengelyen fekvő szakasz; a harmadik pár két azonos irányú, 1:2 hosszarányú szakasz.
F1 (fogalmi, nehézség 1). Legyen , és . Számítsa ki , , és értékét esetén. Elvárt átadandó eredmény: a négy numerikus érték, valamint egy saját szavas indoklás arról, miért hamis az az állítás, hogy a nagyobb skalárszorzat nagyobb hasonlóságot jelent.
F2 (levezetési/bizonyítási, nehézség 2). Bizonyítsa be a paralelogramma-azonosságot az euklideszi normára: minden esetén . Mutassa meg az , párral, hogy az -normára ugyanez az azonosság nem teljesül. Elvárt átadandó eredmény: a levezetés minden skalárszorzat-felbontással, és a konkrét -ellenőrzés számai.
F3 (implementációs, nehézség 1). Írjon két tiszta
NumPy-függvényt: batched_norm(X) és
batched_cosine(X, Y). Az input
,
dtype float64; a kimenet mindkét esetben (N,)
alakú, dtype float64. A koszinuszfüggvény nulla normájú
sorra nan értéket adjon, és ne adjon ki divisional
warningot. Elvárt átadandó eredmény: a függvénykód, egy
(3,2) tesztbemenet és annak ellenőrzött kimenete.
F4 (hibakeresési, nehézség 2). Az alábbi függvény koszinusz-hasonlóságot ígér:
def cosine_buggy(a, b):
    return np.dot(a, b) / np.linalg.norm(a * b)
Lokalizálja a hibát, mutassa meg egy konkrét számpárral, hogy a kimenet helytelen, és írja be a javított sort. Elvárt átadandó eredmény: a hibás részkifejezés azonosítása, az , pár hibás és helyes értéke, valamint a javított kód.
F5 (kísérleti/transzfer, nehézség 2). Tervezzen egy leíró, nem modellválasztó kísérletet a GlyphLab adatán: az azonos scene két view-jának lapított, 576 elemű vektoraira számított euklideszi távolságokat hasonlítsa össze különböző scene-ek vektorpárjaival. Előfeltétel: 1.3. Adatfelosztás és a megfigyelési egység megfigyelési egység, 2.1. Python, NumPy és tenzoralak lapítás. Elvárt átadandó eredmény: mintavételi egység, párosítási protokoll, baseline, legalább két összefoglaló metrika és a következtetési korlát.
F1 megoldása. A skalárszorzatok: , . A távolságok: , . A skalárszorzat tehát -ra nagyobb, mint -re, de az euklideszi távolság szerint sokkal közelebb van, mint . Az ellentmondás oka, hogy a skalárszorzat a hosszakkal és az iránnyal együtt nő: hossza 10, ezért a nulla skalárszorzat ellenére nagy távolságra van.
F2 megoldása. A norma négyzetét a skalárszorzatra visszavezetve:
A bilinearitással felbontva az első tag , a második . Az összegben a kereszttag kiesik, marad . Ez az azonosság a Cauchy–Schwarz lemmától független, csak a skalárszorzat bilinearitását használja.
Az -ellenőrzés: , esetén és . A bal oldal , a jobb oldal . Az -norma tehát valódi norma, de nem euklideszi indukált norma.
F3 megoldása.
import numpy as np

def batched_norm(X):
    return np.sqrt(np.einsum("ij,ij->i", X, X))

def batched_cosine(X, Y):
    denom = batched_norm(X) * batched_norm(Y)
    num = np.einsum("ij,ij->i", X, Y)
    with np.errstate(divide="ignore", invalid="ignore"):
        return num / denom

X = np.array([[2.0, 1.0],
              [3.0, 0.0],
              [1.0, 1.0]], dtype=np.float64)
Y = np.array([[-1.0, 2.0],
              [0.0, 4.0],
              [2.0, 2.0]], dtype=np.float64)

print("X shape", X.shape, "Y shape", Y.shape)
print("norm", batched_norm(X))
print("cosine", batched_cosine(X, Y))
X shape (3, 2) Y shape (3, 2)
norm [2.23606798 3. 1.41421356]
cosine [0. 0. 1.]Alakellenőrzés: az einsum a
tengelyt húzza össze, így (N,) az eredmény. A nulla soros
inputra a nevező 0, és a np.errstate alatt a hányados
nan lesz.
F4 megoldása. A hiba a nevezőben van:
a * b NumPy-ban elemenkénti szorzat, így
np.linalg.norm(a * b) az
vektor normája, nem pedig
.
Az
,
párra a hibás nevező
,
a számláló 2, tehát a függvény 1-et ad. A helyes érték
.
A javítás:
def cosine_fixed(a, b):
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
F5 megoldásminta. Megfigyelési egység:
scene_id, mert egy jelenet két nézete nem független 1.3. Adatfelosztás és a megfigyelési egység.
Párosítás: mind a 180 azonos jelenetű nézetpárt használjuk; kontrollként
minden jelenet view_0 képét a rákövetkező jelenet
view_0 képével párítjuk, ezzel 180 különböző jelenetű párt
kapunk. Előfeldolgozás: img.reshape(-1) a
(1,24,24) tensorból, float64 számítás, nincs
további skálázás. Metrika: a páronkénti
,
összefoglalásként a két csoport átlaga és a 95. percentilis. Baseline:
az egyszerű azonos–különböző véletlen találati arány önmagában nem
tartalmas; ezért a különböző párok távolságeloszlása a kontroll. Ha az
azonos jelenetű párok átlagos távolsága kisebb, az arra utal, hogy a
jelenetazonosság őriz közös pixelstruktúrát. Korlát: a kísérlet nem
választ modellt, csak leíró; az eredmény függ a nyers
pixelreprezentációtól és a megvilágítási eltolódástól, ezért nem
általános képminőségi állítás.
Gyakori hiba: „a skalárszorzat nagyobb, tehát a két vektor hasonlóbb”. Az F1 ellenpélda ezt cáfolja: és skalárszorzata 2000, és skalárszorzata 0, mégis az utóbbi pár euklideszi távolsága körülbelül 2.0, az előbbié körülbelül 998. A skalárszorzat nyers, hosszfüggő mennyiség. A koszinusz-hasonlóság ezt a hosszhatást kiküszöböli, de a hasonlóság még így sem abszolút: ha és , a koszinusz 1, noha . A komponensenkénti eltérő skálázás ugyancsak megváltoztatja a geometriát: , távolsága , de ha az első koordinátát 100-zal, a másodikat 1-gyel szorozzuk, , távolsága . A választott reprezentáció és mértékegység tehát része a hasonlósági állításnak; ortonormált bázisváltoztatás nélkül a megőrzés nem automatikus.
A 2. tétel bizonyításában a négyzetre emelés megfordítása azért
érvényes, mert mindkét oldal nemnegatív. Az 1. lemmában az
esetet külön kezeltük, mert ott a másodfokú diszkusszió nem
alkalmazható. A batch-számításnál az axis=1 redukció
(N,) eredményt ad; az axis nélküli
np.sum(X*Y) skalárrá összegez, ami nem a soronkénti dot. A
koszinusz csak nemnulla vektorokra definiált; a nullvektoros
normalizálás nan-t vagy hibát ad, és ezt a hívó
szerződésben rögzíteni kell. Ez a pont visszahívja a 2.1. Python, NumPy és tenzoralak alak- és
broadcasting-ellenőrzését: a redukció tengelye a matematikai
indexelésnek felel meg, nem tetszőleges megjelenítési részlet.
A -dimenziós valós vektor standard bázisbeli koordinátákkal adott; a skalárszorzat koordinátánkénti szorzatösszeg. Az euklideszi norma a skalárszorzatból indukált hossz, a távolság a különbségvektor hossza. A Cauchy–Schwarz-egyenlőtlenségből levezett háromszög-egyenlőtlenség a távolság metrikatulajdonságát adja. Az ortogonalitás nulla skalárszorzat; a koszinusz-hasonlóság a hosszakra normalizált irányhasonlóság. A labor három vektorpárt kézzel és NumPy-ban ellenőrzött, és megmutatta, hogy a távolság egy vektor skálázásakor általában nem lineárisan változik. A hasonlóság és távolság a választott bázistól és skálától függ.
A 3.2. Mátrixszorzás és affín réteg mátrixszorzás és affin réteg egység a skalárszorzatot a lineáris réteg építőköveként használja: a súlymátrix minden sora és az bemenet egy-egy skalárszorzatot képez, a bias hozzáadása pedig az affin eltolást adja.